---
/about
---
# About
你好,欢迎来到这里!
[spoiler]如果你是开盒过来的,请遵守盒不扩散条约 🥹[/spoiler]
asica 是一只野生的 CS PhD,方向是 HCI in Health,欢迎来 HCI 的各个 Conference 捕捉。
业余时间会做一些小的开源项目,具体的可以到我的 GitHub 上看看,或者直接在博客上搜索一下相关的文章介绍。
除了工作和学术之外(当然也是除了编程之外),我还喜欢旅行、看番、咖啡、单板滑雪、法甜等,游戏也会玩一些但不多,主要玩 Overwatch、City Skyline。
希望你在这里逛得开心。See you around :)
---
https://zla.pub/2025-annual-summary
---
#2025年度总结
2025 年已经过去了。从逐渐摸清 Master 的生活节奏、开始更细致地做身体健康管理,到一路折腾 PhD 申请。这一整年下来,我确实在很多方面都有了不少成长。当然,也同时被迫做了很多选择,经历了一些曲折和反思。
## 导读
这篇写在 2026 年 2 月。时间很神奇,它会让一些事沉淀成结论,也会让一些当时以为很重要的事看起来没那么重要了。
过去几年的年度总结,我写完再回看时发现我把很大篇幅花在了影视娱乐上,而不是个人成长、学习和生活本身。倒也不是说娱乐不重要,但这确实有点偏离了我写年度总结的初衷。
所以今年我决定换个写法,把重点放在个人成长、学习和生活上,影视娱乐放到最后轻松收尾(并且大幅删减,嗯)。
## 生活
### 运动
#### 单板滑雪
今年新增的模块,其实主要是滑雪 🏂 。
这个事实际上我在本科还在 UCI 的时候就已经多次想过,那会儿身边朋友动不动就去 Big Bear Lake 滑雪,但我一直没有敢迈出第一步。直到来到真正的北方,来到芝伯利亚后终于觉得这是个不错的选择而且敢卖出第一步了。
俗话说得好,双板死的快,单板死的花,于是我选了单板(开个玩笑)。然后在 1 月 3 日在 Kansas City 一上头就买了自己的雪板、雪鞋。雪服之类的其实去年双十一就已经从淘宝买好海运过来了,1 月 4 号直接在 Iowa 上雪。那双雪鞋荣升我最贵的一双鞋 🥹 \$700+。
一开始在 Iowa 的雪场和朋友学了两天,时间基本都花在怎么站起来和怎么推坡这种最基础的技能上(强烈建议第一次上雪之前先看些教学视频,至少知道自己要干啥,不然上去就是纯懵逼)。回到 Evanston 之后就只能自己练,又练了 2 天才学会了基本换刃,但还是没法很好掌控,不过已经很开心了。
因为今年开始得比较晚,也没买季票,雪票成本稍微有点高(Wisconsin 的 Alpine Valley 白天票是 \$78/天)。加上在 Iowa 的那个周末两天,整个雪季一共就滑了 6 天。即使到最后能勉强换刃下蓝道,也还是没法保证下缆车不摔 🥹(而且 Slopes 因为我第一天速度实在太慢了,一分钟都没记录上,于是它坚持认为我只滑了 5 天)。


#### 健身
滑雪让我非常直观地感受到了自己身体机能的虚弱,核心、体能、力量,基本全都不太行。
于是 6 月份开始(别问 3-5 月干啥去了)决定开始一定的~~复健~~健身。一开始为了恢复体能,我选的是慢跑 + 拉伸。暑假回国那一个月并没有太规律,7 月底回到 Evanston 后恢复跑步,也开始加了一些力量训练和拉伸。
力量训练以上肢为主,从一开始单手 2.5 lbs 加到 10 月份单手 5 lbs,然后就涨不动了(太沉了...)。10 月之后有一段时间的 burnout(具体我会放在 [健康](#健康) 章节写),然后健身就也跟着停摆……嗯。
### 食
今年总体来说更舍得在吃上花钱了。通过吃获得多巴胺的性价比,确实挺高的(对我来说)。
这里就简单写一下我在常驻地 Evanston / 芝加哥吃过的一些印象比较深的餐厅。
#### 芝加哥餐厅周 2025
年初在室友酱 YL 的告知下得知了 Chicago Restaurant Week 的存在,于是趁机订了两家芝加哥的米其林一星 Moody Tongue 和 Galit。可以说是有惊喜,也有失望。
Moody Tongue 的菜品和氛围都非常棒。作为一家曾经的米二,即使现在是米一也没有让我失望,从鹅肝到主菜牛排都很出色,对得起餐厅周加小费和税后大概 \$80 左右的价格。

然后就该批评 Galit 了。我很支持提供纯素选项,但这不代表你一家本身不是纯素餐厅的餐厅,在餐厅周就只提供纯素选项吧?更不代表纯素就可以做得不好吃吧?
虽然在 Resy 网络内(还用掉了 Amex Gold 半年 \$50 的 credit),但整体体验真的很一般。菜品没什么亮点,甚至有些我觉得还不如我自己在家做的好吃……

#### Evanston 探店
今年吃了非常多家 Evanston 以及附近的餐厅,但真正让我留下深刻印象、并且有过二刷的其实不多。我这里推荐几家不是中餐的:
首先是 Evanston Downtown 的西班牙小酒馆 Hestia Tapas。氛围很好,装修也很有特色,而且非常火爆,建议提前订位。菜品方面我个人觉得很不错,披萨、海鲜饭、小吃都试过不少。价格不算贵,人均大概 \$20 左右。

然后是 Morton Grove 的 Mazalae,一家蒙古菜餐厅,确实是蒙古人开的。女老板人非常好,味道也很正宗。蒙古奶茶、牛肉包子、牛肉炒饼、羊汤……应该已经三刷还是四刷了。非常好吃还非常便宜,人均也就十几刀。

最后是更远一点,在 Jefferson Park 的波兰菜 Smakosz。芝加哥有全美最大的波兰裔社区之一,虽然我没去过波兰,但这家店真的非常合我口味。炸猪排、炸肘子都很好吃,价格也不算贵,人均二十几刀。

### 住
今年全年在外面住了 21 晚,跨越 4 个国家和 3 个酒店集团。绝大多数是积分或者免费晚(Free Night)换的,只有少部分是自己付费。
暑假回国的时候又去住了上海中山公园的 **Caption by Hyatt**,房卡终于换成了木质的;回美国路上去大阪,也住了大阪新开的 **Caption by Hyatt**。虽然是同一个品牌,但每一家的房卡都做了独立设计,这点我还挺喜欢的,满足我的收集癖。


#### 纽约康莱德(Conrad New York Downtown)
3 月份住了纽约康莱德(Conrad New York Downtown),用 Aspire 的 FN 换了一晚。当晚现金价不算高,大概 \$500 左右。
当然我更想住纽约华尔道夫,但它一直在装修,要到 9 月才重新开业,这次就没撞上。康莱德的位置还可以,在世贸中心对面不远,但酒店整体设施给我的感觉并没有很新,也谈不上很豪华。
水钻在美国显然不太受待见,没给高楼层,也没给哈德逊河景。房间里不配瓶装水,但送了两个可重复使用的水瓶,房间自带净水机可以自己装水喝(但送都送了,能不能给个质量稍微好点的水瓶呢?)。
晚上回来房间里准备了果盘(香蕉、葡萄、苹果)、一瓶 Acqua Panna 和一瓶 Perrier,还很有仪式感地配了两只高脚杯。早餐当然也没有免费,每个人每天有 \$25 的餐饮额度可以在酒店内使用。总体来说中规中矩,毕竟美国的酒店确实不能指望太多。
在康莱德住完一晚后,我非常挂壁地跑去了隔壁州住 Hyatt Regency(C4,FN 换的),每天坐 PATH 跨州玩,但省钱。

#### 巴拿马华尔道夫(Waldorf Astoria Panama)
12 月去巴拿马玩,用 AMEX 的 FHR 订了 4 晚巴拿马华尔道夫(Waldorf Astoria Panama)。
这家酒店地理位置很好,附近很安全,价格也很便宜,平均一晚大概 \$180。用了两张 AMEX Plat 的 \$300 额度以后,差不多只需要 \$30/晚,是我这辈子住过的最便宜的华尔道夫了。
酒店设施和服务中规中矩,巴拿马的华尔道夫对比其他国家确实差一些,但至少对得起价格。早餐配置比美国好太多,每天早上都有新鲜水果,木瓜和百香果这下真吃了个够。夜床服务也很朴实无华,只有一块巧克力。
每一家华尔道夫都有的孔雀廊(Peacock Alley)当然也不能错过。但这里的 Peacock Alley 也太小了,进门右手边一眼望到底(真的,一眼)。

### 行
#### 飞行
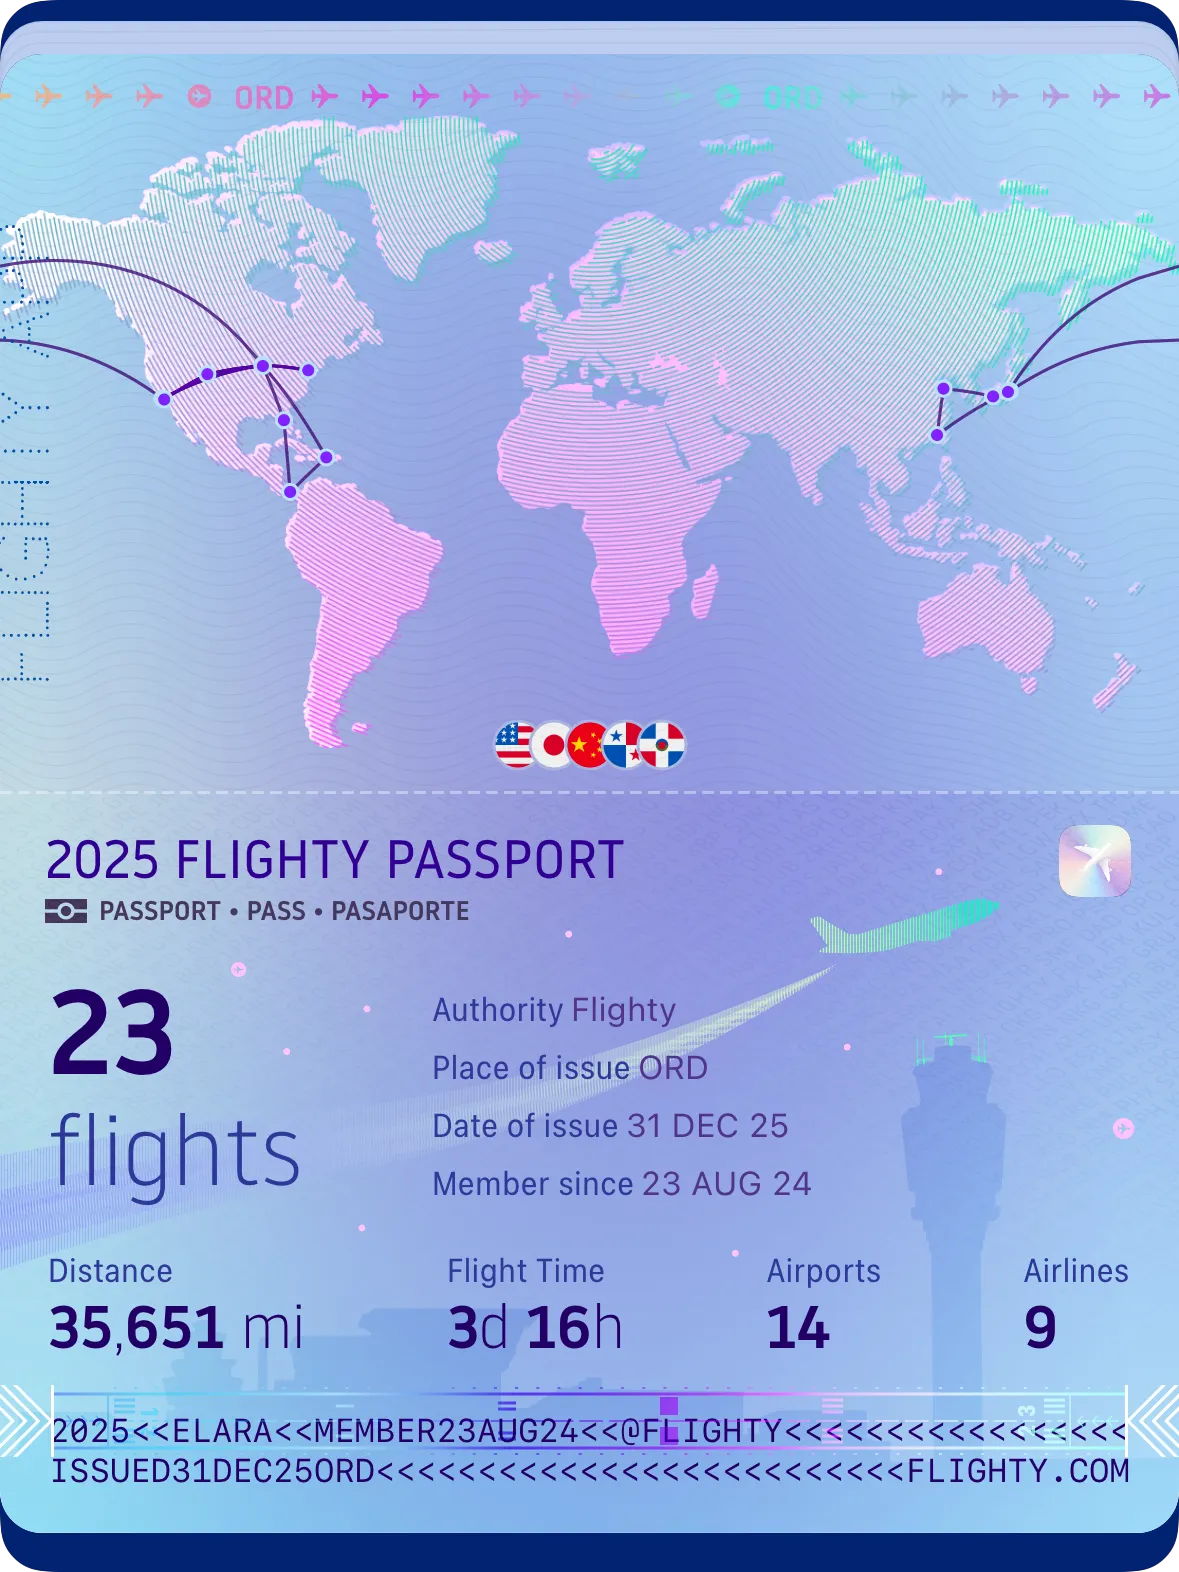
今年飞得不算少,一共 23 段,累计 57,592 公里,14 个机场,5 个国家,顺便解锁了中美洲和加勒比海国家的新地图。
主要贡献当然还是芝加哥往返尔湾,今年往返了 3 次(2 月、4 月、9 月),依旧是为了牙套。9 月那次我直接上头买了 Frontier 的 GoWild 随心飞,\$30 的机票当天打了个往返,真的字面意义上的8 小时都在飞。除此之外还回了一趟国,去了巴拿马,也去了两次纽约。
体验上今年也算解锁了两个新东西:
- 第一次坐洲际超级经济舱(啊对对对我玩卡这么多年终于舍得坐不是牛仓的仓位了),成田到洛杉矶 UA 787-9(评测我已经写在小红书了)。
- 第一次坐能躺平的商务舱,虽然只是 737 Max 9,但巴拿马航空 巴拿马到蓬塔卡纳 那段确实全躺平了(细节在[巴拿马游记](https://zla.pub/2025-panama-trip)里)。

#### 车
今年车确实开得少了很多很多。上半年我甚至一直没买停车票,直到下半年才开始买。
就算年初去了一次 Kansas City、年末去了北密歇根、雪季平时还多次跑威斯康星滑雪,一年的总里程也只有 6600 英里(约 10,600 公里)。一共烧了 212 加仑油(大概 800 升)。当然回 Irvine 的时候一天随便就能开出 100 mile,但毕竟是租车,只需要交油钱就行了。
全年油费大概 \$860。8 月车胎扎了一次,着急补胎 \$45。一个后门的漆面因为历史遗留问题重新喷漆花了 \$1200。年底换了一次轮胎大概 \$1200。保险因为一直是半险 + comprehensive,总计大概 \$780。
#### 旅行
旅行在今年的比重也不算小。先按时间顺序做个索引:
1. 1 月:自驾经 Springfield、St. Louis 到 Kansas City 找朋友玩两天,然后一起去 Iowa 滑雪。
2. 3 月:纽约 5 天游。
3. 6 月初:纽约办事 + 顺便逛联合国;月底回国,东京转机快速入境吃吃喝喝。
4. 7 月:国内无锡 / 苏州 / 上海(BW);月底回美国路上去大阪和京都玩 4 天,再转机回美。
5. 10 月:北密看枫叶,回程顺路 Milwaukee 一日游。
6. 12 月:巴拿马 5 天游(游记单独写了)。
##### Kansas City
开年第一天,我就开车上路,直奔美国唯一一个跨州的城市,Kansas City。为了让路上别太无聊,我还特意绕远走了一条观光路线。途径伊利诺伊首府 Springfield、再去密苏里最大的城市 St. Louis,然后一路向西。
一路天气很好、路况也不错。路上看了多处 Route 66 的标志、伊利诺伊州议会、林肯故居。到了密苏里还专门去了全美最小的国家公园之一,Gateway Arch 国家公园。虽然当天放假上不去,但在下面拍照也挺值的挺好看的。
来 Kansas City 当然是为了找朋友一起去 Iowa 滑雪,但我没第一时间去滑雪的更重要原因,是这个博物馆,纳尔逊-阿特金斯艺术博物馆(Nelson-Atkins Museum of Art)。
这里有非常多来自中国的文物。中国庙宇展厅正中端坐着的水月观音(辽或金代),背后是来自山西洪洞广胜下寺的元代壁画。除此之外也有不少印象派大师,我最爱的莫奈(有一幅睡莲)、以及基约曼、梵高、秀拉等等。


#### 纽约
来美国 5 年,这是我第一次来纽约(以前真的一次都没来过)。事实证明纽约比我想象中好玩很多,是我在美国去过的城市里为数不多觉得可以多次再来的地方之一。
这次行程确实有点打卡属性,911 遗址、大松果、华尔街铜牛、小小岛、自由女神……都去了。但我花最多时间的还是博物馆,大都会(The Met)和 MoMA。小时候在课本上见过的画突然出现在眼前,这种感觉很奇妙,也很震撼。


然后就到了完完全全意料之外的事。
我们计划回芝加哥那天上午,本来要去看自由女神像和爱丽丝岛的移民博物馆,但线上预约的船票时间我们错过了。门口一个看起来像工作人员的人说可以现场买票,然后我这个小傻子想都没想就付钱了,付完他让我们往另一个方向走去坐车,我才意识到被骗了。后来找银行 dispute 了,没有实际损失,但我真的服了(后来在小红书上才知道这很常见,纽约景点门口这种套路也太成熟了)。
好,骗完钱还没结束。
我们从游客中心顺利买到正规票准备上船。因为我本身晕船,就提前吃了晕船药(苯海拉明)。然后我看错了说明书,把“一天最多 6 片”看成了“每次最多 6 片”……嗯。
船到自由女神像脚下我开始头晕犯困,还以为是正常晕船 + 药物副作用。到爱丽丝岛下船以后,我已经困到要晕睡过去、浑身乏力,但还是被朋友扶着进了博物馆。参观到一半我彻底不行了,这才反应过来是不是吃多了?拿出药一看,果然剂量看错了。
我当时赶紧问 GPT 怎么办,它直接建议立刻去医院,跟我说这是紧急情况,不要思考任何其他事。我已经出现很强的剥离感和头晕乏力,就想着先催吐看看能不能吐出来,于是去卫生间催吐。确实稍微清醒了一点,但也吐不出什么东西。出来后我基本站不住了,只能让朋友扶着去找工作人员求助。
一开始工作人员还觉得我们插队让我们去排队,说了 medical emergency 才发现我出事了。工作人员找来了博物馆医务人员,把我带到办公室做常规生命体征检查。结果发现我的瞳孔开始失去对光反应,并且明显神志不清,他们立刻打了 911 叫救护车。救护车来的同时还来了警察,显然怀疑我故意 overdose(朋友,我真的只是蠢)。
我被急救人员推到救护车旁转移到担架上。去医院的路上我几乎没什么意识。到医院做了一些检查后我就躺在急诊室里昏睡过去。大概过了一个多小时,大脑慢慢恢复了一点意识。这时候护士拿着静脉输液过来,我第一反应是完了,我钱包要遭不住了……而且再晚就赶不上我们订的回芝加哥航班了。于是我跟护士说我想出院。护士和医生沟通后同意了,但让我签了一份免责协议。
之后的路,去机场、飞机上、下飞机回家的路上、到家后,我基本都在昏睡。甚至后面几天都没有彻底恢复。现在想想,当时不该在乎钱,应该直接留院观察的,毕竟生命安全最重要。
最后账单其实没有我想象中离谱,保险报销完以后救护车 \$130、医院急诊 \$670 左右,总共大概自费 \$800。

6 月初因为一些事情我又去了纽约一趟,安排当天去第二天回。办完事以后正好在联合国总部附近,就顺便参观了一下联合国。恰好碰到一个公开的各国文化宣传展,很多国家摆摊卖吃的,也有卖纪念品的,挺有趣。
秉持着来都来了的原则,我还报了联合国的付费导览(有学生优惠),参观了各个委员会会议室和议事大厅。平常只能在新闻和网络里看到的场景突然变成了我站在这儿,那种感觉还挺奇妙的,也顺便了解了一些联合国的运作方式和历史。

#### 东京 & 大阪
6 月底暑假回国时,我打算再去日本玩,于是在芝加哥领馆用 \$5 拿到了两次过境签(教程我在小红书写过,可以直接搜”芝加哥 日本 过境签“)。回国那趟在东京其实几乎就是转机,停留时间满打满算只有 5 个多小时,而且还得从羽田转去成田。
坐了十几个小时芝加哥凌晨起飞到日本还是凌晨的航班后,我已经饥肠辘辘,于是坐上京急线的首班车直奔银座,寄存行李后去筑地市场胡吃海喝,短暂停留但还是很沉迷。

7 月底从国内回芝加哥,我决定认真利用一下过境签的停留时间。旺季直飞回美国太贵了,于是用 Chase UR 转 UA 里程订了成田飞洛杉矶的超级经济舱,再转机回芝加哥。于是安排了一个关西 4 日游,住大阪,在大阪玩两天,京都玩一天,最后一天一早飞东京回美国。
大阪和京都行程都很充实,大阪城、道顿堀、心斋桥、梅田;京都的伏见稻荷大社、清水寺、鸭川、锦市场等等。上次来关西可能还是 15 年前,记忆几乎清零。变成重度二次元、又了解了更多日本历史之后再来一次,意义确实完全不一样。之后还会多次再来关西的。


#### 无锡、苏州、上海
暑假回国我待了大概 3 周多。也不知道脑子是不是有点大病,跑去无锡和苏州这种 40 多度的地方玩了几天。在无锡面基了一下白鲸字幕组压制组的小组长越泽(认识这么多年了第一次线下见面)。强烈建议别在这种温度去江南,会出人命(真的)。
上海当然就是 BW。以及今年还多了浦东美术馆的奥赛特展(再加上刚好有从芝加哥来出差的),体感就是直接在上海上演了一遍西方艺术史。
但今年是第一次一个人逛 BW 🥲,确实有点孤单。依旧去了去年那家面包店,去了乔治队长线下店一口气喝了三杯。今年也又去吃了人和馆,一个人,“舍得”这次没舍得下去(感觉自己有点老了),给退掉了,但鳝丝还是好吃的。


#### 北密歇根 & Milwaukee
室友酱 Vicky 一直想去北密看枫叶,我也早就听说那里很好看。虽然今年秋天雨水比较大,我怀疑枫叶留存率不会太好,再加上冬天来得相对晚,能看的窗口可能也不长,但还是决定去看一眼。
于是 10 月挑了一个周末自驾北上。我们直接一口气开到了 Porcupine Mountains State Park,当天看完枫叶就返回威斯康星的 Green Bay(省住宿费,比较挂壁)。第二天回 Evanston 的路上顺便去了一趟威斯康星最大城市 Milwaukee,快速一日游,第三病区(Third Ward)、Public Market,也路过了密尔沃基艺术博物馆(Milwaukee Art Museum)。


#### 巴拿马
巴拿马我单独写了游记,这里就不展开了,可以直接去看这篇文章哦:[巴拿马:一个被运河改写命运的国家](https://zla.pub/2025-panama-trip)
### 健康
> 不构成医疗建议,请咨询专业医疗人员。
今年我把健康单独拎出来写,主要有两个原因。
第一个是随着年龄增加,再加上身边人的身体状况、以及家族遗传风险的存在,我开始很直观地感觉到身体机能不是永远稳定的默认值,它是会往下掉的,而且掉的时候你不一定能提前收到通知。你可以不在乎,但它会用更贵的方式让你在乎。
第二个是工作量和学业压力的增加,让心理压力变得更常驻。以前焦虑可能是阶段性的,今年更多时候是背景噪音。它不一定每天都把你按在地上摩擦,但它会把你的精力一点点抽走,最后你突然发现怎么我什么都没做,但已经累到不行了?
#### 身体(Physical)
正如前面写运动那部分说过的,我开始增加一些锻炼来提升心肺功能和基础力量(滑雪把我虐得很诚实,核心、体能、力量,三项全不行)。在作息上也开始刻意调整,尽量做到 23:30 前睡觉、每晚睡够 7 个半小时,这件事听起来很简单,但当你同时在做 research、写申请、还要处理各种琐事的时候,它其实是需要主动保护的。
饮食方面我今年也明显更认真了一点,开始更有意识地做升糖控制和抗炎饮食:
- 减少精制糖和高升糖碳水(尤其是甜但你以为自己没吃甜的那种)
- 增加蔬菜和优质蛋白(并且尽量先吃菜/蛋白再吃主食)
- 尽量把吃饭从纯多巴胺变成吃完不会后悔的多巴胺(当然偶尔还是会放飞,即使放飞也尽量做到我能做到的)
今年还尝试了两个新的东西,一个是低温慢煮机,一个是动态血糖仪(CGM)。
低温慢煮机是白嫖的(感谢某位 A 姓人士),之前我大多数为了调整饮食所使用的方式基本上就是烤箱,烤箱会导致食物变干、肉变柴一些,对于蔬菜还可以。而且烤箱需要一直盯着看,翻动一下之类的。而低温慢煮机就可以提供一种方式,让鸡胸比鸡腿还嫩,让牛排羊排也不会干柴,汁水充盈。而且打开放那就不用管了,就可以吃到好吃的肉了!
另一个就是动态血糖仪(CGM),这个东西对我最大的价值就是让我知道我的这些计划和实际实施的策略到底是什么样的效果,一直以来的饮食结构对我的血糖到底有何影响。但这个东西一定要注意过敏性体质对于这个胶可能会出现过敏反应,我在佩戴的第五六天的时候开始出现稍微的瘙痒状况,在 14 天后摘下来以后佩戴的区有明显的泛红。如果有也想要使用的可以注意一下这些情况。
结果是可见的,我的 A1C 从去年(2024 年 9 月)的 5.5 降到了今年(2025 年 12 月)的 5.1,属于是非常明显的改善,也让我在二型糖尿病前期风险这件事上稍微松了一口气。之前偏低的钾(4.0 以下)也回到了正常范围(4.2–4.3 左右)。总体来说身体状况确实有变好,至少在数据层面我不是在自我感动。
当然,数据好看不等于我就从此无敌了。今年依旧出现过那种我以为我撑得住,结果身体告诉我不行的时刻,只是相比以前,我更愿意把它当成系统问题去修,而且有了一套自己的方法和结构。
#### 心理(Mental)
心理健康方面,年初我终于下定决心去找 Psychiatrist 做了 ADHD 的诊断和治疗,并开始了非兴奋剂类药物(安非他酮 Wellbutrin)。体感上,注意力确实有所改善,更容易把注意力拉回到当下,也降低了 Hyper Focus 失控的风险。同时没有明显能感知到的副作用,这点对我来说非常重要。
但问题是,药物可以帮你把方向盘扶稳一点,不会帮你把路上的坑填平。上半年我并没有增加 Therapy 的频率,直到下半年才开始每两周一次的 Therapy。然后我还是没能避免,给自己接了太多 project,再叠加 PhD 申请压力,最终把自己送进了 burnout。
10 月中旬到 11 月上旬这将近一个月,我基本处于一种非常低迷的状态:
- 不是休息一下就好的那种累
- 是那种醒来就觉得世界没有意义、做任何事都像在推石头的状态
- 最可怕的是你脑子知道事情很重要,但身体就是不给你动
好消息是,最后还是挺过来了(虽然过程很难顶)。更重要的是,我从这次经历里总结了一些对 2026 更有用的结论:
- 我不是不能做很多事,我是不能同时 lead 很多事。
- 低迷不是意志力不足,很多时候是长期透支后的保护机制。
- 预防比恢复便宜太多,如果等到彻底崩再救,成本会指数级增加。
我也在积极和 Therapist 沟通,把怎么预防下一次不可控这件事变成更具体的策略,而不是一句空话。2026 的目标不是永远不崩,而是崩之前我能看见,能刹车。
## 学业与研究
今年应该是我 research skill 增长最大的一年。对比 2024 年那种非常天真的 research 视角,很感谢导师们逼我去思考 research 本身,它到底是什么?我为什么要做?以及我到底要不要读 PhD、又为什么要读。
今年我最重要的变化其实不是/不仅是我学会了更多方法,而是我开始更认真地面对三个问题:
1. 什么才算一个值得做的问题(而不是单纯看起来很酷)?
2. 我到底在为谁做研究、希望带来什么影响?
3. 我能不能把系统建出来、评估做实、然后把论证写清楚?
4. 方法到底是什么?读者能不能通过我的文本描述理解我的思路并且加以复现?
更具体的 research 相关内容我就不在这里展开了,感兴趣可以直接去看我的学术网站 [elaraliu.com](https://elaraliu.com)。
### 关键里程碑
今年我最多的时候同时在做 4 个 project,其中 2 个是我 lead,1 个 co-lead。这里我必须郑重给未来的自己留一句话(也顺便给路过的朋友们一个血泪教训)强烈建议同一时间不要 lead 超过 2 个项目,最好不要超过 1 个。否则下一步就是 burnout,最不济也是效率断崖式下跌。除非你真的觉得自己可以在一个 research 里深度 focus 几小时后,立刻丝滑切换到另一个 research(我确实不行)。
因为众所周知的原因,这里不能展开太多项目细节。简单说,今年我从年初开始做 IMU HAR 和原本的 experiential differences computing,中间还有和 UW 的 LLM agents 合作,到年底推进 systematic review。
今年没有成功提交任何 paper(发文章哪有那么容易.jpg),但 experiential computing 在年底推进到能在 2026 年 1 月提交 ICWSM,也算是一点对自己的鼓励吧。
方向上,我的兴趣也逐渐更集中到 LLM 相关研究,更关心怎么让 LLM 对更多人真的可用,以及在医疗健康领域里它的可能性和风险。简单来说就是我不想只做模型很强、分数更高、效果看起来更厉害,而是想做系统真的能被人安全使用。
### 开源项目
开源这部分说多不多,说少也不少。
今年我继续维护 SuzuBlog 作为长期项目。在 PhD 申请的推动下优化并开源了学术站模板 [EnjuFolio](https://enju.zla.app),把 Airtable 官方在 JS 环境下的 SDK 做了一次重构,形成了 [Airtable TS](https://airtable.zla.app);另外还花时间写了一个基于 Cloudflare 的 Gravatar 图床 [Gravatar Worker](https://gravatar.zla.app)。
一个全栈项目、一个 SDK、一个特定场景下的解决方案,总之我对这些成果都还挺满意的。希望也能帮助到大家的使用场景(欢迎提 issue 和 PR 我会尽快回复)。
## 财务与资源配置
今年对比去年的最大变化就是我没有 W2 了(也就是没有任何工资收入)。所以今年的收入结构基本变成了两类,羊毛类的返现/返点、平台活动,和开户奖励类的信用卡开卡奖励、checking 之类的开户奖励。
### 收入
#### 信用卡
首先,开年迎来的就是 5/24 出狱。2024 年我基本没开什么卡,就是为了等这一刻。然后 2025 年的主线任务就开始了,2 月开了 Hyatt、5 月顺着 Rakuten 的活动开了 CFU(开 Chase 返 MR)、9 月份拿了 IHG 的史高。
因为 Chase 我暂时没有什么非开不可的卡了,于是就开始往外扩展。9 月 IHG 开完没多久我就直接 MDD 了 Barclays 的 Hawaiian(\$2.5k 给 80K Atmos)和红飞(刷一笔不限金额给 50K AA)。歇了一段时间以后终于决定碰 Amex 白金,但我实在不敢碰普白的 AHA,于是选了 CS 白金的稳定 125k 史高。接着趁 Rakuten 新卡史高又补了一张(\$2k 给 20K MR)。年底则是上头开了 200k 的商金和 US Bank Cash+(并且 US Bank 又又又给了我羞辱性的 \$500 额度)。
整体算下来,这部分的收入已经非常可观。虽然大多数是酒店点数/航司里程,但它们基本都能转化成我本来就要用的旅行和住宿,所以我自己觉得不算太刺激消费。
唯一的问题是 Amex 白金的 coupon book 真的很麻烦,心智成本非常高(尤其是半死不活的 Equinox 这样的)。

#### Checking 开户奖励
另一个部分是 checking 开户奖励。今年主要是从年底才开始认真做,一方面年初确实没精力把心智分给这块,另一方面 2024 年 53 没薅到还浪费了不少时间这件事对我心智消耗还是有一些的。
下面这个表我就留作记录,仅供参考。总计 \$3000 出头(只算 2025 年到账的部分;有些奖励是 2026 年才到账的,我也标了)。
| 银行 | 开户时间 | 要求 | 奖励 | 奖励到账时间 |
| ----------------- | -------- | ----------------------------------------- | --------------------------------------- | ------------ |
| Wells Fargo | 1 月 | 3 个月内 1k+ DD | \$300 | 5 月 |
| Old National Bank | 9 月 | 3 个月内 3.5k+ DD | \$650 | 2026 年 2 月 |
| CIBC USA | 10 月 | 1 笔 ACH(无金额要求) | \$200 | 12 月 31 日 |
| Citi | 10 月 | 2 笔 EDD,总共 6k+ | \$425 | 2026 年 1 月 |
| Bask Bank | 11 月 | 3 个月日均 1.5k+,每个月刷 5 笔总和 \$50+ | \$300(分 3 个月给) | 每个月底 |
| US Bank | 11 月 | 2+DD,总额 6k+ | \$450 | 12 月 |
| Kraken | 12 月 | 交易 \$200 non-stable | \$75 + \$150 (Rakuten) | 12 月 |
| Sofi | 12 月 | 2DD, 5k+, 2DD 之间 gap 小于 25 天 | \$25(refer)+ \$300 + \$400(Rakuten) | 12 月 |
PS:checking bonus 最大的坑其实不是钱,也不是 fake dd 而是流程管理。你只要漏一次 DD、卡一次时间窗口、或者忘了关账户,就可能会被反薅。
### 支出
今年的支出结构整体没有太大变化,如下图所示。简单解释一下每个大类都到底是谁在花钱(我的描述顺序是从占比最大的开始顺时针转):
- 深蓝色:房租、租房保险、家具等(占比最大,约 45\%)
- 购物:雪具/雪票、衣服、软件、域名、服务器等。今年雪具确实贡献了不小的比例。
- 买菜(约 10\%):随着我更认真搞健康饮食,蔬果、蛋白、一些看起来就很健康但也很贵的东西明显变多了。
- 车 & 出行(接近 10\%):下半年后门漆面重做(历史遗留问题)、年底换轮胎、油钱、车险、停车费、公共交通、registration、收费高速等。
- 饮食(约 7\%):出去吃饭、快餐(比如麦麦)、咖啡/奶茶等饮品。
- 旅行:机票、酒店、租车等
- 年费/服务费:信用卡年费、各种服务费
- 医疗:大头当然是那一次急诊……
- 杂项:话费、电费(\$300 出头)、礼物、娱乐(门票/电影/博物馆等)

### 大额支出 Top 3
#### Top 1:雪具
今年最大的支出当然是买雪具,一次性 \$800+,买了雪鞋、雪板、固定器。雪鞋直接成为我最贵的一双鞋。
我个人觉得这笔钱还是蛮值的,如果你想长期滑雪,租雪具的时间成本、适配成本、以及每次都要重新适应的精神内耗都很浪费。雪服和护具这些我从国内买的,加起来也有 \$400 左右,而且这部分更重要(衣服因为没法租。头盔保命的,我也不敢租)。有自己喜欢的装备确实会显著增加滑雪兴趣,也会提升快乐。
综合下来雪具大概 \$1200,再加上雪票就更多了。
#### Top 2:Jellycat
第二大开支是 Jellycat,今年差不多花了 \$350+。虽然不是一次性开销,但确实是反复开销在同一家同类产品上。
但这个真的没法怪我,宝宝们太可爱了我也没办法呜呜。情绪价值性价比非常高,而且可以陪我很久,我认为非常值得(至少它比很多冲动消费更像长期资产,长久陪伴)。
#### Top 3:AirPods Pro 3
第三大我其实有点纠结,衣服占了不少、旅行也花了不少。但如果按单笔上头来算,那就是 AirPods Pro 3,到手价 \$131.71。
原因很简单,当时 Amazon 打折 + 我某张 Amex 上有两个 Amazon offer 可以叠加,我里外一合计觉得这便宜得跟不要钱一样,就一下没忍住买了。
然后直到今天(2026 年 2 月)它还没拆封。我依旧在用 Pro 2。所以这笔消费的本质其实是我为占到便宜的快乐付费了(至少目前是这样,我今年应该会用,可以看 2026 年度总结了)。
### 投资与储蓄
> 以下不构成任何投资建议,市场有风险,入市需谨慎。
正如之前说的,我通过各种方式赚到的钱,最后基本都会以各种方式流回股市或其它资产里。这里我分三块写,保险、储蓄、投资。
#### 保险
我把保险放在第一个说,是因为今年我对风险的体感变强了,你挣得再多,天灾人祸也可以用一种非常随机的方式,让你的收益归零甚至产生债务。
今年年初人生第一次救护车 + 美国急诊,直接把我的风险感知变成了现实。年底去北密的时候,又亲眼看到鹿从我高速前进的车前跑过去以及路边撞死的鹿这种画面感极强的提醒。再加上我让 GPT 帮我算了一下风险收益模型,我最终决定提高车险保额。
我把年初的配置:
- 25k / 50k / 25k
- 无 collision
- comprehensive deductible = 1k
提升到了:
- 250k / 500k / 250k
- collision deductible = 2k
- comprehensive deductible = 250
这里三组数字分别是人身责任险(单人 / 单次)以及财产损失责任险。保费主要因为加了 collision 直接翻了一倍多一点,但从长期看我觉得值得,尤其考虑到路上有多少车根本没保险,万一我被撞了对方赔不起,那我至少要能把自己兜住。
#### 储蓄
储蓄部分我持相对简单的配置。我从 2023 年底开始的主力活期是 Apple Savings,但到 2025 年末它利率已经降到 3.65%,并且它对我的风控越来越严,使用上出现一些不便(每次转钱稍微大额一点就打电话过来要求 3 方核验,你就听着高盛客服和另外一家银行客服把你的个人信息念一遍核对一遍,太麻烦了)。所以我换到了另一家利率差不多但风控相对友好的小银行。
我对储蓄的观点也还算明确,只放应急资金和未来一年明确要用的大块的钱。未来 3–5 年甚至更久都不会用到的钱,放在活期里我会觉得太可惜,长线复利的力量不容小觑(尤其是当你终于不用交那种离谱的税的时候)。
#### 投资
2022 年我买入了一些 AAPL、GOOGL、AMZN、MSFT、SPYM,然后基本一直持有到 2025 年底。接近四年下来,整个账户总收益 97.24%,平均年化 20.63\%。对比同期标普 500 的 18.74\% 略胜,对比同期纳指略输。当然不可否认,过去几年 AI 叙事是主要市场驱动力之一。但同样也不能低估长持 + 复利 + 少折腾,本身就能带来非常可观的结果。
今年其它角度里我觉得最有趣的是黄金,我从 2023 年开始在国内布局的一部分黄金,今年一年涨了 40\%+。还有 2023 年布局的新能源,虽然跌了很长一段时间,但我一直定投加仓把成本拉低,最后赚了 35\% 左右选择清仓。清仓不是对新能源失去信心,主要是管理复杂度、国内交易服务费、以及对 A 股整体风险的规避。
从 2025 年底开始,我的投资模型出现了一个明显转折,因为从 2026 年开始我的税务身份会转成 RA,不用再考虑卖出 30\% 的资本利得税和 10\% 的分红税。税制变化会直接改变策略空间,于是我开始做更长线、更低维护的配置,大致配置为 VOO + VXUS + BND + 少量个股,比例如下:
- 50\% VOO
- 15\% VXUS
- 5\% BND
- 5\% GLDM
- 个股合计 10\%(包括 3\% BTC、2\% VHT,以及一些其他个股)
- 现金仓位 15\%(防黑天鹅,留补仓弹药)
主要是目前本金不够大的情况下没必要搞什么骚操作,赚也就是几百最多几千,亏也就是这个数,不如降低管理复杂度让时间展现价值。

## 影音、阅读、娱乐
终于到了往年我最容易写嗨、然后不小心把年度总结写成年度片单/番剧杂谈的部分。今年我故意把它挪到最后,当一个比较轻松的收尾。今年我看过的东西其实不少,但我还是按老规矩,只挑我觉得最值得单独拿出来说的,电影(3 部)、番剧(3 部)、书(3 本)。咖啡这块没什么变化,手冲已经彻底变成了日常。电子产品方面,今年最离谱的成就大概是买了 AirPods Pro 3,然后一直没拆封(到今天都还在用 Pro 2)。
### 电影
今年的电影说实话不算很少,从开年的《唐探 1900》、《我的世界大电影》,到成龙的新作《功夫梦:融合之道》,年中的《罗小黑战记 2》,到年底的《疯狂动物城 2》。我这里只讲三部我印象最深也觉得最值得讲的,其中还包含了一部实际上是 24 年的电影我在今年补看的。
#### 疯狂动物城 2
这部真的把我打到了(而且打了两次,我看了两遍,也哭了两遍)。它最戳我的不是故事多精彩、多好嗑、多可爱,而是它太懂那种现实里正在发生的、难以描述但又真实存在的东西。一个原本多元、热闹、繁荣的地方,怎么在某些时刻开始变得紧绷、彼此警惕、把复杂的问题粗暴地推给某一个更方便被指责的群体。弱势群体/族裔被当成筹码,被随手拿起又随手丢弃,这种荒诞感在当下看尤其刺眼。
但它又不是那种纯粹绝望的作品。相反,它让我在很糟糕的背景噪音里,重新听到了一点有人还在认真讲这件事的声音。至少还有人愿意把我们也在这里、我们也值得被看见拍成一部面向所有人的商业动画。对我来说,这就是希望。
#### 好东西
这部其实是 2024 的电影,我是今年在年底从巴拿马走多米尼加转机回芝加哥的航班上随手点开,结果越看越安静、越安静越想把它看完。
它让我喜欢的点在于它没有用吵架的方式把议题甩到你脸上,也没有靠制造对立来完成表达。它呈现的是很多普通女性真实而具体的处境,那些不一定轰轰烈烈,但会长时间消耗人的东西,被期待、被规训、被忽略、被要求先体谅别人,再来谈自己。
有一句话我记得特别清楚,“如果我们不为自己发声,还有谁能为我们发声。”它听起来很简单,但对很多经常会把很多东西先吞下去的人来说,其实挺有力量的。作为女性,我们没法脱离自己的社会身份去生活。刻板印象和教条不是偶尔出现,而是会渗进日常的细枝末节里。这部电影给我的不是愤怒,而是一种更清醒的确认,我知道我身上那些独特的东西是什么,我只需要找到方式把它们更坚定地展示出来。别人会看见的,我只要坚持就好。
#### 唐探 1900
第三部我其实纠结过要不要给《罗小黑战记 2》,它当然很好,但如果只选三部、并且希望它能承载一点年度情绪,我最后还是选了《唐探 1900》。
它给我的触动很像《疯狂动物城 2》,到不是因为它们像,而是它们都在逼你直视一个群体在历史与现实的夹缝里,究竟是怎么活下来的。
身在美国这些年(哪怕很多时候只是学生这个相对温和的身份),你还是会在各种场景里感受到同样一件事,不同身份的人成本就是不一样。更何况电影把视角拉回到更早的年代,当出海远不是今天的叙事,当语言、制度、偏见都像墙一样压过来的时候,海外华人面对的困境更尖锐、更无法回避。
我一直觉得这部片一个很重要的意义,是它给了很多没出过国的人一个更连续的画面,海外华人的处境不是段子、不是道听途说,也不是单纯的吃苦励志,而是一套真实存在的结构和代价。对海外华人自己来说,它也像一面镜子,让我们对比当下,重新理解自己的位置、选择权、以及那些不成比例的努”从哪里来。它让我难受,但也让我更想认真面对未来,不是用委屈换同情,而是用更大的清醒去走路。
### 番剧
还是老样子,我对于番剧具体的观点和评分可以看我的网站的[动漫页面](https://zla.pub/about/anime)。今年的番剧讲真有点一言难尽,可以说是这几年最无趣的一年来(是吧)。我们在这里就不提去年提过的关于地球的运动,也不提 Ave Mujica,我主要来聊聊几个我觉得今年比较有记忆点的番。
#### 金牌得主
这是今年我个人最喜欢的一部。看结束祈在司教练的带领下往前走,真的很感动,而且不是那种空洞口号,更多是你看见一个人怎么一点点把自己从不可能里拽出来。
它讲天赋,也讲差距,但它更认真讲努力到底是什么。不是热血一冲动,而是一次次把身体和心态磨出来。起步晚也好、过去有阴影也好、被看轻也好,这些都不是终点。你可以怕,但你不能永远躲。懦弱不会帮你,勇气和持续的行动才会。
#### 启示录酒店
这个题材我一开始以为会很猎奇,尤其是在 AI 盛行的当下,结果它反而把我看得很柔软。
人类离开地球很久之后,留在地球上的机器人还在按照既定程序工作,打扫、接待、维护、等待客人。它有一点末世种田、有一点怪奇来访者,但底色其实是善意。不同种族来到这里,机器人依旧愿意把服务、鞠躬、欢迎这件事做下去,那种固执的温柔非常动人。
看完会有一种很奇怪的感觉,人类不在了,秩序还在。文明的壳子可能碎了,但善意居然还能被保存。
#### 小城日常
京阿尼的日常还是那个京阿尼,精致、耐看、细节多到离谱。它最厉害的不是讲了什么大事,有多么宏大的叙事,而是它把那些被都市节奏碾过去的细节重新捡起来,摆到你面前,让你愿意慢下来、愿意看、愿意笑。
而且这部特别适合拿放大镜找彩蛋,你会发现很多镜头本身就像一张设计过的插画。日常番还得看京阿尼。
### 阅读
今年读完的书一共 9 本,跨度也挺大,轻小说、女性议题、医学相关、艺术史都有。我这里只讲三本我最有感触、也最想留下几句话的。
#### 生如冬花的你
这是今年年初看完的一本轻小说,身体交换题材为主,但核心其实是青春、友情,以及一个人怎么被另一个人轻轻拉住。
有一句话很戳我,“一个微小的举动就可能让某个人希望破灭,随口一句温柔的话语就可能成为某个人的救赎。”它看起来像鸡汤,但在很多时候,它就是事实。珍视自己的生命,保持善良,珍惜友情,别轻易把别人(也把自己)推到更孤独的地方。
#### 大话西方艺术史
我一直很喜欢印象派,尤其是莫奈,但很长一段时间我对喜欢停留在直觉层面,好看、舒服、想多看两眼,但说不清为什么。
读这本书最大的收获,是它把一段段艺术史串了起来。你会开始理解,艺术不是凭空出现的,它永远带着时代、技术、宗教、权力结构、以及创作者自己的位置。知道这些之后,你再回去看一幅画,会更像在读一个被压缩的世界。了解背后的历史故事以后,喜欢就不只是喜欢,好看也不只是好看,它会多一层更清晰的理解和共鸣。
#### 看不见的女性
我读《看不见的女性》后最强烈的感受是许多不平等并非从显性歧视开始,而是从被塑造成“常识”的男权逻辑开始。家庭、媒体与教育把“男主外、女主内”包装成自然合理,连女性也可能在不自觉中接受甚至维护它,从而让自己的话语权与公共参与空间继续缩小。这种看似温和的顺从并不是自由,而是对依附结构的再确认。书中用大量数据揭示“默认男性”的性别数据缺口如何渗入城市规划、交通、医疗、职业装备与科技产品,使女性被迫去适应系统。真正的路径不是变得更像男性,而是觉察被建构的观念、补足女性经验的数据与评估,让“被看见”转化为资源、标准与可逆的选择权。
## 复盘 2025 OKR
### O1: 健康管理
这项基本完成的还算不错,饮食这一块算是超额完成(甚至开始有点像在做实验,怎么吃不难受、怎么吃更稳、怎么吃更省心)。运动这块就比较诚实了,滑雪让我意识到身体状况,健身让我意识到其实滑雪意识到的状况比真实的还好点,然后 10 月的 burnout 又插入了一下。健康需要长期维护,而不是靠运气。
### O2: 内容创作
写什么?什么博客?博什么客?
但开源项目们我确实没断更,维护现有项目也开发了一些新项目,这部分还行。
### O3: 学术目标
发文章哪有那么容易,2026 年初才 submit 第一篇。硕士毕业的硬性需求问题不大,接下来主要是把 thesis 写好,更重要的是写成一个未来自己回头看也能读懂的版本。
### O4: 财务管理
除了没有阅读财务规划和投资的书籍其他都超额完成,26 年需要补充一些阅读计划。
### O5: 个人成长
日语确实还在继续(多邻国已经 500 多天了),读书当然超额完成咯。
## 2026:愿景
这段写在 2026 年 2 月,一个压力很大的时间点。申请的 PhD 到现在没有 offer,但拒信不少。不用说前途了,短期的未来都很不确定。所以这里的规划也只是大方向的,我也暂时不知道到底我需要怎么做,可能需要仔细思考了。
### O1: 健康管理
KR1: 全年 ≥40 周达成每周运动 ≥3 次(力量/有氧/拉伸任意组合,单次 ≥30min)
KR2: 全年 ≥200 天做到 23:30 前上床,且 ≥7h
KR3: Therapy 维持节奏,每月 ≥1 次
KR4: 建立 Burnout 预警「红黄绿」自检表,全年 ≥10 次在“黄灯”阶段主动减载/延期
KR5: 在血样方面,维持低 LDL,降低 A1c 到 5.0 以内。
### O2: 学术目标
KR1: 完成自己满意的 master thesis,在 4 月初就需要完成初稿并开始找导师进行迭代,并在提交并完成答辩后形成简短的博客版介绍
KR2: 26 年全年产出 2 篇 paper 吧
KR3: 每周固定研究节奏,每周至少 1 次专注 ≥3h 不切换项目
### O3: 内容创作
KR1: 博客全年发布 ≥6 篇(每两个月 1 篇),其中 ≥2 篇是非游记/清单
KR2: 开源项目们继续维护,至少 1 个月更新一下 dependencies
KR3: 手记还是继续记录
### O4: 财务管理
KR1: 因为税务身份变更需要再次研究一下相关的法律避免不必要的浪费
KR2: 维持 ≥3 个月应急金,并把资产配置策略订死,除了 10\% 的个股部分其他大盘指数比例最多每 3 个月才可以调整一次
KR3: 读书学习,完成 ≥4 本财务/投资/宏观相关书
### O5: 下一阶段
KR1: 如果全聚德,需要在 4 月份前明确今年下半年到明年年初的规划
KR2: 继续学习日语
KR3: 继续读书了解更多领域
**🥳2026新年快乐!!!**
---
https://zla.pub/2025-panama-trip
---
#巴拿马:一个被运河改写命运的国家
在去年差不多的时间,我去了哥伦比亚,算是正式开启了我的拉丁美洲之旅。哥伦比亚作为大哥伦比亚的核心、西蒙·玻利瓦尔的故乡,拿它当起点再合适不过。今年,我选择用巴拿马继续把这条旅行线往外延伸。出发前我对巴拿马的了解说实话非常有限,基本就只有巴拿马运河和瑰夏。但实际走完才发现,巴拿马远不止这些。
说实话,这次行程因为各种巧合,朋友们要么回国、要么因为身份限制暂时出不去,最后变成我一个人出发。规划阶段我最担心的就是安全问题——但多方查证之后(比如[美国国务院旅行地图](https://travelmaps.state.gov/TSGMap/)、以及我最爱的 “查老师” ChatGPT),发现巴拿马整体安全水平虽然说不上顶好,但**在巴拿马城只要正常注意就基本没什么问题**。对比我去年去的哥伦比亚,巴拿马简直是好太多了。
这篇游记我会从行前准备、交通、网络、美食、住宿到景点一路写下来,希望能给想去巴拿马的朋友一个比较完整的参考。就算你只是想了解一下这个国家的气质,也欢迎继续往下看。
## 行前准备
简单来说,巴拿马行前准备并不复杂。基本使用美元、电压 110V、插头和美国一样。主要语言是西班牙语,英语普及度有限。下面我分块讲一下各个部分。
### 签证
巴拿马对持有美国、加拿大、申根国家、日本等国家长期签证的中国公民,在一定条件下可免签(以官方最新口径为准,建议出发前再核对一次)。我当时参考的是[巴拿马驻华盛顿特区大使馆](https://www.embassyofpanama.org/visas-1)的说明。
这里的信息对应我 **2025 年 12 月** 的出行情况,我本人持有有效美国 F1 签证,也有有效日本三年签(我不确定最终边检按哪个放行的,但我从美国出发,体感更像是看了美国签证)。
### 消费
巴拿马的货币是巴波亚(PAB),但 **日常流通基本就是美元(USD)**。现金、信用卡都可以。我本文中所使用的所有 \$ 符号均指美元,在这次行程期间 1 USD 大约等于 7.1 CNY,供参考。
- 绝大多数地方可刷信用卡,建议用 **免 FTF(Foreign Transaction Fee)** 的卡。
- Visa / Master 通用度最高。AMEX / Discover / 银联会遇到个别商户不支持。
- 我全程几乎没用现金,但还是建议带个几十刀备用(比如小商贩或突发情况)。
小费文化也有,大多出现在餐馆,一般 10\%–15\% 比较常见。很多地方会直接问你要给多少(不像美国那种默默把机子推过来让你自己选)。有些餐厅会把服务费直接加到账单里,结账前看一眼就好。
### 出行
我全程用 Uber(听说也能用滴滴,公交/地铁也有,但我没尝试)。Uber 在巴拿马城真的很划算,机场到市区 30 多分钟,大概 20 美元左右,市内打车很多时候是个位数,去运河(Miraflores)也就十刀上下。价格会受高峰影响,能避开高峰更舒服。
> AMEX 的 Uber Credit 可以直接使用,计价直接就是美金
### 网络
市区网络覆盖还不错,酒店、咖啡厅、餐厅大多有免费 Wi-Fi。我用的是 **US Bank Altitude Connect (UAC)** 送的 GigSky 流量,基本够用。也可以考虑 Airalo 等 eSIM,或者落地买实体 SIM。
### 环境
巴拿马属于典型热带气候,高温高湿、说下雨就下雨。巴拿马城常见体感大概 24–30°C,湿度偏高。建议衣物选择轻便透气优先,长裙/长裤很舒服,防止蚊虫叮咬。防晒和雨具也要准备好。吊带或者短裙之类的在大多数地方没问题,但如果要去教堂等宗教场所,带一件罩衫/披肩会更方便。
## Day 1: 抵达巴拿马城与入境
我从芝加哥出发,12 月 15 日经奥兰多(MCO)转机抵达巴拿马城(PTY)。前段是美联航(UA),后段是巴拿马航空(Copa)。这趟飞行基本耗掉了一整天,更要命的是转机只有 1.5 小时,还要从 MCO 的 AB 航站楼赶到 C(两段小火车 + 很长的路 + 重新安检)。幸好我有 Clear,不然我真怀疑后段要当场开始百米赛跑。重新过完安检后,我还来得及在 Terminal C 的 Premium Plaza 凑合吃一口午饭。
巴拿马入境这段有点抽象,边检人员英语几乎无法交流。我给了酒店地址、录指纹拍照之后(对方也不解释原因),我被带去做 second verification,被收走护照在单独区域等了大概 20 分钟,最后拿回盖好章的护照放行。
我没托运行李,出来就直接 Uber 去酒店,30 分钟左右,20 刀出头。可能因为我落地的航站楼偏老旧,PTY 给我的第一印象甚至不如波哥大(BOG)机场,设施更旧、指示也不算清晰,体验一般般,导致行程开局有点不安。Uber 上车点也不太直观,建议和司机多确认几次。

这次酒店我用 FHR(AMEX Fine Hotels & Resorts)订了 [Waldorf Astoria Panama City](https://www.hilton.com/en/hotels/ptytpwa-waldorf-astoria-panama/)。位置算市中心,离海边有点距离(如果你追求海景,洲际那带更近),但交通便利。
酒店整体还可以,没到我对华尔道夫的那种极致期待,但床品、备品这些关键项都没啥大槽点。欢迎礼是 3 颗马卡龙(根本不想吃,这吃了不得血糖飙升)。FHR 送了 stay 期间 \$100 Property Credit,毕竟到酒店已经晚上八点多了,于是第一晚我就直接在酒店吃晚餐了。
我点了完整三道,前菜 ceviche、主菜牛排配土豆、甜点 cheesecake。味道都不错,尤其在我当天一顿正餐都没好好吃的前提下。账单大概 \$56,直接挂房帐用 credit 抵扣就行。

## Day 2: 巴拿马老城(Casco Viejo)与巴拿马运河
先提醒想去看船闸的朋友,如果你想提高看到船过闸的概率,**更建议下午 2–3 点前后去**,上午船可能比较少。可以提前看官网的[船只时间表](https://visitcanaldepanama.com/en/)规划。我就是早上不到 9 点到了 Miraflores Visitor Center,结果人家告诉我上午已经都走光了,啥也看不到了。于是我干脆先去 Casco Viejo,事实证明这反而是更舒服的一天安排,运河博物馆就在独立广场附近,顺路得很。
### 独立广场(Plaza de la Independencia)
我先去了独立广场。这里基本就是巴拿马城的历史核心,殖民时期建筑、教堂、总统府都围在附近,比如大教堂(Catedral Metropolitana)和总统府(Palacio de las Garzas)。


### 巴拿马运河博物馆
接着我去了巴拿马运河博物馆(Museo del Canal Interoceánico de Panamá)。这个馆把运河为什么会在这里发生讲得很清楚,从西班牙殖民时期对地峡通道的早期想象,到 19 世纪跨地峡交通带来的战略价值,再到法国的失败与美国的接手,整条脉络都被放进全球贸易—帝国政治—工程与公共卫生这张网里。
法国人在苏伊士运河之后信心爆棚,试图在巴拿马复制海平面运河的奇迹,但地形、气候、工程组织难度完全不是一个级别。更致命的是,当时对疟疾、黄热病等蚊媒疾病的控制能力不足,工地几乎成了病人与坟场的循环。馆里很多材料强调,法国阶段的失败不只是技术不行,更像是工程决策、后勤组织与公共卫生体系一起崩盘的结果。常见估计是法国阶段(1881–1889)死亡人数约 2.2 万左右。
1903 年后,博物馆对美国为何能成功讲得也很有层次。政治上,美国在巴拿马从哥伦比亚分离独立的背景下迅速获得谈判窗口,随后签订条约,拿到了在运河区近乎主权式的治理权,这也成了巴拿马人长期屈辱感与冲突的根源之一。工程上,美国放弃了法国的海平面思路,转向锁闸体系,把船抬升到加通湖一带的高度穿越地峡,再降回另一侧海平面,从而在一个可控的水位系统里完成跨洋。更关键的是,美国把公共卫生当作工程的一部分(灭蚊、清理积水、改善卫生条件),让黄热病与疟疾不再持续吞噬劳动力,死亡人数因此显著下降(官方统计美国建设期 1904–1914 约 5609)。

但我在馆里最受冲击的,不是伟大工程,而是它把运河放回了殖民与种族秩序里。大量加勒比海地区(尤其西印度群岛)、非洲、亚洲劳工被招募来做最危险、最辛苦的工作,同时在工资、住房、医疗与生活区上被制度性分层(常被概括为金卷 gold roll/银卷 silver roll的差别管理)。运河区在很长一段时间里像一个国中国的殖民飞地,边界、警务与制度与巴拿马社会被硬生生切开—,冲突不断累积,只是迟早爆发。
馆里对后续历史的叙事大致是,通航之后矛盾并没消失,反而因为主权与不平等条约而持续发酵。1964 年 1 月 9 日围绕运河区主权象征(尤其国旗)引发大规模骚乱与伤亡,这一天后来在巴拿马被纪念为“烈士日”,也成为推动后续谈判的关键转折点。
长期拉扯之后,1977 年签署《托里霍斯—卡特条约》,明确运河区逐步终止(运河区在 1979 年停止存在),并于 1999 年 12 月 31 日实现运河及相关设施完全移交。此后运河由巴拿马运河管理局 ACP(Autoridad del Canal de Panamá)运营,成为巴拿马财政与全球航运体系的核心资产之一。
博物馆的结尾把未来落在一个很现实的变量上,水。锁闸系统每次通航都要消耗大量淡水,瓶颈不只是船闸容量,也在水源系统稳定性。2016 年扩建(新船闸投入使用)提升了对更大船型的通行能力,但近年极端气候与干旱导致水位偏低、通航受限,让人意识到运河的未来可能更取决于水资源治理与气候适应。
### 巴拿马老城(Casco Viejo)
逛完博物馆,我想认真开启巴拿马的咖啡线。Casco Viejo 我纠结了两家店,最后去了 Sisu Coffee。环境是真的舒服,北欧简约风,木质元素 + 绿植,坐下来心态会自动慢一拍。我点了瑰夏手冲(都到巴拿马了不喝瑰夏喝啥捏),\$10。花香果香很突出,酸度适中,甜感干净,符合这个价位我期待的表现。

Casco Viejo 是在巴拿马古城(Panama Viejo)被海盗亨利·摩根(Henry Morgan)洗劫后,1673 年西班牙殖民者在现址重建的新城(Panama Viejo 的部分我会在 [Day 4](#day-4-巴拿马古城panama-viejo遗址与超小概率事件) 讲)。这里建筑风格混合了西班牙殖民、法国、新古典主义等元素,街道紧凑,好走也好逛。历史建筑、教堂遗址、博物馆、广场、画廊、手工艺品店、咖啡馆、餐厅全都挤在一起。
我还顺路发现这里居然有星巴克(本来只是想碰碰运气买 Been There Series 马克杯)。这家店真的很小到离谱,几乎就是一个 togo 柜台。如果不是美人鱼 logo,我可能会直接错过。买完 Been There Series 的 Panama 马克杯我就走了,我不会在星巴克喝咖啡的(认真脸)。

接着去了 Golden Altar(Altar de Oro)。这是巴拿马大教堂内的祭坛,本体是雕刻的桃花心木,外面镀金,确实亮瞎眼。据说当年海盗亨利·摩根洗劫时它得以幸存。雕刻细节非常精致,属于你站在面前会忍不住多看几眼那种。对了,进去看还要 2 刀的门票(学生票半价只要 1 刀),可以刷卡,不能刷 AMEX。

然后是著名的帽街(La Calle De Los Sombreros),五颜六色的帽子悬在街道上方。在很多拉美国家都会看到类似的街道装饰,但每次看到还是会觉得很可爱。
穿过帽街就到法国广场(Plaza Francia)。这里整体是为了纪念法国人在运河早期建设中的尝试与牺牲而设的空间。往海边走到尖端还能看到一段视野很开阔的海岸线。走上侧面的台阶可以俯瞰 Cinta Costera 3 公路,这条路竟然沿着海把 Casco Viejo 绕了一圈,挺有趣的。


### 午餐:Fonda Lo Que Hay
Casco Viejo 这里有一家在 Latin America’s Best 50 Restaurants 榜单里排得挺靠前的店,Fonda Lo Que Hay。整体是那种小而灵的创意小馆,不奢华但很 local,工作日中午也挺热门,我只能坐吧台。
我点了一个 bowl,整体是炖牛肉 + 豆子打底,上面有彩椒、洋葱、小葱、一颗溏心蛋,再加一点薯片。饱腹感很强,价格大概 \$20 左右。说实话,和美国比并没有让我觉得便宜。味道整体偏咸一点,但还不错。吃到一半外面飘起小雨,差不多也到该去运河的时间了,于是 Uber 去 Miraflores Locks。

### 巴拿马运河(Miraflores Locks)
上午我已经买过票,下午就直接进。车还没停稳我就看到一艘船在过闸,立刻冲上观景台。
Miraflores 是太平洋侧的船闸,也是游客最常看的点。观景台有西语/英语双语解说,讲船闸工作原理与历史背景。原理其实很直观,船进入闸室,闸门关闭,通过注水/放水改变水位,让船升降,再打开另一侧闸门放行。看船身跟着水位一起上下移动,真的像坐电梯一样,非常直观。
这里还有一个 IMAX 影院,放运河建设相关的 3D 纪录片,时长 20 分钟左右,票价包含在门票里。内容偏概括,如果你想更系统了解历史,我个人还是更推荐运河博物馆。
看船过闸的妙处在于你在看船,船上的人也在看你。你在跟船合影,船上的人也在跟你合影。

### 晚餐:Cantina del Tigre
晚餐我选了 Cantina del Tigre(Latin America’s Best 50 Restaurants 排名第 47)。相比中午那家偏 local 的创意小馆,这家整体氛围更约会风,灯光暗一点、装潢更现代一点—,不太适合我这种一个人吃饭的。
晚餐选择了一个鱿鱼 ceviche 当前菜,主菜是他们家特色的 Rice tamale with prawns。鱿鱼 ceviche 很新鲜,柠檬酸味 + 海鲜鲜味结合得很好,配油炸大蕉片很开胃。Rice tamale with prawns 用香蕉叶包着米饭,米饭里有木瓜和椰奶的风味,搭配大虾,有点东南亚那种甜香+海味的感觉。香蕉叶还会点燃一下,带出一点点烟熏香气。就是对我来说这个主菜稍微有点腻。整体非常满意,含税和小费大概 \$50 左右。

## Day 3: 都市自然公园徒步与生物多样性博物馆
得益于中美地峡的地理枢纽位置,以及太平洋与大西洋(加勒比海)分列两侧,巴拿马形成了多样的生态环境,从而孕育了高度的生物多样性。巴拿马自己也很清楚这一点,并且把保护与展示当作国家形象和旅游资源的重要组成部分。
### 巴拿马都市自然公园(Parque Natural Metropolitano)
在一个国家的首都的市中心,坐落着一个面积达 265 公顷的自然保护区,也就是我这天上午的目的地。这个公园本身的特色来自于天然的物种资源,提供了独特的 hiking trails,可以近距离观察热带雨林的生态系统。公园内有多条徒步路线,适合不同体力和兴趣的游客。
我选了一条比较轻松的 trail,目标非常明确,想看野生动物。当天阳光很好(对比前一天的阴雨,可太好了,毕竟我从宁古塔跑来这里不是为了继续看不到太阳的)。树荫多,所以虽然热但不至于被晒到崩溃。芝伯利亚待久了,在长期 20\% 以下湿度 + 零下十几二十度的夹击之后,巴拿马这种热带湿润对我来说就是天堂。
我本人其实不怎么 hiking,也没什么动植物背景知识。典型工科女对新事物的那种好奇心在这里直接拉满,池塘里成片的乌龟、森林里的小鹿、树上的树懒、颜色夸张的鸟、各种昆虫……见到树懒 🦥 真的很开心。它远远倒挂在树上,我盯着看了好几分钟,它一动不动,比我想象中还要懒。
继续走还看到成片白鼻浣熊(我一开始完全没认出来是什么动物,感谢查老师)。它们完全不怕人,甚至会朝人走过来。查老师提醒我不要喂食,以免改变它们习性或者被误伤。下山途中还遇到生物课本现场版,蚂蚁搬运树叶,一排排队列从路这头到那头,背着比自己体型还夸张的叶片碎块。
本来这次的计划是想要看到大嘴鸟和学长们(食蚁兽 Anteater)的,但显然在城市中间的自然公园里看到这些动物的概率并不大,毕竟它们更喜欢生活在更为原始的热带雨林中。不过能够看到这么多平常从未见过的动植物,已经让我非常满足了。其实如果不是一个人来的话,我更想去加通湖和猴岛那边,感觉看到更多物种的概率更大。

### 生物多样性博物馆(Biomuseo)
下午我去了生物多样性博物馆(Biomuseo),这是由著名建筑师弗兰克·盖里(Frank Gehry)设计的建筑,位于巴拿马城的阿马多尔海滨大道(Avenida Amador)上。博物馆的设计非常独特,采用了鲜艳的颜色和不规则的形状,象征着巴拿马丰富的生物多样性和生态系统的多样性。博物馆内有多个展厅,展示了巴拿马的自然历史、生物多样性、生态系统等内容。展览内容包括各种动植物标本、互动展览、多媒体展示等。

这里也可以买学生票,门票 \$12。馆内动线很清晰,每个展区还有工作人员做简短导览,也有英文。内容从远古地质变迁、中美地峡形成、人类活动、巴拿马运河到现代生态保护都有覆盖。展品包括标本、化石、互动装置等。整体规模不算大,1–2 小时就能逛完。
相比运河博物馆那种历史叙事、甚至带强烈政治张力的展览,这里更偏自然科学与科普,门槛更低,不需要太多背景知识,适合各个年龄层。尤其在一个左右两侧是两个不同大洋的国家里,这些差异会显得更直观。加勒比海侧物种偏小、珊瑚与热带鱼丰富,太平洋侧的鱼类体型更大更凶猛、珊瑚相对少一些。
当然,Gift Shop 也是必不可少的,这也太可爱了 🥰


### 巴拿马标志牌(The Panamá Sign)
秉持来都来了的原则,我顺路去了阿马多尔海滨大道尽头的巴拿马标志牌(The Panamá Sign)。这是一组 PANAMÁ 大字母地标。这里可以俯瞰到巴拿马运河的入口和太平洋的美景,当然这个时候又开始天公不作美了,乌云密布,风雨欲来,光线和能见度都有些差。


### Multiplaza Panama 购物中心
我去一个新国家时,通常会刻意找机会看看不同阶层的生活切面。于是,我选择来到了 Multiplaza,一个感觉和巴拿马其他地方有点不太一样的购物中心。一进门就是两侧的各种奢侈品牌,从 Cartier, Gucci, Prada, LV, Fendi, Burberry 等等,琳琅满目。

运河带动的贸易与金融发展,让巴拿马城逐渐成为拉美重要的商业与金融中心,吸引跨国公司与机构设点。Multiplaza 就像这种国际化都市面貌的一个缩影,它不一定代表巴拿马,但它确实是巴拿马城市结构的一部分。
在 Multiplaza 中有一家巴拿马本地连锁的咖啡店,Unido,这家店在巴拿马有多家分店(包括 PTY 机场内),在前一天的时候我实际上尝试在另一家分店想要尝一下他们家的瑰夏,但不幸没有库存,而今天这家店有瑰夏,便点了一杯来尝试一下。Unido 的瑰夏和 Sisu Coffee 的瑰夏风味上有一些明显的差异,Unido 的豆子并没有突出的花果香,甜感也稍显平淡,并没有太多层次感,整体来说非常中规中矩,并没有太多惊喜。

随便吃了点晚饭,看到这里有一家还算出名的全球连锁的法式 Brunch 和甜点店,之前在别的国家也没有吃过,在 Google Maps 里有着 4.4 的高分,便想着去尝试一下。按照我的习惯点了一个柠檬挞(Lemon Tart)和一个巧克力的闪电泡芙(Éclair)。这只柠檬挞的造型比较经典,在酥皮包裹住的柠檬馅上面覆盖了一层厚厚的烤蛋白霜,整体口感酸甜适中,蛋白霜的甜味中和了柠檬馅的酸味,口感丰富。闪电泡芙则是经典的法式甜点,外层是酥脆的泡芙皮,内里填充了浓郁的巧克力奶油馅。总体来说这两款甜品的甜度都稍高,感觉在冰箱中放的时间稍长,酥皮都稍微有一些湿软了(图中能看到闪电泡芙本身上面有一些水雾),但整体味道还是不错的,毕竟好久没吃到相对不错的了(是吧芝加哥)。

## Day 4: 巴拿马古城(Panama Viejo)遗址与超小概率事件
第四天的天气比前两天都好(起码早上出门时这样的),那必须要一杯好咖啡开启新的一天啦。继续探店旅程,因为今天的第一站时巴拿马古城,就选择了算是从酒店过去半路上的 Leto Coffee。这家咖啡店对比前两天的感觉就不是很一样了,在有着独立门头的情况下内部的装饰相对工业风,同样点缀有一些绿植。依旧是手冲瑰夏,依旧是 Hario 01 的手冲壶,配了一只粉色条纹的阔口杯,这家的风味就比 Unido 好太多了,和 Sisu 属于一个梯队,酸度没有那么突出,但花果香和甜感都非常好,整体层次感也很丰富。

### 巴拿马古城(Panama Viejo)遗址
巴拿马古城(Panama Viejo)遗址是巴拿马城的发源地,也是全美洲在太平洋侧最古老的欧洲殖民地遗址。1519 年,西班牙殖民者佩德罗·阿里亚斯·德·阿维拉(Pedro Arias de Ávila)在这里建立了巴拿马城,作为西班牙帝国在新大陆的重要据点。巴拿马古城在其早期历史中扮演了重要的角色,成为连接大西洋和太平洋的贸易枢纽。然而,1671 年,著名海盗亨利·摩根(Henry Morgan)率领的海盗袭击并洗劫了巴拿马古城,导致城市被严重破坏。随后,西班牙殖民者决定在现址重建新的巴拿马城(Casco Viejo),而古城遗址则被废弃。在 1977 年,巴拿马古城遗址被联合国教科文组织列为世界文化遗产,成为巴拿马重要的历史和文化遗址。
在这里有一些剩余的建筑遗址,也有一座介绍历史的博物馆。个人推荐先进博物馆了解一下相关的历史再去参观遗址会更有感受一些。博物馆内的时间动线安排的还不错,从最早期的巴拿马土著文化,到西班牙殖民时期的建立与发展,再到海盗袭击和古城的废弃,最后到现代的保护与研究。介绍了人文历史、建筑演化、宗教影响、经济活动等多个方面。展品包括考古发现、历史文献、模型、图片等,内容丰富且有趣。参观时间大概在 1-2 小时左右。

在参观完后我便想着再去一下 Casco Viejo,去鱼市场(Mercado de Mariscos)吃午饭,然后再去买一些纪念品。结果在去鱼市场的路上,我突然看到一面非常眼熟的红旗飘在建筑上——大脑当场短路。打开地图一看才发现,我居然无意间走到了中国驻巴拿马大使馆附近。

### 超小概率事件
(这小标题起的好啊)在进入正题之前,首先,不推荐鱼市场,非常游客导向,虽然物价不算很贵但食材的新鲜度和味道并没有很好,我点的这个鱼有点太咸了,搭配的木薯薯条(Yuca Fries)有点意思,但不会再来。

饭后我遍按照先前的规划,先去 sisu 买了两包瑰夏(好贵啊 😰),然后打算去先前找到的一家提供体验手工巧克力制作的店 Nome。进店我先装作什么都不知道,开启~~品尝~~蹭吃模式,店员让我试了不同纯度的黑巧,还有带辣椒、以及加入瑰夏风味的巧克力。巴拿马的巧克力整体风味很醇厚,跟我平时常吃的巧克力比,多了一种更热带的香气(我只能这么形容)。
就在我准备问体验课的时候,后面突然出现一位看起来明显是从美国来的姐姐,于是触发了被动技能,美式 small talk。她推荐我去上巧克力体验课,我顺势就跟店员说我也想试试。得知要等一个小时,我就先在旁边坐下。
然后剧情开始离谱,简直比小说还精彩。她问我从哪里来,我说芝加哥,她说她也从芝加哥来(我 CPU 已经开始冒烟)。她又问我在芝加哥做什么,我说我在 Northwestern 读 Master,她说她也是 Northwestern 的(CPU 继续升温)。
更离谱的是,她两个儿子,一个 Northwestern 本科,一个 UCSD 本科。她说完我说我本科在 UCI 读的,然后大家集体震惊。
我默默从口袋里掏出卡包,拿出 Northwestern 校园卡,她也掏出校园卡,她儿子也掏出校园卡,在一个完全想不到的地方遇到了完全没有预料到的事件。
继续聊天得知她是 Northwestern Medicine 的医生,而我研究方向也跟医疗相关,于是越聊越投机。最后我们交换了联系方式,约好回芝加哥以后一起吃饭。世界真小,小到有点像 bug。


## Day 5:回程
回程单独拿出来说主要是因为我恰巧定到了巴拿马航空最新的 737 MAX 9 搭载了全躺平窄体机的航班,便想要分享一下乘坐体验。在巴拿马城机场(PTY)的出境航班有单独的安检通道,但我过安检的时候并没有什么人在排队,感知不强。PTY 有两个休息室,分别由 Copa Airlines(巴拿马航空)和 The Lounge 提供,都可以用 PPS 进。没有比较好的早餐提供,有一些软饮和零食,整体人也非常多。

从 PTY 飞到多米尼加共和国的蓬塔卡纳(PUJ)大概是 3 个小时,前一天晚上确实没有睡很多,也想着体验一下全躺平是什么感觉(确实,我没体验过),一起飞放完饭就把座椅放平休息了。Copa 的商务舱是很常规的反鱼骨布局,我订得早选到了 1A,腿部空间确实更宽敞些,体验很舒服。

Punta Cana 的转机体验也非常好,虽然是从 Copa 转 UA,同联盟非同航司,但 Copa 还是给配了一个地勤人员全程陪同转机。一出廊桥就看到她举着写着我名字的牌子(社恐地狱…)转机不需要过海关,只需要过一下安检就可以到候机的地方了。PUJ 的休息时室也有两家,都是机场自营的,也都可以用 PPS 进,环境和餐食吊打 PTY,可以当作正餐凑合一下吃。

## 总结
这次 solo trip 的体验比我预想好太多,看到了初中课本上的巴拿马运河,补上了很多被忽视的历史与现实,也在一个完全不同的国家里重新校准了自己对安全、城市、文化的判断。安全方面也比我预想强很多(可能是哥伦比亚把我的下限拉得太低了)。只要注意常规安全习惯,女生独自旅行完全没问题。
消费上(不算机票和酒店),这几天我的开销大致是吃饭 + 纪念品各占 1/4,门票支出低于 10\%,交通占 20\%,咖啡占 5\%;剩下是给朋友们买的小礼物。整体物价跟美国差距不大,有些地方甚至更贵(尤其咖啡),但打车很便宜,门票有学生优惠的话也很友好,总体可接受。
最后必须感谢世界上最伟大的银行 AMEX!这次往返机票是用 MR 转 Avianca,叠加当时 15\% 转点 bonus。我转了 30k MR 到 Avianca,用 35k 里程 + \$180 税费出票(回程 PTY–PUJ 是商务舱,其余经济舱)。我主要是不想从 IAD 入境,所以绕了一下 PUJ,如果走 PTY–IAD–ORD 会更便宜也更省时间。
酒店方面,用 FHR 订了 4 晚巴拿马华尔道夫,约 \$180/晚。分了两张 Plat 订,报销后最终自费大概 \$120 左右。
未来会继续计划探索更多拉丁美洲国家~~~
---
https://zla.pub/react-useTransition
---
#理解 React 的 useTransition():原理、用途与最佳实践
## 什么是 `useTransition()`?
[`useTransition()`](https://react.dev/reference/react/useTransition) 是 React 18 引入的一个 hook,用于处理 **可中断的 UI 更新**,比如列表筛选、搜索结果加载、标签切换、表单提交等。它的目标是:**让高优先级的交互(如输入)保持流畅,而将低优先级的更新“挂起”执行**。
```tsx
const [isPending, startTransition] = useTransition()
```
我们可以用它来包裹**非关键性更新**,从而避免用户界面卡顿。
## 为什么需要 `useTransition()`?
在传统 React 更新中,所有状态更新都是同步的:
```tsx
setSearchQuery(input) // 会立即触发组件更新
filterBigList(input) // 大量计算任务
```
在这种场景下,用户的输入可能会**变卡顿**,因为 React 正忙于重新渲染庞大的 DOM。
而使用 `useTransition()` 你可以把这类开销大的任务变成“可中断”的:
```tsx
setSearchQuery(input) // 高优先级,保持输入顺畅
startTransition(() => {
setFilteredResults(filterBigList(input)) // 低优先级,不会阻塞输入
})
```
> 本质上:你把副作用较大的状态更新“标记”为**可以延迟处理**的,从而提升交互体验。
## 使用场景
### 搜索/筛选/排序列表
```tsx
const [query, setQuery] = useState('')
const [filtered, setFiltered] = useState(data)
const [isPending, startTransition] = useTransition()
const handleChange = (e) => {
const input = e.target.value
setQuery(input) // 高优先级
startTransition(() => {
setFiltered(data.filter(item => item.name.includes(input))) // 低优先级
})
}
```
### 页面切换、Tab 切换
如果数据很多,可以用 `useTransition()` 延迟加载:
```tsx
const handleTabChange = (tab) => {
setActiveTab(tab) // 高优先级
startTransition(() => {
setTabContent(loadTabContent(tab)) // 大量运算或渲染
})
}
```
### 虚拟滚动、大量 DOM 节点渲染
在 `setScrollPosition()` 后立即触发数据更新可能卡顿,使用 `useTransition()` 可平滑体验。
```tsx
const handleScroll = () => {
startTransition(() => {
setScrollContent(loadScrollContent(window.scrollY)) // 大量运算或渲染
})
}
```
### 表单提交
在表单提交时,我们可能需要进行 `zod` 校验、后端请求等操作,这些操作都是**非关键性更新**,不能让用户等待过程中毫无感觉,可以使用 `useTransition()` 包裹。
```tsx
const handleSubmit = (e) => {
e.preventDefault()
startTransition(() => {
// 进行 zod 校验、后端请求等操作
})
}
```
> 在 React 19 +,使用 [`useActionState()`](https://react.dev/reference/react/useActionState) 可以替代 `useTransition()` 来处理表单提交。效果更好并且可以使用 [Server Action](https://react.dev/reference/rsc/server-functions) 来处理表单提交。
>
> 但不管如何,我更加推荐使用 [TanStack Form](https://tanstack.com/form/latest/docs/overview) 或其他你喜欢的表单库来处理表单提交,避免 React 的疯狂 Rerender 并且能提供更好的 UX。
## Best Practices
| 推荐做法 | 不推荐做法 |
| ------------------------------------------ | -------------------------------------------------- |
| 只用于非关键交互 | 滥用导致界面延迟更新 |
| 配合 loading spinner 显示 `isPending` 状态 | 忽略 `isPending` 导致 UX 迷惑 |
| 适用于复杂列表和过滤器 | 不适合用在 form 提交、导航跳转等必须立即响应的操作 |
| 理解「可中断」含义,不等于异步 | 误以为是 `setTimeout` 或 `async/await` 替代 |
## 常见误区
- **误区 1**:用 `useTransition()` 会“变快”?
其实不是变快,而是**让重要更新先执行,次要更新慢慢来**。
- **误区 2**:可以替代 `useEffect()` 吗?
`useTransition()` 是控制更新优先级,而非副作用执行时机。
- **误区 3**:是不是必须搭配 Suspense?
不需要。虽然它和 Suspense 一起使用更强大,但单独用也非常有用。
## UX 加分项:给用户一点提示
使用 `isPending` 提示用户数据正在加载:
```tsx
<>
isPending &&
{' '}
Loading...
{filtered.map(item => (
- {item.name}
))}
```
你还可以加上 spinner、skeleton 等效果提升体验。
## 总结
| 优点 | 说明 |
| ---------------- | --------------------------------------- |
| 提升交互流畅度 | 输入、点击不再卡顿 |
| 更灵活的状态管理 | 精细控制高低优先级更新 |
| 易于集成 | 与现有 `useState`、`useEffect` 无缝配合 |
> **`useTransition()` 不是让程序变快,而是让用户感觉更快。**
如果你在开发过程中遇到 React UI 卡顿的场景,不妨尝试 `useTransition()`。它不会让你的代码更复杂,却能显著提升用户体验。
---
https://zla.pub/pandas-text-processing
---
#Pandas 逐行处理文本数据的方法对比与优化
在使用 Pandas 处理文本数据时,我们通常会涉及数据清理的任务,例如去除 HTML 标签、去除特殊字符、转换大小写等。在 NLP 任务中,许多文本预处理操作需要基于 **Pandas DataFrame** 进行处理。但由于 Pandas 的字符串操作本质上仍然是逐行处理的,我们无法直接使用向量化优化,而不得不考虑如何选择最佳的逐行处理方法。
在我最近的项目中遇到了需要对一个 _7,000,000 行_ 的文本数据集进行清理的任务,本文基本上是记录我的实验过程和结果。
本文将对比 5 种不同的 Pandas 处理方法,并进行基准测试,以衡量它们在执行时间和内存消耗方面的差异。同时,我们会分析实验数据,探讨 如何真正优化文本清理的性能。
## 背景
在 Pandas 处理数据时,`str.replace()`、`str.lower()` 等方法虽然在 Cython 层面做了一些优化,但仍然是逐行处理的,而不像 NumPy 这样的数值计算真正实现了向量化。对于 NLP 任务,如 `nltk`、`symspellpy`、`regex` 等涉及外部库的复杂数据清理逻辑,我们无法使用 Pandas 内建字符串方法进行向量化计算,只能采用逐行处理方式。
因此,我们对比以下 5 种 Pandas 逐行处理逻辑:
1. 经典 `for-loop`
2. `apply` 方法
3. `map` 方法
4. 列表推导式(List Comprehension)
5. `itertuples` 方法
我们希望找出哪种方法在 Pandas 中执行文本清理任务时更高效。
### 测试介绍
我们使用一个复杂的 `clean_text()` 作为示例,该函数涉及 去除 HTML 标签、URL、停用词、词形还原(lemmatization)、拼写错误修复、正则清理等,依赖 `nltk`、`symspellpy` 和 `regex` 进行处理。
```python
def clean_text(text: str) -> str:
"""
一个复杂的文本清理函数,这里不展示具体实现
主要包含:
- 去除 HTML 标签
- 词形还原(NLTK)
- 正则表达式清理
- 拼写错误修复(symspellpy)
"""
return text
```
我们使用 **50,000 行真实文本数据** 进行测试,并保证数据一致性。
```python
import pandas as pd
import numpy as np
def get_test_data(n: int = 50_000) -> pd.DataFrame:
return pd.DataFrame(data)
```
## 五种 Pandas 处理方式
### 经典 for-loop
```python
def method_for_loop(df: pd.DataFrame) -> pd.DataFrame:
cleaned_texts = []
for t in df["text"]:
cleaned_texts.append(clean_text(t))
df["cleaned_text"] = cleaned_texts
return df
```
- 通过 Python 的 for 循环逐行处理数据
- 代码直观易懂
- 由于 Python 的循环性能较低,对大数据集不够高效
- 不 Pythonic,调用 `.append()` 方法会产生额外的开销
### `apply` 方法
```python
def method_apply(df: pd.DataFrame) -> pd.DataFrame:
df["cleaned_text"] = df["text"].apply(clean_text)
return df
```
- `apply` 方法会将 `clean_text` 应用于 `text` 列的每一行
- 语法简洁,适用于 Pandas Series 级别的操作
### `map` 方法
```python
def method_map(df: pd.DataFrame) -> pd.DataFrame:
df["cleaned_text"] = df["text"].map(clean_text)
return df
```
- 理论上,`map` 方法在对 **字典** 元素操作的时候会比 `apply` 更快,因为对于字典元素 `map` 有专门优化。
- `map` 主要用于对 Series 进行逐元素转换
- 语法简洁,与 `apply` 类似,通常性能差异不大
### 列表推导式(List Comprehension)
```python
def method_list_comprehension(df: pd.DataFrame) -> pd.DataFrame:
df["cleaned_text"] = [clean_text(t) for t in df["text"]]
return df
```
- 通过列表推导式直接生成新列表,将整个 `numpy` 数组直接赋值给 DataFrame
- 通常比 `apply` 和 `map` 方式更快,因为不涉及额外的 Pandas 操作,没有 `Series` 结构的开销,直接利用 python 的优化。
- 代码简洁,Pythonic
### `itertuples` 方法
```python
def method_itertuples(df):
df["cleaned_text"] = [clean_text(row.text) for row in df.itertuples(index=False)]
return df
```
- 使用 `itertuples` 方法,直接访问元组对象,提高迭代性能
- 通常比 `iterrows` 更快
- 对于只需要单列数据的操作,没必要用 `itertuples`,直接使用 `df["text"]` 更简单
## 结果与分析
### 执行时间
根据实验结果,执行时间排序如下:
| 方法 | 执行时间 (秒) |
| -------------------- | ------------- |
| `map` | **104.64s** |
| `apply` | **105.21s** |
| `list comprehension` | 105.23s |
| `itertuples` | 105.76s |
| `for-loop` | 106.26s |
### 内存使用
| 方法 | 内存使用 (MB) |
| -------------------- | ------------- |
| `apply` | **33.56 MB** |
| `map` | **39.00 MB** |
| `itertuples` | 43.12 MB |
| `list comprehension` | 43.69 MB |
| `for-loop` | 59.44 MB |
### 结果分析
- 所有方法的执行时间几乎相同,说明主要瓶颈在 `clean_text()` 而不是 Pandas 方法的选择。
- `apply` **方法的内存占用最低**,表明 Pandas 可能在内部进行了优化。
- `for-loop` 由于 `append()` 产生额外的 Python 级调用,导致内存消耗最高,永远都别用。
## 优化方向
在本次实验中,所有方法的执行时间差距并不大,说明它们的主要瓶颈在于 `clean_text` 的执行,而不是 Pandas 本身的操作。因此,我们更应该关注 `clean_text` 函数的优化,而非 Pandas 处理方式的选择。
### 优化 `clean_text` 函数内部
这个就需要考虑如何简化 `clean_text` 函数的逻辑,减少不必要的计算。例如,可以考虑使用更高效的算法、减少循环次数、减少正则表达式的使用(或者该用 `re.sub()` )等。对于 stop words,可以使用 `set()` 来储存,提高速度等。重点是考虑其中不同方法阈值设置的 trade-off,比如 symspellpy 的拼写错误修复,我们可以设置不同的阈值来减少计算量。
### 使用 `concurrent.futures`
由于目前的实际运行会受到 **GIL** 的限制,Python 的多线程并不能真正实现并行处理。但是可以考虑使用 **多进程** 来加速处理,将数据分块处理,然后合并结果。
我在项目中选择的方案是 `concurrent.futures` 模块,使用 `ProcessPoolExecutor` 来实现并行处理(不可以使用 `ThreadPoolExecutor`,因为并没有真正解锁 GIL)。
```python
from concurrent.futures import ProcessPoolExecutor
with ProcessPoolExecutor(max_workers=8) as executor:
results = list(executor.map(clean_text, df["text"]))
df["cleaned_text"] = results
```
### 使用 Dask(不推荐)
Dask 是另一个并行计算库,可以用于处理大数据集。但是我的使用场景和实际测试中,Dask 并没有带来性能提升,反而会增加额外的开销。因此,不推荐使用 Dask。尤其配置 Dask 集群的开销会更大,配置相对复杂,不适合小规模数据集(我们的场景只有 7,000,000 行数据)。
```python
import dask.dataframe as dd
ddf = dd.from_pandas(df, npartitions=8)
ddf["cleaned_text"] = ddf["text"].map_partitions(clean_text)
df = ddf.compute()
```
## 总结
1. 对于 Pandas 处理文本数据,我们应该更关注文本清理函数的优化,而不是 Pandas 方法的选择。
2. `apply` 方法在内存占用上表现最佳,但性能与 `map`、`list comprehension` 差异不大。
3. `clean_text()` 函数的优化是提高性能的关键,可以考虑简化逻辑、减少循环次数、减少正则表达式的使用等。
4. 使用 `concurrent.futures` 模块可以实现并行处理,加速数据清理过程。
---
https://zla.pub/python-decorator-contextmanager
---
#Python 装饰器(Decorator)和上下文管理器(Context Manager)详解
## 前言
最近在做自己的 Research Project,大量使用到了 Python(因为项目还在进行中,代码暂时无法开源)。有很多情况下我都想要检测一个函数(或者一段代码)的执行时间、管理 SQLALChemy 的 Session(管理 Transaction 和 Rollback)等等。这时候就需要用到 Python 的装饰器(Decorator)和上下文管理器(Context Manager)。讲真,这两个东西真的很方便,而且代码看起来也很优雅。我相信没人愿意写一堆重复的代码,或者等一个要执行很多不同的函数负责不同功能无法统计时间,或者每次都要手动管理 Session(甚至忘记 Rollback)。今天我就来详细介绍一下 Python 中的 decorator 和 context manager。
## Wrapper(包装器)
### Wrapper 的概念
在 Python 中,Wrapper(包装器)是一种用于**修改函数行为**的方式,通常用于封装函数的执行过程。例如,我们可以创建一个包装器来在函数调用前后打印日志。
Wrapper 是装饰器的基础,装饰器本质上就是一个高级的 wrapper。
### Wrapper 示例
```python
import time
def wrapper(func): # 接收一个函数作为参数
def inner(*args, **kwargs): # 接收任意参数
print(f"Calling {func.__name__}...")
start = time.time()
result = func(*args, **kwargs)
print(f"Executed {func.__name__} in {time.time() - start:.2f}s")
return result
return inner
def my_function():
time.sleep(1)
print("Hello, world!")
wrapped_func = wrapper(my_function) # 手动包装
wrapped_func() # 需要手动调用被包装的函数
```
### Wrapper 的局限性
- 需要手动调用 `wrapper(func)`,不够直观。
- 不能直接装饰多个函数,需要对每个函数手动调用 `wrapper(func)`。
## 装饰器(Decorator)
### 装饰器的概念
装饰器(Decorator)是 Python 中的一种**函数**或**类**,用于**动态地修改函数或方法的行为**,而无需修改其代码。装饰器常用于:
- **日志记录**
- **权限校验**
- **缓存**
- **执行时间统计**
- **事务管理**
在 Python 中,装饰器通常使用 `@decorator` 语法糖来应用。
### 无参数装饰器
最简单的装饰器是无参数装饰器,它接收一个函数作为参数,并返回一个新函数。
#### 示例:计算函数执行时间的装饰器
```python
import time
from functools import wraps
def timer(func):
@wraps(func) # 保留原函数的 __name__ 和 __doc__
def wrapper(*args, **kwargs):
start = time.time()
result = func(*args, **kwargs)
print(f"{func.__name__} executed in {time.time() - start:.2f}s")
return result
return wrapper
@timer # 直接装饰函数
def my_function():
time.sleep(1)
print("Hello, world!")
my_function()
```
### 带参数装饰器
如果需要**传递参数**来控制装饰器的行为,就需要使用多层嵌套。
#### 示例:可调整日志级别的装饰器
```python
import time
from functools import wraps
def timer(level="INFO"): # 允许用户传递日志级别
def decorator(func):
@wraps(func)
def wrapper(*args, **kwargs):
start = time.time()
result = func(*args, **kwargs)
print(f"[{level}] {func.__name__} executed in {time.time() - start:.2f}s")
return result
return wrapper
return decorator
@timer(level="DEBUG") # 传递参数
def my_function():
time.sleep(1)
print("Hello, world!")
my_function()
```
### 既支持无参数又支持带参数的装饰器
有时,我们希望装饰器既可以 `@decorator` 直接使用,又可以 `@decorator(arg)` 传参。
#### 示例:兼容无参数和带参数的装饰器
```python
import time
from functools import wraps
def timer(func=None, *, level="INFO"): # 让 level 作为关键字参数
if func is None:
return lambda f: timer(f, level=level)
@wraps(func)
def wrapper(*args, **kwargs):
start = time.time()
result = func(*args, **kwargs)
print(f"[{level}] {func.__name__} executed in {time.time() - start:.2f}s")
return result
return wrapper
@timer # 无参数
def function_1():
print("Function 1")
@timer(level="DEBUG") # 带参数
def function_2():
print("Function 2")
function_1()
function_2()
```
## 上下文管理器(Context Manager)
### 上下文管理器的概念
上下文管理器用于**管理资源的分配和释放**,典型场景包括:
- **文件操作**
- **数据库连接**
- **线程锁**
- **网络连接**
- **性能计时**
上下文管理器使用 `with` 语句来确保资源正确释放。
### 使用 `contextlib.contextmanager`
Python 提供了 `contextlib.contextmanager`,可以用更简洁的方式实现上下文管理器。
#### 示例:使用 `@contextmanager` 进行计时
```python
import time
from contextlib import contextmanager
@contextmanager
def timer(name):
start = time.time()
print(f"⏳ {name} started...")
yield # 代码块执行
print(f"✅ {name} completed in {time.time() - start:.2f}s.")
with timer("Processing"): # 代码块执行时自动计时
time.sleep(1)
```
## 装饰器 vs. 上下文管理器:选择指南
| 方式 | 适用范围 | 主要用途 | 优点 | 缺点 |
| ----------------------------------- | ---------- | ------------------------------ | ------------------------ | ----------------- |
| **Wrapper(包装器)** | 函数 | 修改函数行为 | 简单易懂 | 需要手动调用 |
| **装饰器(Decorator)** | 函数、方法 | 计时、日志、缓存、权限控制等 | 语法简洁,易复用 | 只能用于函数/方法 |
| **上下文管理器(Context Manager)** | 代码块 | 资源管理、事务管理、性能监控等 | 适用于代码块,不影响函数 | 需要 `with` 语句 |
### 何时使用?
- **需要增强函数行为**(如日志、缓存、计时)==> 用 **装饰器**。
- **需要管理资源生命周期**(如文件、数据库、锁)==> 用 **上下文管理器**。
- **如果逻辑可以封装成独立函数** ==> 用 **装饰器**。
- **如果逻辑需要在代码块中生效** ==> 用 **上下文管理器**。
## 总结
装饰器和上下文管理器都是 Python 的强大特性,它们分别适用于不同的场景。如果你的目标是**增强函数的行为**,装饰器是最佳选择;如果你的目标是**管理资源**,上下文管理器更合适。
---
https://zla.pub/tailscale
---
#使用 Tailscale 实现 SSH 内网穿透
## 前言
其实这件事情非常复杂,我在家里有一台 ITX,但它一直都是 Windows 系统。在前段时间因为我跑的项目需要很大的内存(还有一个需要 CUDA 加速),我便打算把它利用起来,而不是只用来打游戏(关键我自从读研以后基本就没打过游戏了)。但是我发现,在 Windows 里写代码出现了很多问题,先简述一下我这两个项目中我遇到的两个问题。
1. 在运行一个基于 Python 和 PostgreSQL 的项目中,出现了 GBK 编码与 UTF-8 编码的问题,PostgreSQL 不允许 GBK 编码的数据导入,在 Python 中强行 encode 也无法解决问题。这个问题出现的原因是我在安装 Windows 的时候选择了**中文**作为系统语言。Windows 就直接把整个系统的编码设置成了 GBK(即使后来把语言换成了英语)。最后的解决方式是在控制面板中找到一个隐藏的 UTF-8 (beta) 选项,把它打开,重启系统,这样系统就会默认使用 UTF-8 编码了。
2. 另外一个实际上很好理解,是一个 LLM 的项目(相信大家也不会在 Windows 上训练模型的)。我当时想要使用 [Unsloth](https://unsloth.ai/) 来跑 QLoRA(因为我只有一张 3070Ti,8G 显存),虽然他们官方提供了 [Windows 安装教程](https://docs.unsloth.ai/get-started/installing-+-updating/windows-installation),也提供了 Windows 版本的 [Triton](https://github.com/woct0rdho/triton-windows),但还是出现了各种各样的环境配置问题。
然后,我就一气之下,抛弃了 Windows,装了 [Ubuntu 24.04 LTS](https://ubuntu.com/download/desktop)。当然,这体验直线上升,节省了非常多的时间和情绪问题。但是,我经常需要去学校上课或者去 Lab,我不可能说来回切换 mac 和家里的Ubuntu,于是我就想给它折腾一下内网穿透,让我能够不在家的时候也能用它。
最初,我尝试使用 Cloudflare Tunnel,但最终放弃,转而使用 Tailscale。这篇文章本质上就是个教程,有同样需求的可以参考一下。
## 尝试 CF Tunnel:理论可行,实际劝退
Cloudflare Tunnel 提供了一种免公网 IP 远程访问家用服务器的方法,配合 Cloudflare Zero Trust Dashboard,理论上可以通过 `cloudflared` 进程将 SSH 流量穿透到 Cloudflare,然后在外网访问。
但开始跟着官方教程研究以后,我就傻眼了。官方教程中的很多按键和界面选项在实际的当前版本中都找不到,而且配置过程非常复杂,茶老师也帮不到我,它给的方式都不适用于当前版本(说实话 Cloudflare 家的产品好像都有类似的问题,更新频率太快,文档跟不上)。我后来还不想放弃,跟着 YouTube 的教程研究看看能不能行,最后还是失败了。
于是我回想起来一开始想要解决的问题,为什么要 CF Tunnel 这么复杂的东西,我又不是想要在家里搭网站服务器,只是想要用 SSH,所以我选择用 Tailscale。
## 使用 Tailscale:低延迟 + 简单易用
首先简单介绍一下,Tailscale 基于 WireGuard,提供了一种零配置的内网穿透方式。它的优点包括:
- **P2P 连接**:尽可能实现点对点连接,不经过第三方服务器,延迟低。
- **自动 NAT 穿透**:不需要手动配置端口转发,能自动适配大多数网络环境。
- **支持多设备同步**:可以在多个设备上共享同一个 Tailscale 网络。
- **无需公网 IP**:适用于家庭宽带、校园网等环境(它提供的 IP 并不是一个公网 IP)。
### 在 Ubuntu 上安装配置 OpenSSH
Ubuntu 系统并不会预装 SSH,macOS 预装了。首先,确保你的 Ubuntu 机器上已经安装了 OpenSSH 服务:
```bash
ssh -V
```
如果是 `Command not found`,那么就需要安装(安装过了的话直接跳过这部分即可):
```bash
sudo apt update
sudo apt install openssh-server
```
等待安装结束后设置开机自启动:
```bash
sudo systemctl enable --now ssh
```
### 在 macOS 中生成 ssh 密钥(可选)
如果想要为你的 SSH 更加一层安全性,而且省去每次输入密码的麻烦,可以在 macOS 上生成 SSH 密钥(替换 `example@email.com` 为你的邮箱):
```bash
ssh-keygen -t ed25519 -C "example@email.com"
```
然后一路回车,生成密钥对。
在 macOS 中获取到你的公钥:
```bash
cat ~/.ssh/id_ed25519.pub
```
在 Ubuntu 机器上,将公钥添加到 `~/.ssh/authorized_keys` 文件中(替换 `your-public
-key` 为你的公钥):
```bash
mkdir -p ~/.ssh
echo "your-public-key" >> ~/.ssh/authorized_keys
```
最后修改你 Ubuntu 中的 SSH 配置文件,关闭密码登录,只允许密钥登录:
```bash
sudo nano /etc/ssh/sshd_config
```
找到下面的内容,删除 `#` 并修改为对应的值:
```plaintext
PasswordAuthentication no
PermitRootLogin no
PubkeyAuthentication yes
```
修改完成后,Ctrl `+` X -> Y -> Enter 保存并退出。
最后在你的 Ubuntu 中重启 SSH 服务:
```bash
sudo systemctl restart ssh
```
这样你就可以通过 SSH 密钥登录 Ubuntu 机器了(无需输入密码)。
### 在 Ubuntu 上安装 Tailscale
首先,在 Ubuntu 服务器上安装 Tailscale:
```bash
curl -fsSL https://tailscale.com/install.sh | sh
```
然后启用并登录:
```bash
sudo tailscale up
```
这时候需要用浏览器(不是必须 Ubuntu 里面的,任何设备都行)打开 Tailscale 提供的授权 URL,登录自己的账户(支持 Google、GitHub 等多种登录方式)。
授权完成后,它会自动告诉你当前机器的 IP,也可以在网页端 Dashboard 查看,当然你也可以手动查看:
```bash
tailscale ip
```
你会看到 Tailscale 分配的内网 IP(通常是 `100.x.x.x` 这样的地址),这个 IP 就是你在外面访问 Ubuntu 机器的地址。
### 在 Mac 上配置 VSCode 远程连接
> 如果你使用的是 Windows,可以参考 [Windows 下的官方安装教程](https://tailscale.com/download/windows),其他步骤基本一致。
在 MacBook 上,先安装 Tailscale:
```bash
brew install --cask tailscale
```
然后登录 Tailscale,确保 MacBook 也加入了同一个 Tailscale 网络(登陆同一个账号)。
接着,在 Mac 上测试 SSH 连接,`user` 是 Ubuntu 机器上的用户名,`100.x.x.x` 是 Tailscale 分配的 IP:
```bash
ssh user@100.x.x.x
```
如果能够成功连接,就可以在 VSCode 里安装 [Remote - SSH](https://marketplace.visualstudio.com/items?itemName=ms-vscode-remote.remote-ssh) 插件,并在 `~/.ssh/config` 里添加配置(可以通过左侧侧边栏里的 Remote Explorer 面板打开设置文件):
- `Host`:自定义的主机名,用于在 VSCode 里识别。
- `HostName`:Tailscale 分配的 IP。
- `User`:Ubuntu 机器上的用户名。
- `IdentityFile`:SSH 私钥文件路径(如果你通过 SSH 密码登录,可以省略)。
```plaintext
Host ubuntu-home
HostName 100.x.x.x
User user
IdentityFile ~/.ssh/id_ed25519
```
然后,在 VSCode 里打开 **Remote Explorer**,选择 `ubuntu-home` 连接,就可以在 VSCode 里无缝操作家里的 Ubuntu 机器了。
## 总结
使用 Tailscale 连接后,SSH 基本上像在局域网内一样,并不会有明显的延时,你当然也可以通过 Terminal 直接去连接 SSH,不是非得通过 VSCode(我使用 VSCode 只是因为我基本只用它作为我的 IDE)。配置非常简单快捷,不需要手动配置太多东西,总共也就是几分钟的事情,而且也是免费的。
---
https://zla.pub/2024-annual-summary
---
#2024年度总结
> 2024年是充满惊喜与挑战的一年,有搬家跨越8州的波澜,也有漫步咖啡香的惬意时光;从学业到旅行,每一步都不断积累收获🌸。从延续番剧打卡到写作开源项目,从尝试各种咖啡器具到探寻各地美食,无论旅途还是日常,都在享受与探索中前行。愿即将到来的2025能携更多惊喜与成就,一起加油鸭🥳~(ChatGPT o1 生成)
## 前言
去年的年度总结我在写完后回看发现基本变成了《2023 番剧导视》,所以今年会避免这个情况,更偏向于“总结”。我可能会在 25 年 1 月出一个单独的 2024 番剧导视总结,同样我也会在 SuzuBlog 中增加一个专门的番剧导视栏目的功能。
我当前的主力装备先列一下,以供参考:
- MacBook Pro 16寸 2021 M1 Max 32G + 1TB
- iPhone 14 Pro Max
- iPad Pro 11寸 2021 M1
- AirPods Pro 2
- Apple Watch Series 6
- Dell U2720QM 27寸 4K 显示器 + LG 27US500-W 27寸 4K 显示器
- ASUS ROG Azoth 白夜魔 75\% 白轴
- Razer Viper V2 Pro 雷蛇毒蝰 V2 Pro 白色
## 娱乐
### 电影
今年一共看过 17 部电影,其中院线 11 部(2 部在美国看的,9 部在国内看的)。先报菜名:
1. 功夫熊猫4(3/19 - **3/5** - Irvine, CA)
2. 头脑特工队2(6/26 - **4/5** - 西安,陕西)
3. 神偷奶爸4(7/15 - **3/5** - 青岛,山东)
4. 你的名字(7/19 - **5/5** - 青岛,山东)
虽然这是二映,但是我第一次看。之前尝试看了几次,开了一点头却感觉自己在家看有点暴殄天物了,所以就在等机会。这次二映毫不犹豫买了 IMAX。哭得稀里哗啦,我预料到了这种情况多拿了一些纸,但还是不够。我今年看过的电影中最推荐的,强烈推荐。(在看电影的 1 年前我就去圣地巡礼了)
5. 龙卷风(7/20 - **4/5** - 青岛,山东)
6. 蓝色禁区:凪(8/19 - **3/5** - 青岛,山东)
7. 名侦探柯南:百万美元的五棱星(8/17 - **4/5** - 青岛,山东)
8. 航海王:强者天下(8/24 - **4/5** - 青岛,山东)
9. 通往夏天的隧道,再见的出口(8/30 - **4/5** - 青岛,山东)
这部在出电影前,我本来打算看原著轻小说的,但一直没顾上,没想到碰巧今年上映了。我自己也有妹妹,某些感受会更深一些,正在补原著小说。
10. 转生大作战(8/31 - **4/5** - 青岛,山东)
11. 暮然回首(10/7 - **4/5** - Skokie, IL)
我需要吐槽一下,本来这蛮好一电影,这场坐满了,周围全是美国人。美国人的笑点,我完全理解不了,就对于我丝毫不想笑的点全场都在疯狂笑。体验很差,导致我的观影体验也受影响了。
12. 2:1(10/21 - **3/5** - Chicago, IL)
芝加哥电影节上看的,看完以后导演给大家发东德废除的纸钞,真钱,我拿了一张 500 的,这蛮有意思。但电影本身,可能是我对于这段历史的了解不够多,大概能够理解它想要表达的意思,但说实话不足够吸引我。
然后是非院线(今年没有在电影院中出现的):
1. 让子弹飞(7月 - **5/5** - BiliBili)
这不申遗?各种梗一直很熟悉,也看了无数的片段,但一直没有完整看过一遍,这次终于看完了。
2. 知晓天空之蓝的人啊(9/2 - **5/5** - 不可说)
也算是补番,在回洛杉矶的飞机上看的,当时写的影评如下:”成年人遭社会毒打磨平了棱角、磨掉了梦想和希望“
3. 尖峰时刻(12/26 - **5/5** - BiliBili)
成龙的电影,给到这个分数有很大程度的情怀成分,怀念南加冬日的温暖和生活习惯,来了芝加哥感觉还是南加更舒服。电影中熟悉的街道、熟悉的口音,让我感觉回到了加州。
4. 尖峰时刻2(12/26 - **4/5** - BiliBili)
5. 尖峰时刻3(12/27 - **3/5** - BiliBili)
6. 环游地球八十天(12/27 - **3/5** - BiliBili)
### 番剧
???今年的番剧简直依托,对比去年的盛况,今年非常拉胯,我很难受🥲。
我从 11 月开始将所有番剧记录放到了 AniList 上,欢迎关注哦~包括我的评分和简短评价。[我的 AniList Profile](https://anilist.co/user/zlasica/)
#### 年度推荐
1. 迷宫饭(1月季度 - **5/5**)
2. Girls Band Cry/哭泣少女乐队(4月季度 - **5/5**)
又名中指🖕乐队(不是
3. 我推的孩子 第2期(7月季度 - **5/5**)
4. LoveLive! SuperStar!! 第3期(10月季度 - **4/5**)
让我们说中文(no)让我们说上海话(yes)
5. 新 乱马1/2(10月季度 - **5/5**)
没有情怀加持,是我第一次看,OP 满分,剧情非常独特,和现在常见的番剧风格有所区别。经典重制,节奏很独特、笑点密集,和现在常见番的叙事风格差异很大。
#### 值得一看
1. 我心里危险的东西 第2期(1月季度 - **4/5**)
恋爱番,看完 1 再看 2。我个人觉得不如蓝箱(10 月季度)吸引我。
2. 我独自升级(1月季度 - **4/5**)
3. 欢迎来到实力至上主义的教室 第3期(1月季度 - **4/5**)
4. 为美好的世界献上祝福 第3期(4月季度 - **4/5**)
阿克西斯教团~
5. 地下城里的人们(4月季度 - **4/5**)
地下城居然是有人运营的,魔物居然都是打工人(设定蛮有意思)
6. 悲喜渔生(10月季度 - **4/5**)
把说中文的部分去掉会更好,适合钓鱼佬。对于其中钓鱼的部分我不是很感兴趣,但是对于主角的人物塑造和人生经历还蛮有意思。
7. 关于地球的运动(10月季度 - **4/5**)
中世纪教会与科学观念的冲突,也包含对“谁能拥有知识/发声”的讨论,主角活不过3集。
8. 青春之箱 (蓝箱)(10月季度 - **4/5**)
青春校园运动恋爱番,前段比中后段好,不知道为什么中后段开始拉胯 PPT 了。
9. Re:从零开始的异世界生活 第3期(10月季度 - **4/5**)
8 集,就 8 集,然后就要等到明年啊啊啊。
10. 魔王2099(10月季度 - **4/5**)
魔王一觉醒来发现是 2099 年了,信仰之力丧失,现代化科技的世界。世界观蛮有意思,魔王有点中二。
### 阅读
今年一共看了 3 本书(都在微信阅读)欢迎关注我哦~:
1. 《聪明的个人成长》(**4/5**)
这本书是比较典型的心灵鸡汤类,但对于当时的我来说帮助还是蛮大的。这类书的内容不要指望能够 100\% 的内容都有帮助,到底多少有用非常取决于个人。大概其中有 50-60\% 的内容对我来说是有效的。
2. 《癌症密码》(**5/5**)
这本书是一本比较直接了解当前癌症和生存状态的书。书中介绍了癌症发病原理、地区差异、预防、治疗策略等众多方面的内容。
3. 《蛤蟆先生去看心理医生》(**4/5**)
一本简单的心理学入门级别读物,清晰简洁介绍了心理学概念和如何应用心理学知识去调节自己的心里状况和健康。
### 游戏
今年基本没有玩什么游戏,依旧是 OW(守望先锋)和 City Skyline 2。Switch 的话就年底和朋友一起玩了一下 Splatoon 3。
期待明年的《死亡搁浅 2》,1 我大概玩了 70 个小时左右,就是部分内容比较恐怖我只敢开最低的 BT 级别,但整体游戏非常有趣。
### 电子产品
今年主要购入了 2 个大件,还是简述一下了就
1. ASUS ROG Azoth - ROG 白夜魔 (5月 - \$ 217)
这把键盘是为了替换我之前的雷蛇全尺寸的有线粉晶黑寡妇 V3。全尺寸真的太大了,非常占地方,非常沉,有线键盘也会显得桌面比较乱。趁着这次搬家的机会,便买了这把新的键盘。
ROG 的白夜魔应该名声不小的,75\%,对 mac 也很友好(可以一键切换键位),非客制化键盘的天花板了属于是,客制化也非常方便,官方自带了一套工具(我就用的原装的)。键盘非常好看,纯白色的键帽搭配银色的底,适合纯白桌面定制。
白夜魔对比黑夜魔轴体的选择多了 NX 雪武白轴(线性)、NX 冰爆灰轴(段落)两款,我选择的是白轴。这款轴体触发行程比较低,更加适合 OW 这类 FPS 游戏。而且因为是线性轴声音也比较小,如果非独居推荐不要选择段落轴。
2. LG 27US500-W 27-Inch 4K(11月 - \$ 195)
黑五的时候购入的新显示器,不是很推荐,但对于这个价格来说不会太差。作为副屏来说足够用了,如果想要一个主屏的话不要选择这款。峰值亮度较低、色准不是很好,屏幕整体颜色泛白(不管是对比我 MBP 的自带屏还是我的主力屏 Dell U2720QM)。
### 咖啡
在之前我基本只会喝 Nespresso 的胶囊,今年开始染上了手冲。目前我使用的装备是:
- 滤杯:Hario V60 01、Origami 硅脂蛋糕杯
就这两只,用的比较多的还是 V60,Origami 就如我朋友所说:”这滤纸贴不齐很难受啊“所以比较少用。
- 滤纸:MOLA 01 麻纤维、Kalita 蛋糕滤纸
我试了一下 MOLA 的原色纸的版本,纸味蛮大的还是推荐用麻纤维款。V60 也可以给 Origami 用很方便(就是容易贴不齐)。
- 称:淘宝几十块钱的小称
A称真有点贵...我这个小称带注水自动计时,还蛮准,足够了。
- 手磨:C40
确实不一样,我一开始用的泰摩的 C3S,那把也蛮不错(白色款非常好看),C40 会把豆子风味放大(好坏都会),更加接近平刀的效果。
- 壶:Fellow Stage EKG Pro
F 壶比 B 壶好看(个人观点),虽然粉色的那只买不到了已经,但安慰自己壶时间长会脏,白色相对耐脏一些。这只壶烧水速度还算蛮快的,壶嘴角度很重要,可以轻松维持小水流垂直注水。
手冲是我回来美国才开始的,在大陆家里有一台全自动意式机还算可以。大概回来 3 个多月喝了 3kg 左右的豆子,喝的最多的产区是埃塞俄比亚耶加雪菲、肯尼亚、哥伦比亚。
耶加雪菲的庄园和小农合作社非常多,整体口感偏向于柑橘类果香,带有一些热带水果的甜感,部分庄园的豆子酸度可能会过高。肯尼亚的偏向于 明亮的莓果酸质和黑加仑等浓郁果香,甜感饱满且层次分明,酸质清晰如柑橘类果汁般清新。哥伦比亚的会有 柔和的果酸,带红苹果或甜橙的风味,同时伴随着焦糖、牛奶巧克力般的甜感和丝滑的口感,整体非常平衡、优雅。
## 生活
### 衣
因为从 Irvine 搬家来了 Evanston,这冬天从零上 10 来度降到零下 10 多度。我之前在 Irvine 是完全没有冬装的,冬天也是短袖加外套。为了适应芝加哥的冬天,补了一大波冬装。有人会问:“你不是青岛人吗?那不是北方城市吗?”咱先不说别的,青岛冬天也不会到零下十几度啊喂,而且我读本科就来 Irvine 了,总不能让我把高中初中的衣服翻出来吧🤣。
芝加哥的冬天我目前体验下来大概是零下 10 度到零下 20 度,我购入了长款羽绒服、保暖内衣、加绒裤子、加绒上衣等等各种衣服,推荐参考小红书(我不是穿搭博主)。但花费是不低的,年底最大的一笔开销基本都花在衣服上了。
### 行与食
#### 年度最佳餐厅
上海-人和馆(**5/5**)
[米其林官网](https://guide.michelin.com/sg/zh_CN/shanghai-municipality/shanghai/restaurant/ren-he-guan-zhaojiabang-road)
在此之前,我对于米其林这个评级是没有很看重的,去年在日本和香港分别都尝试过米其林一星的餐厅,但实际吃下来,并没有比我心里那些“很好吃的店”高出太多。
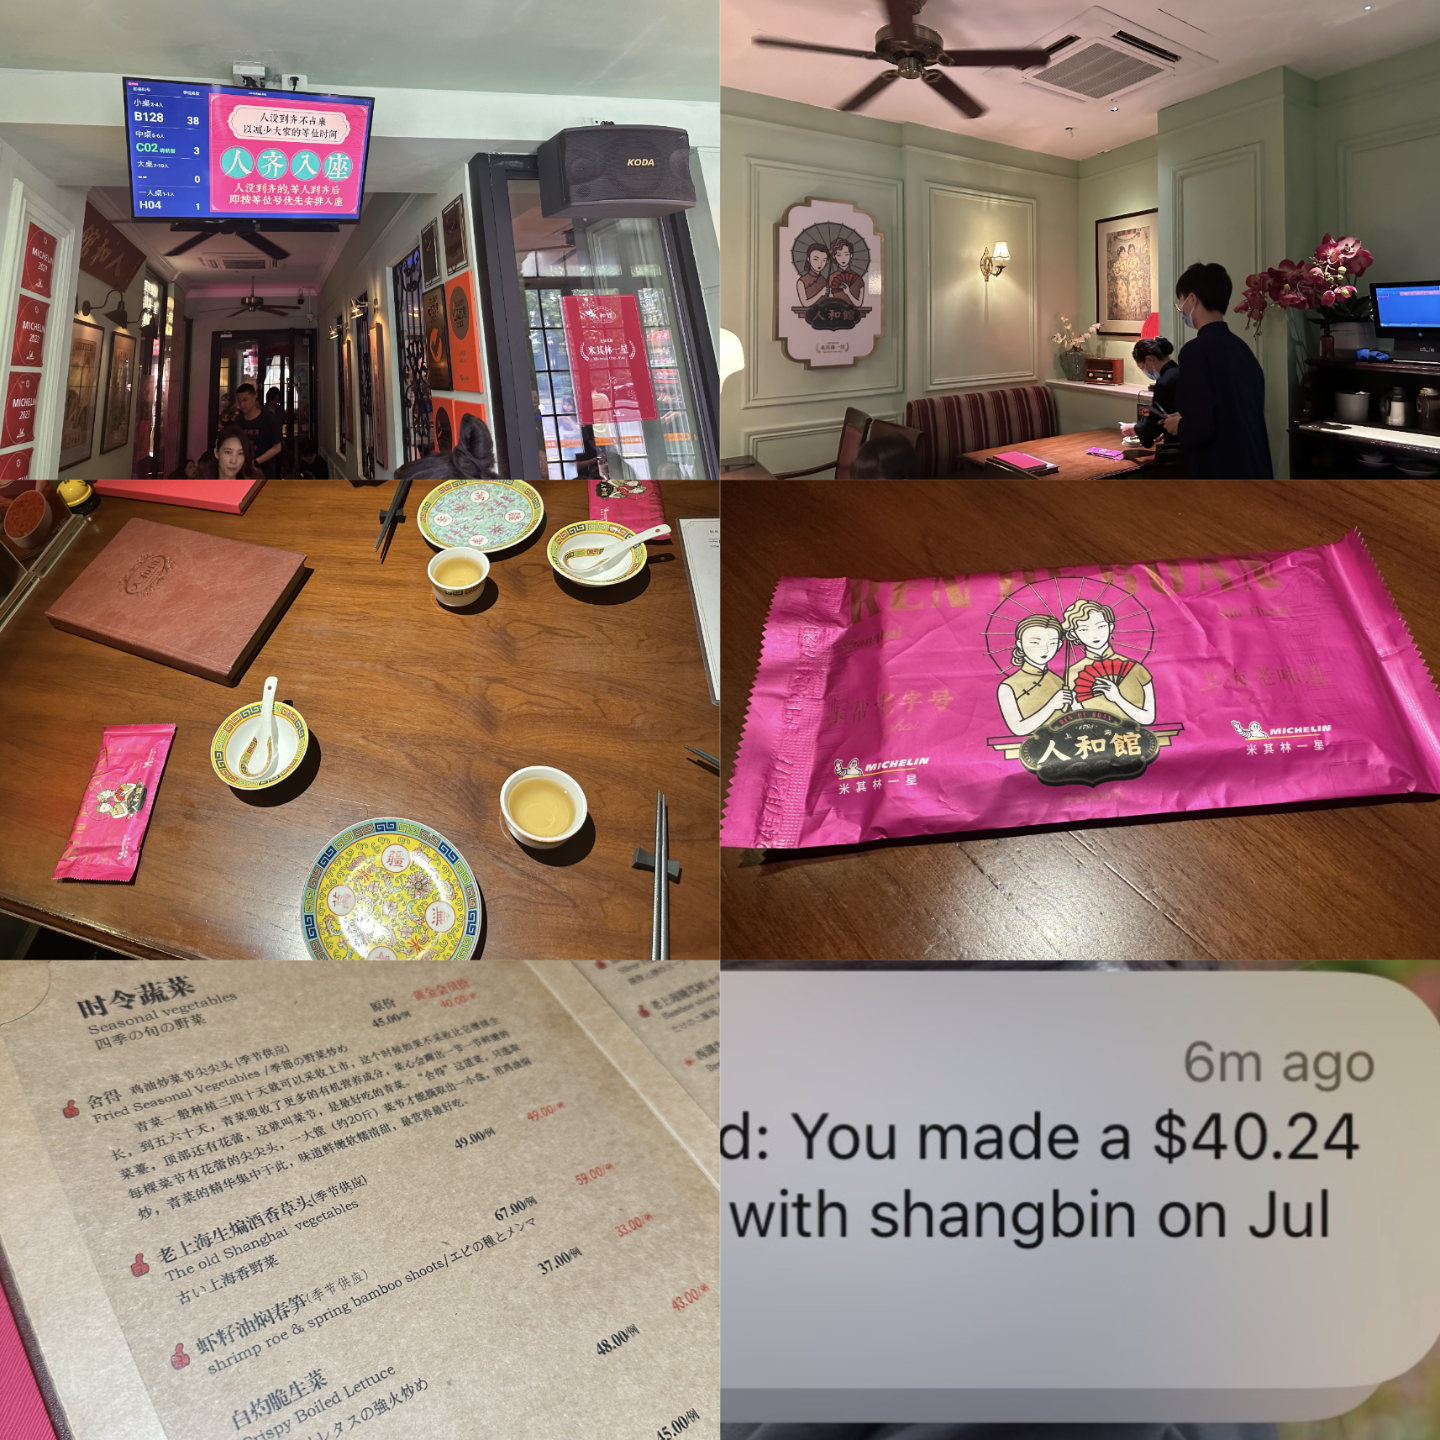
这家店其实是我们早上在隔壁的一家面包店吃完面包甜点以后,看到隔壁有这家餐厅在大众点评上评分很高,价格看起来也不算太高。恰巧我朋友她要赶着去虹桥回北京,我晚上也要赶着去虹馆看 BML,就把这里作为了晚餐的选择(下午2点多)。来了以后才知道是非常出名的的米其林一星和黑珍珠一钻。 后来我们才得知这里平常排队非常久,可能要好几个小时。我们来的并不是一个饭点,人不多,大概排了二十几分钟便进去了。虽然是米其林一星,但是环境并没有很奢华,环境就是普通上海餐厅的样子。
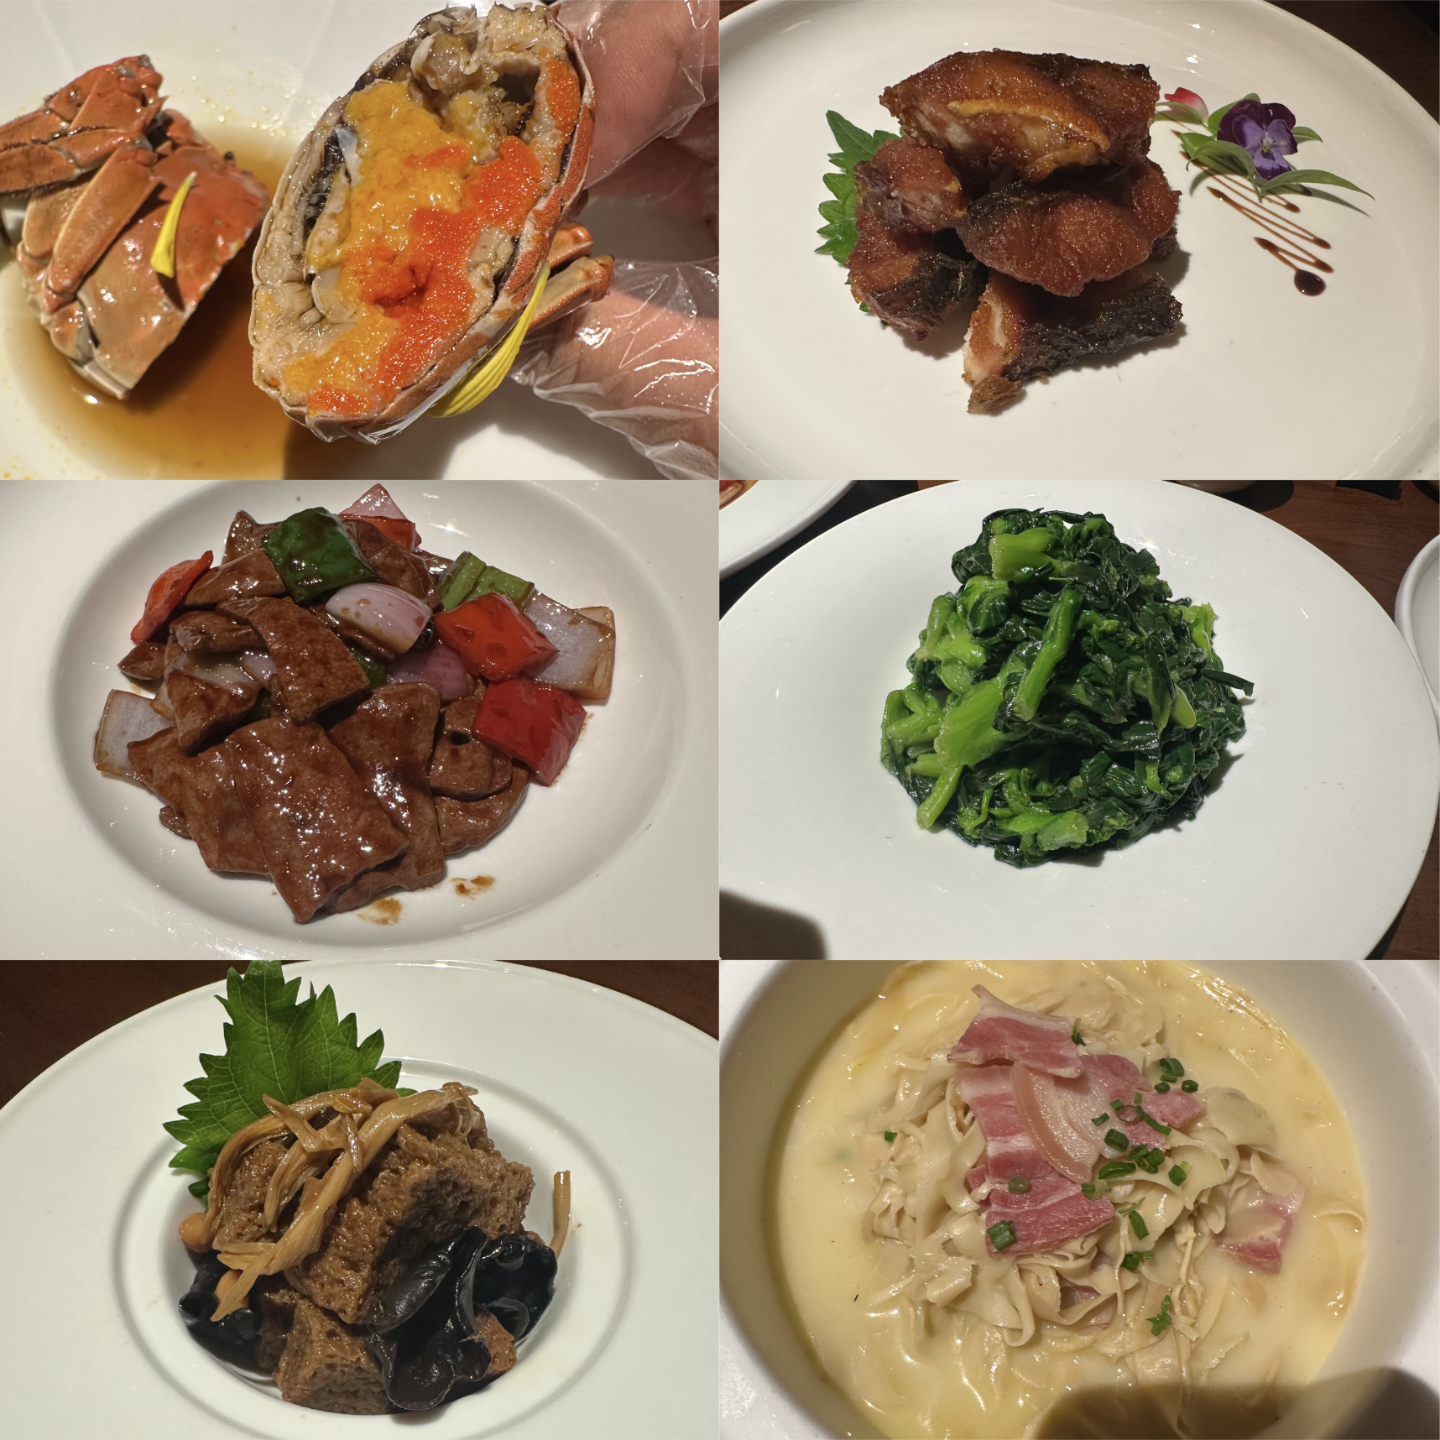
我们两个人一开始只点了 4 个菜,分别是一只醉蟹、熏鱼、炒肝、舍得,外加一个饮品。
醉蟹非常肥,黄非常多;熏鱼也很肥、很香、非常脆,骨头都酥脆到极致;炒肝很滑嫩,完全没有内脏的腥膻味;舍得本质是鸡油炒菜心,本来我们还吐槽说花 45 点一盘炒青菜这才叫舍得,但实际上是舍得把菜外面的老叶子摘掉留下最嫩内心的意思,鸡油炒的菜心非常香,很嫩,值得这个价格(比香港便宜)。但我们因为晚上都要忙,为了能撑更久,我们又追加了四喜烤麸和笋腌肉。烤麸本身非常鲜香,即使用了大量腌料依旧不咸不腻,保留了烤麸本身的质感和味道;笋腌肉中使用的是笋切成大片薄片,配合熏肉的香味,非常鲜香。
两人吃撑 6 道菜,一共才花费了 40 美元,非常划算,是完全可以接受且合理的价格。
#### 旅游
今年可算是把这几年欠的旅行一次补上了,过去几年因为疫情(去年因为暑假在香港做暑研)没有什么机会旅游。
还是报菜名先:
1. 大陆(11 个省、13 个城市):青岛济南不算(自己家)、西安、兰州、青海(西宁、茶卡、祁连)、南京、苏州、上海、武汉、长沙、成都、重庆、北京
2. 美国(10 个州):加利福尼亚(CA)、内华达(NV)、亚利桑那(AZ)、犹他(UT)、科罗拉多(CO)、内布拉斯加(NE)、爱荷华(IA)、威斯康星(WI)、印第安纳(IN)、伊利诺伊(IL)
3. 哥伦比亚(2 个城市):波哥大(Bogotá)、麦德林(Medellín)
##### 大陆境内游
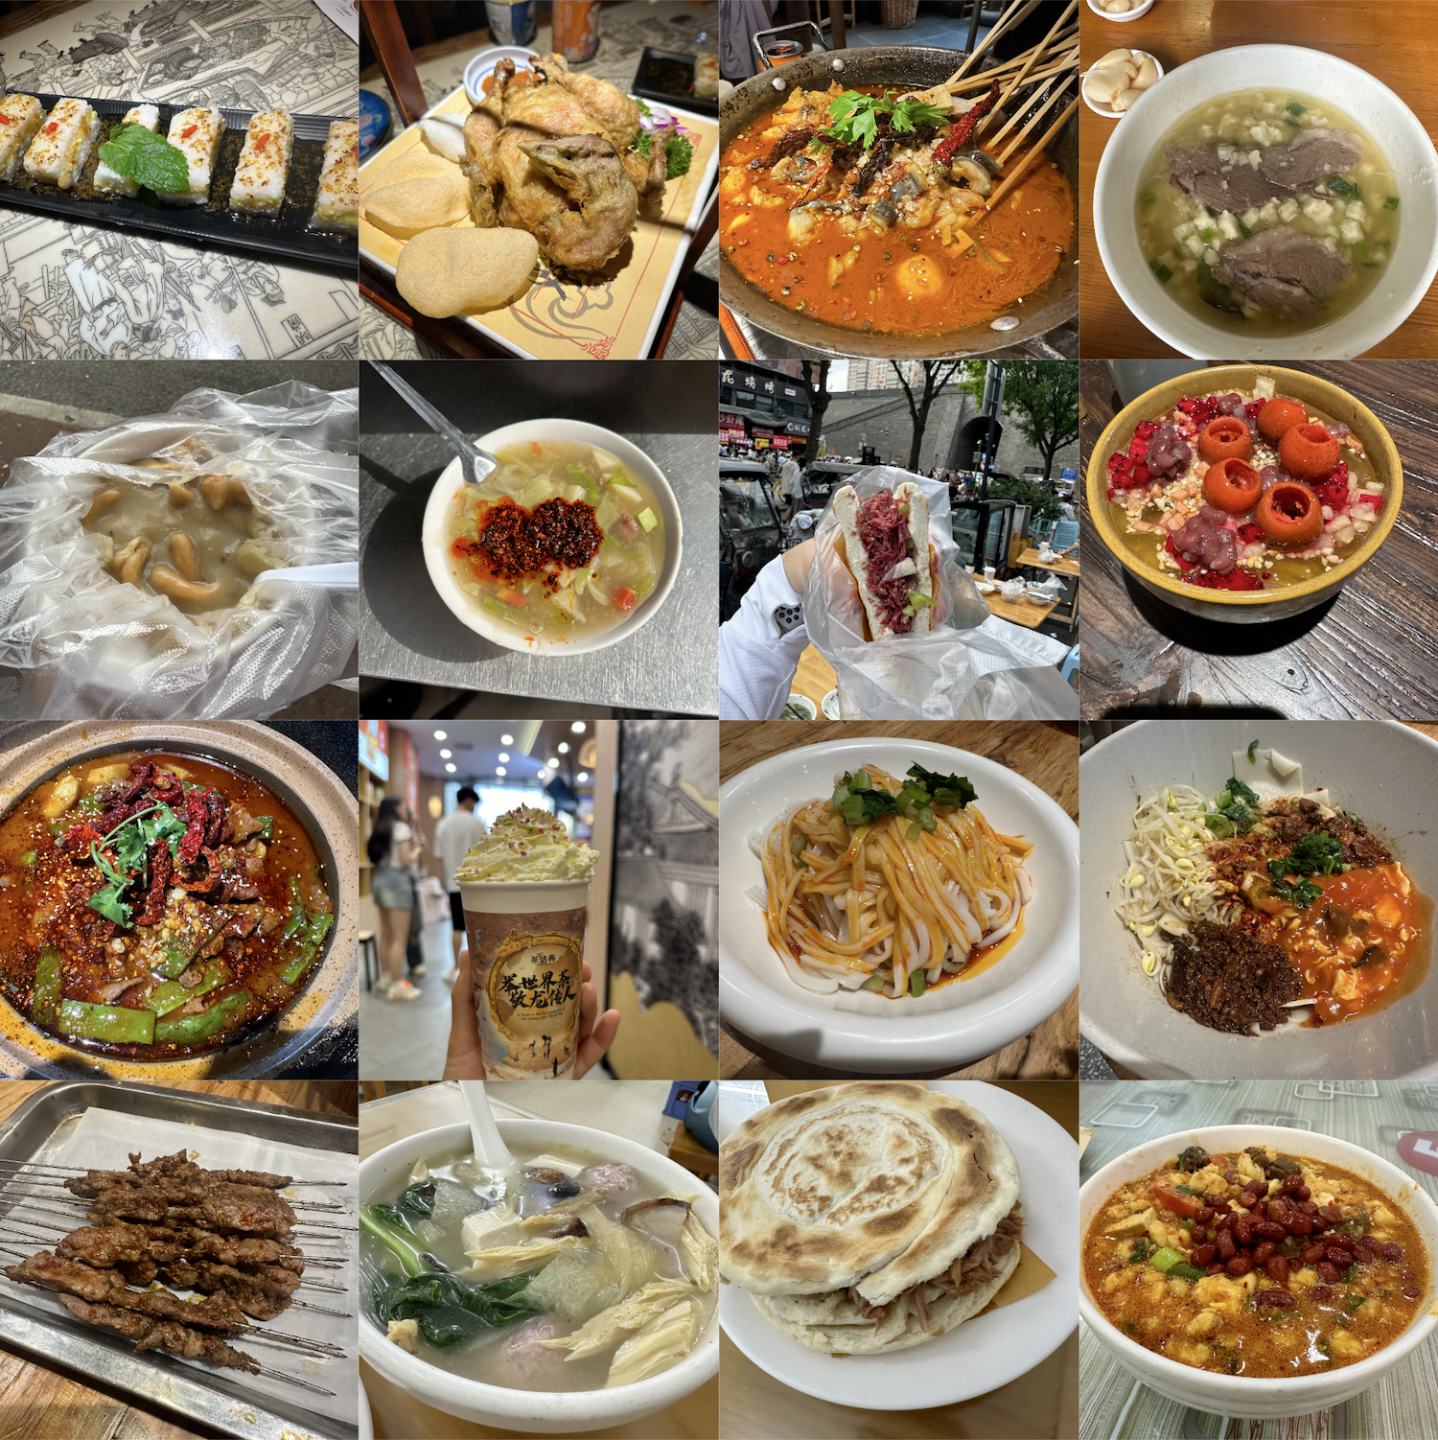
这趟主打就是吃,其他都是次要的,行程核心只有一个:吃
在南京第一次喝到茶颜悦色,直接上头,后续在重庆、武汉、长沙基本以一天 2-3 杯的量把他们家所有饮品全都喝了一遍。茶颜悦色的其他 4 个品牌(小神闲、古德墨柠、鸳鸯咖啡、昼夜诗酒茶)也都在长沙喝了一遍,都非常好喝。他们家的小零食也非常好吃,价格也不贵,直到回了美国我还在买他们家的零食海运过来。
成功去了今年的 BW 和 BML,在这方面没有留遗憾(去年没抢到票是真难受啊喂,去年 BML 可是有 milet 的现场啊喂)。
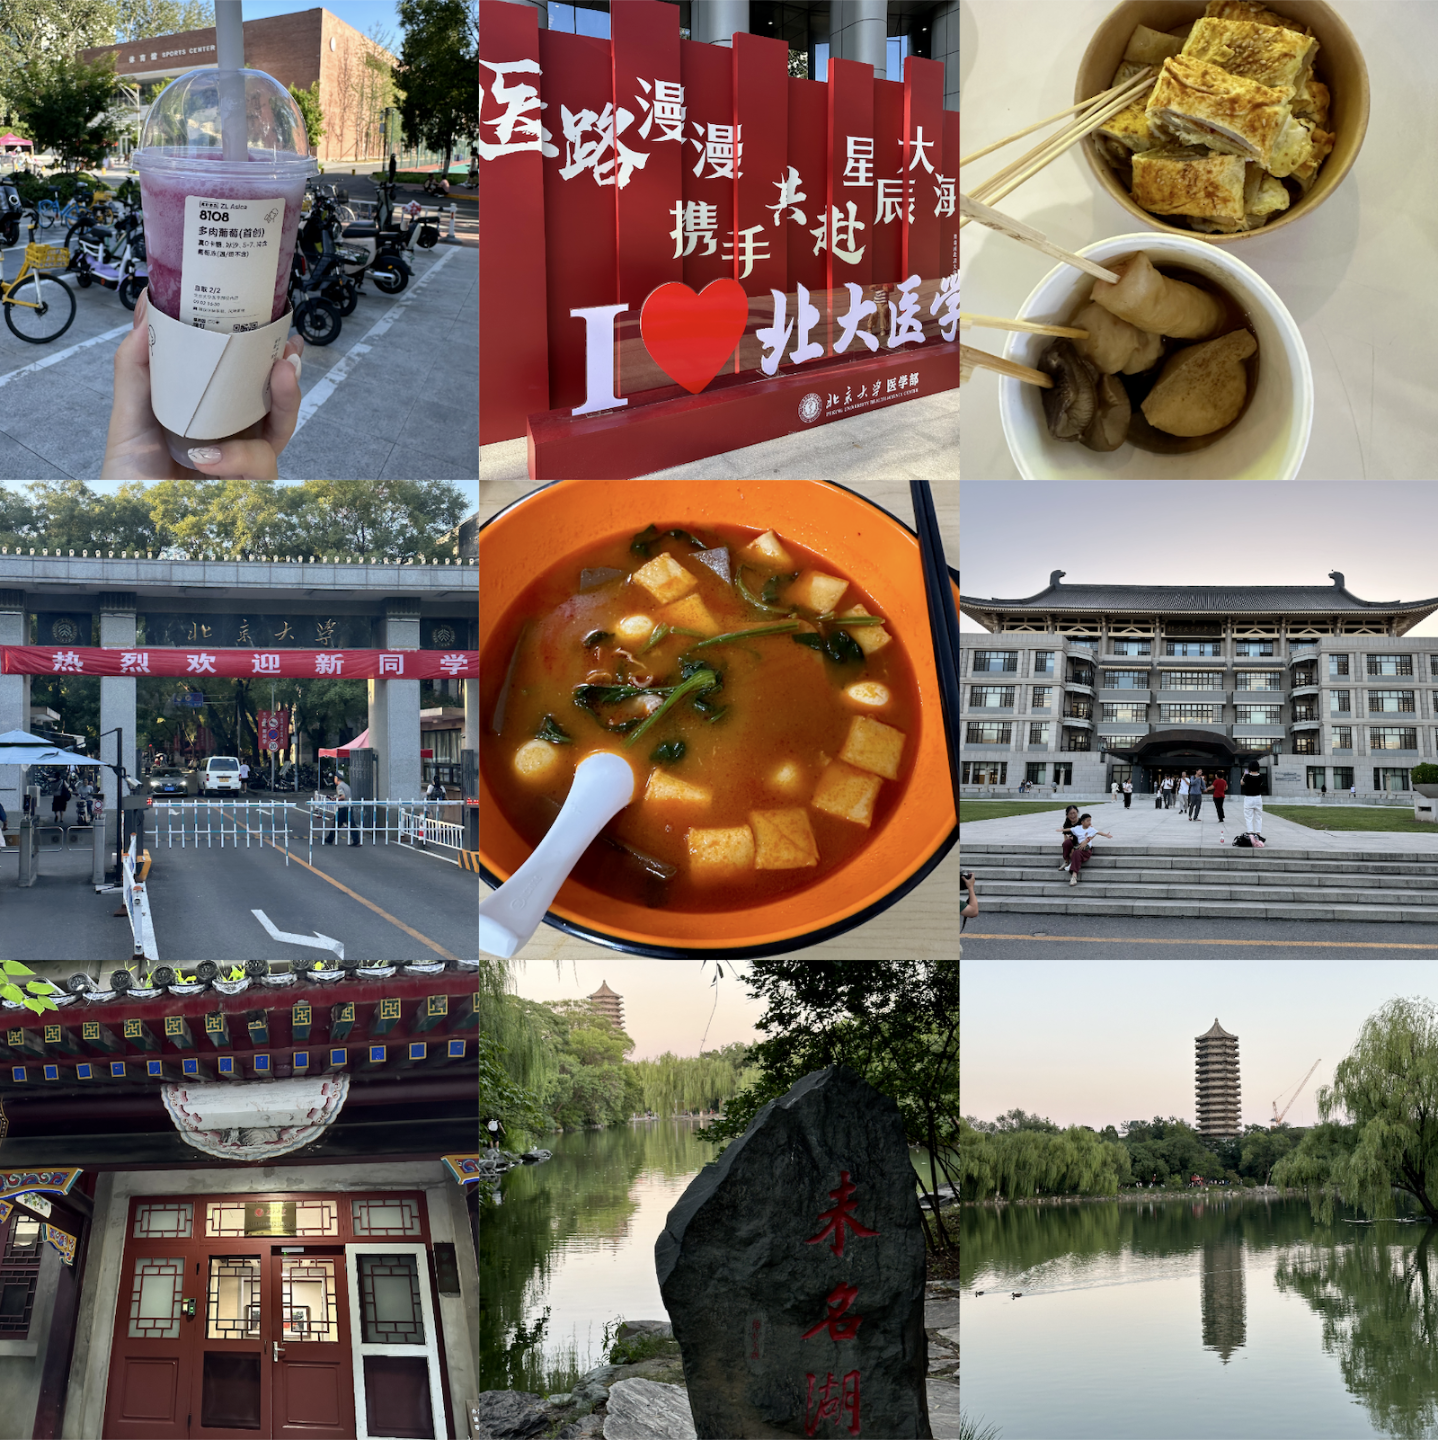
回美国的时候从北京转机,趁机让前面提到多次这个好姐妹带我去北京大学逛了一圈,顺便在医学部的喜茶喝了最后一杯国内的喜茶,也是吃到了久违的数年没吃到关东煮,还有北大燕南食堂里的不要麻不要辣的麻辣烫。
###### 陕西-西安
###### 甘肃-兰州
###### 青海
###### 江苏-南京、苏州
###### 上海
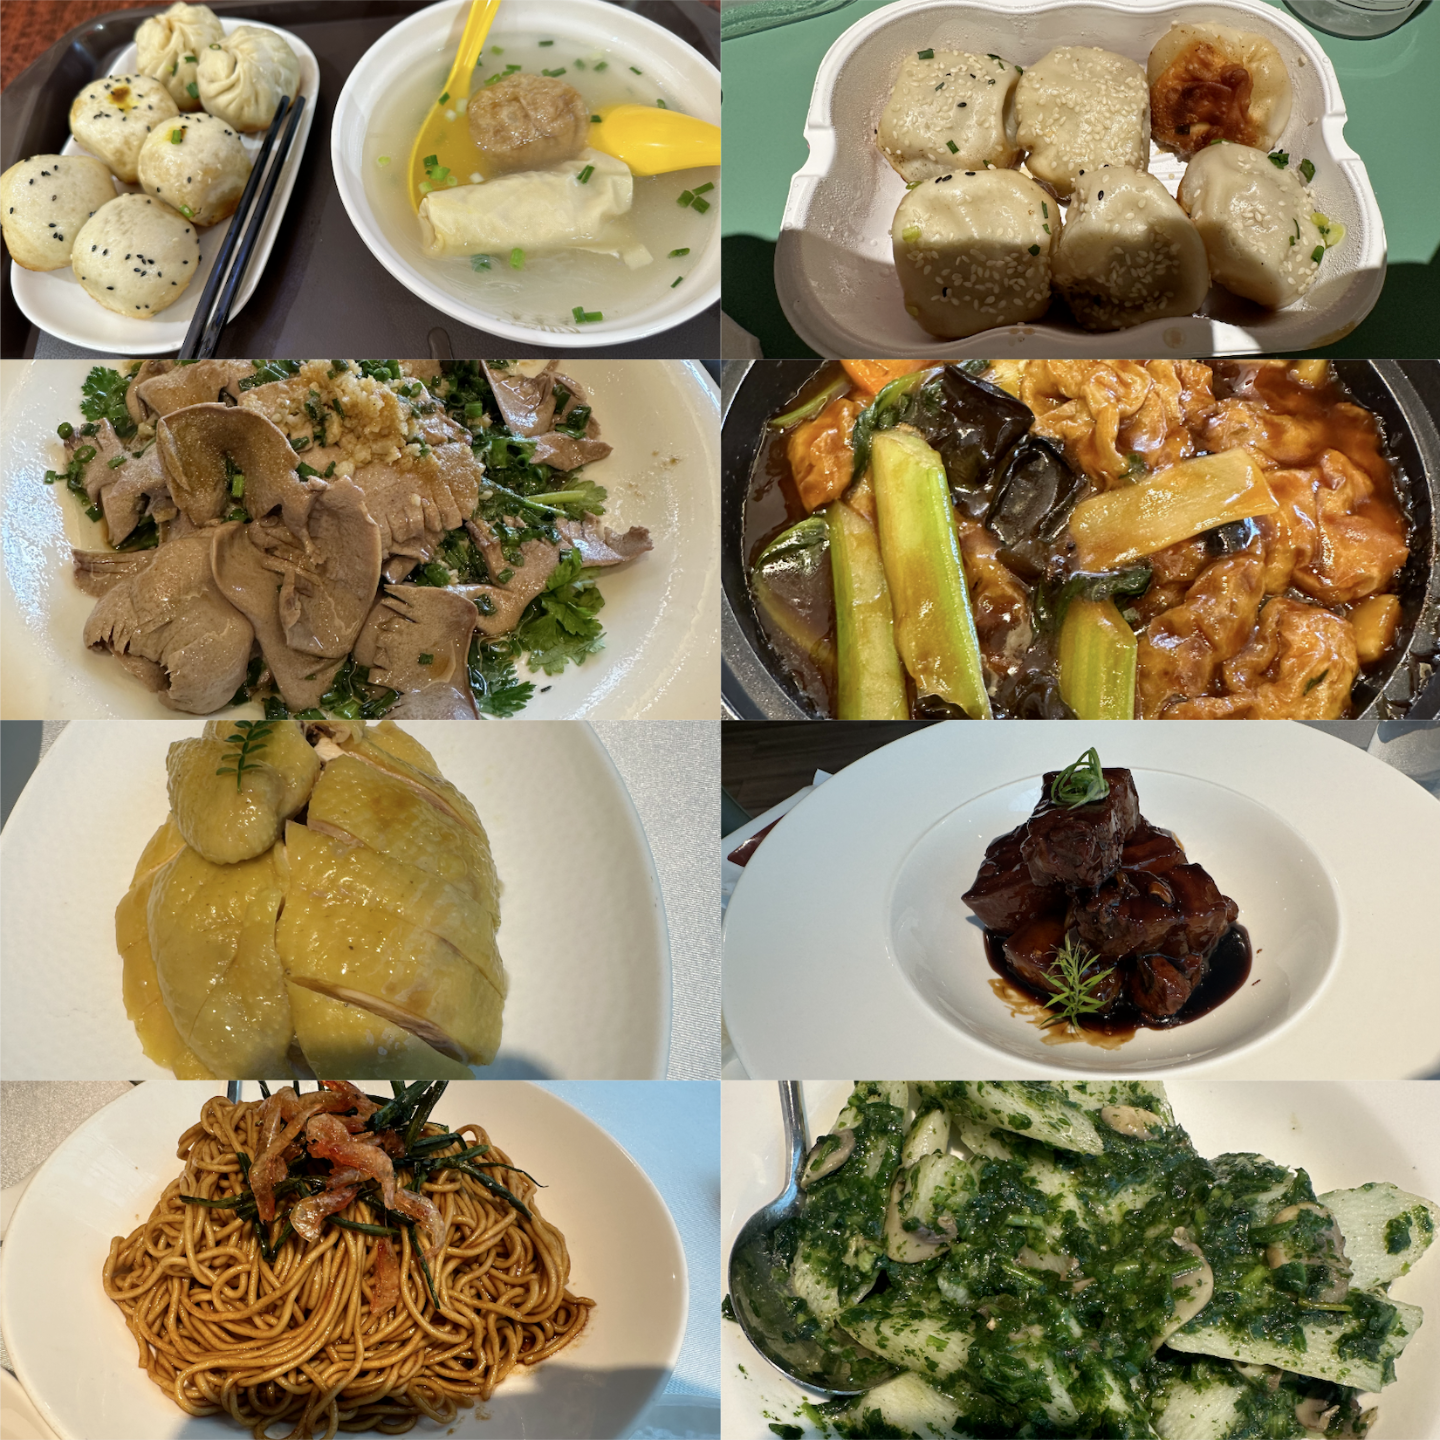
###### 湖北-武汉
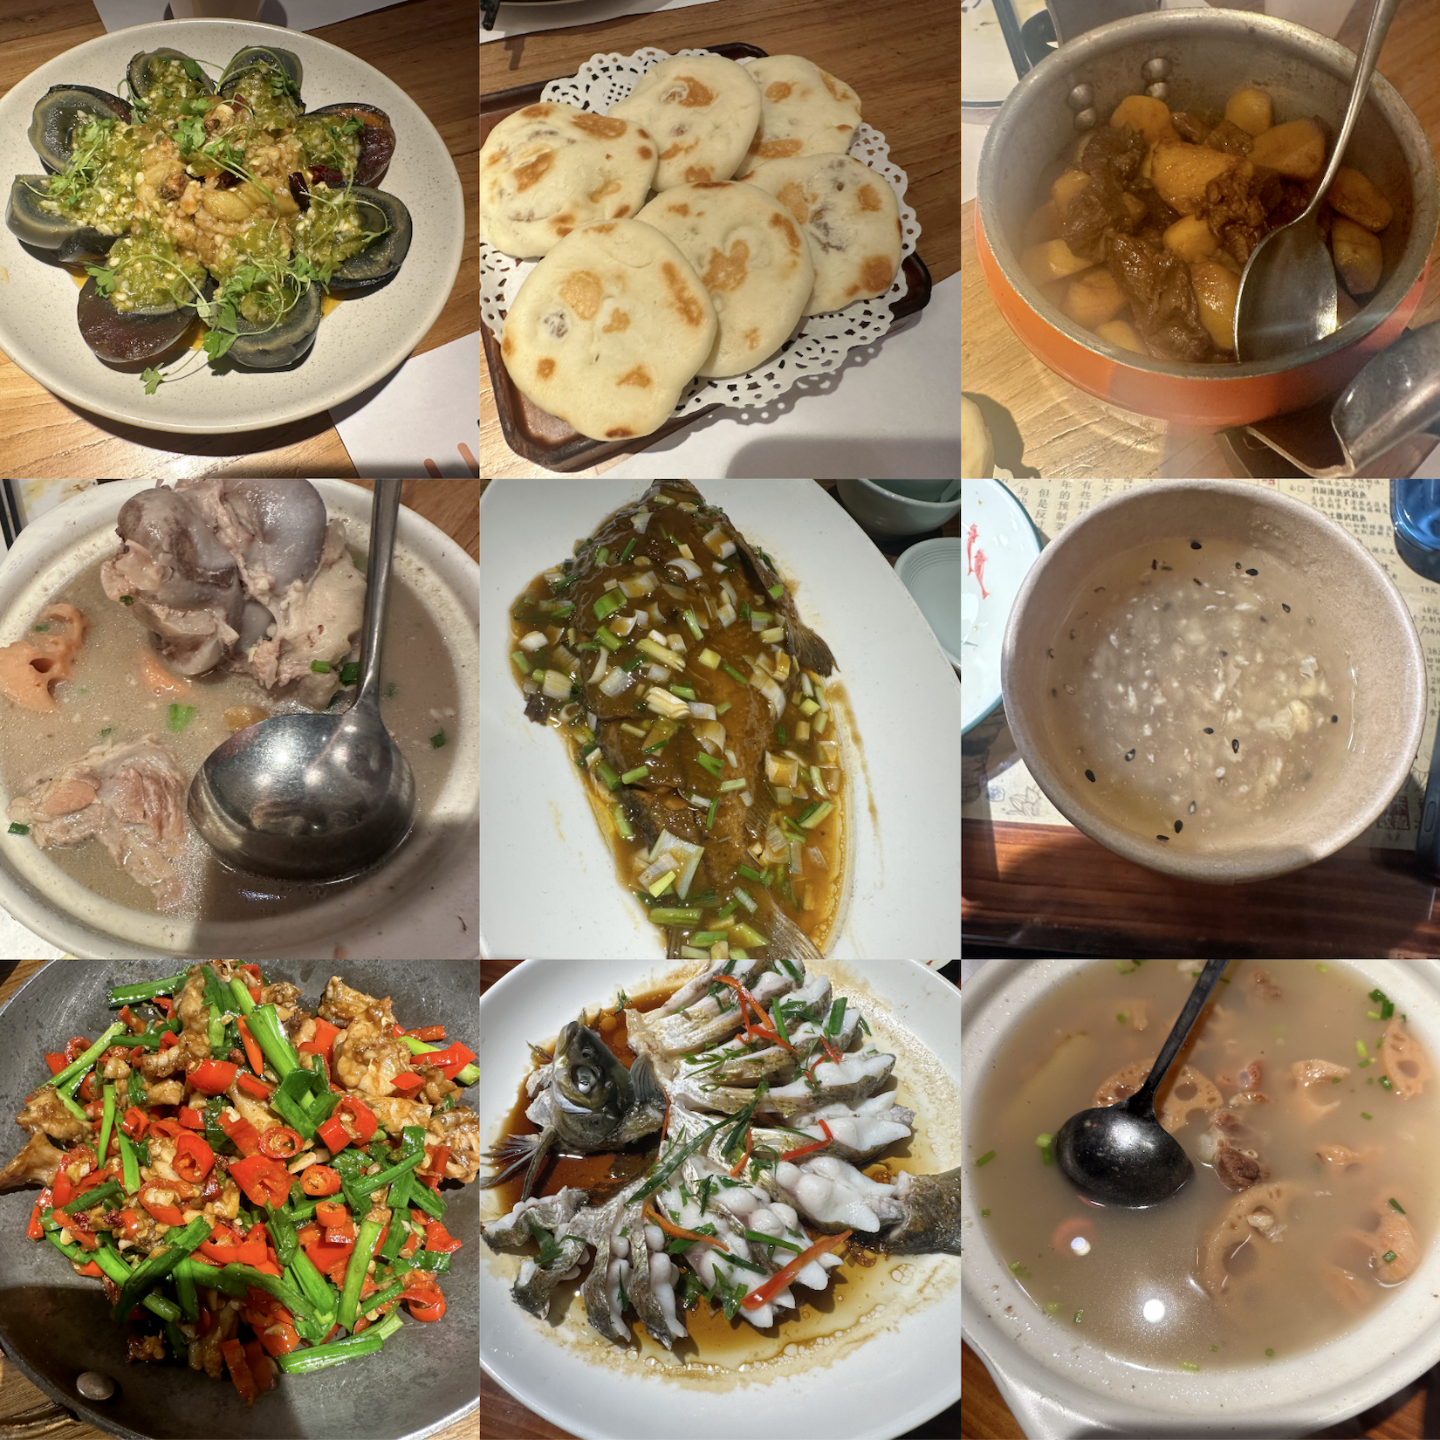
###### 湖南-长沙
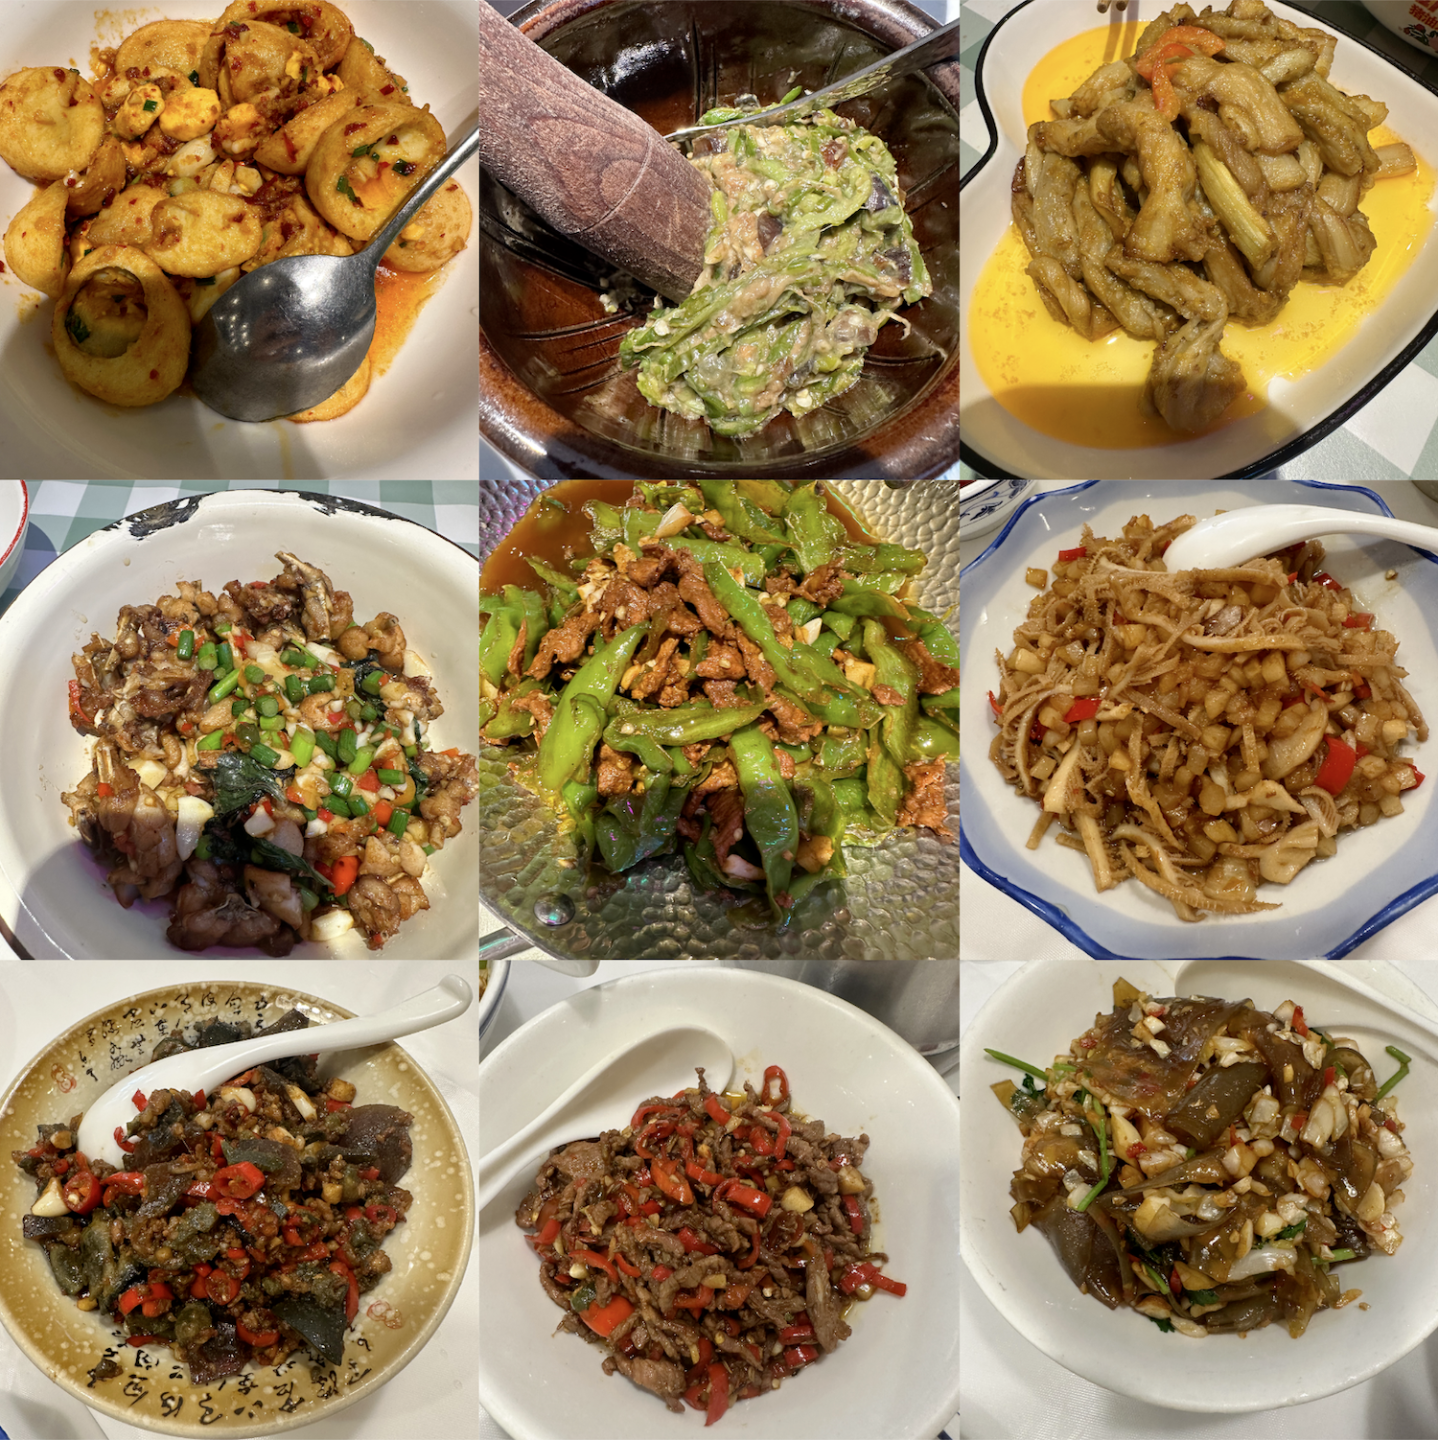
###### 四川-成都、重庆
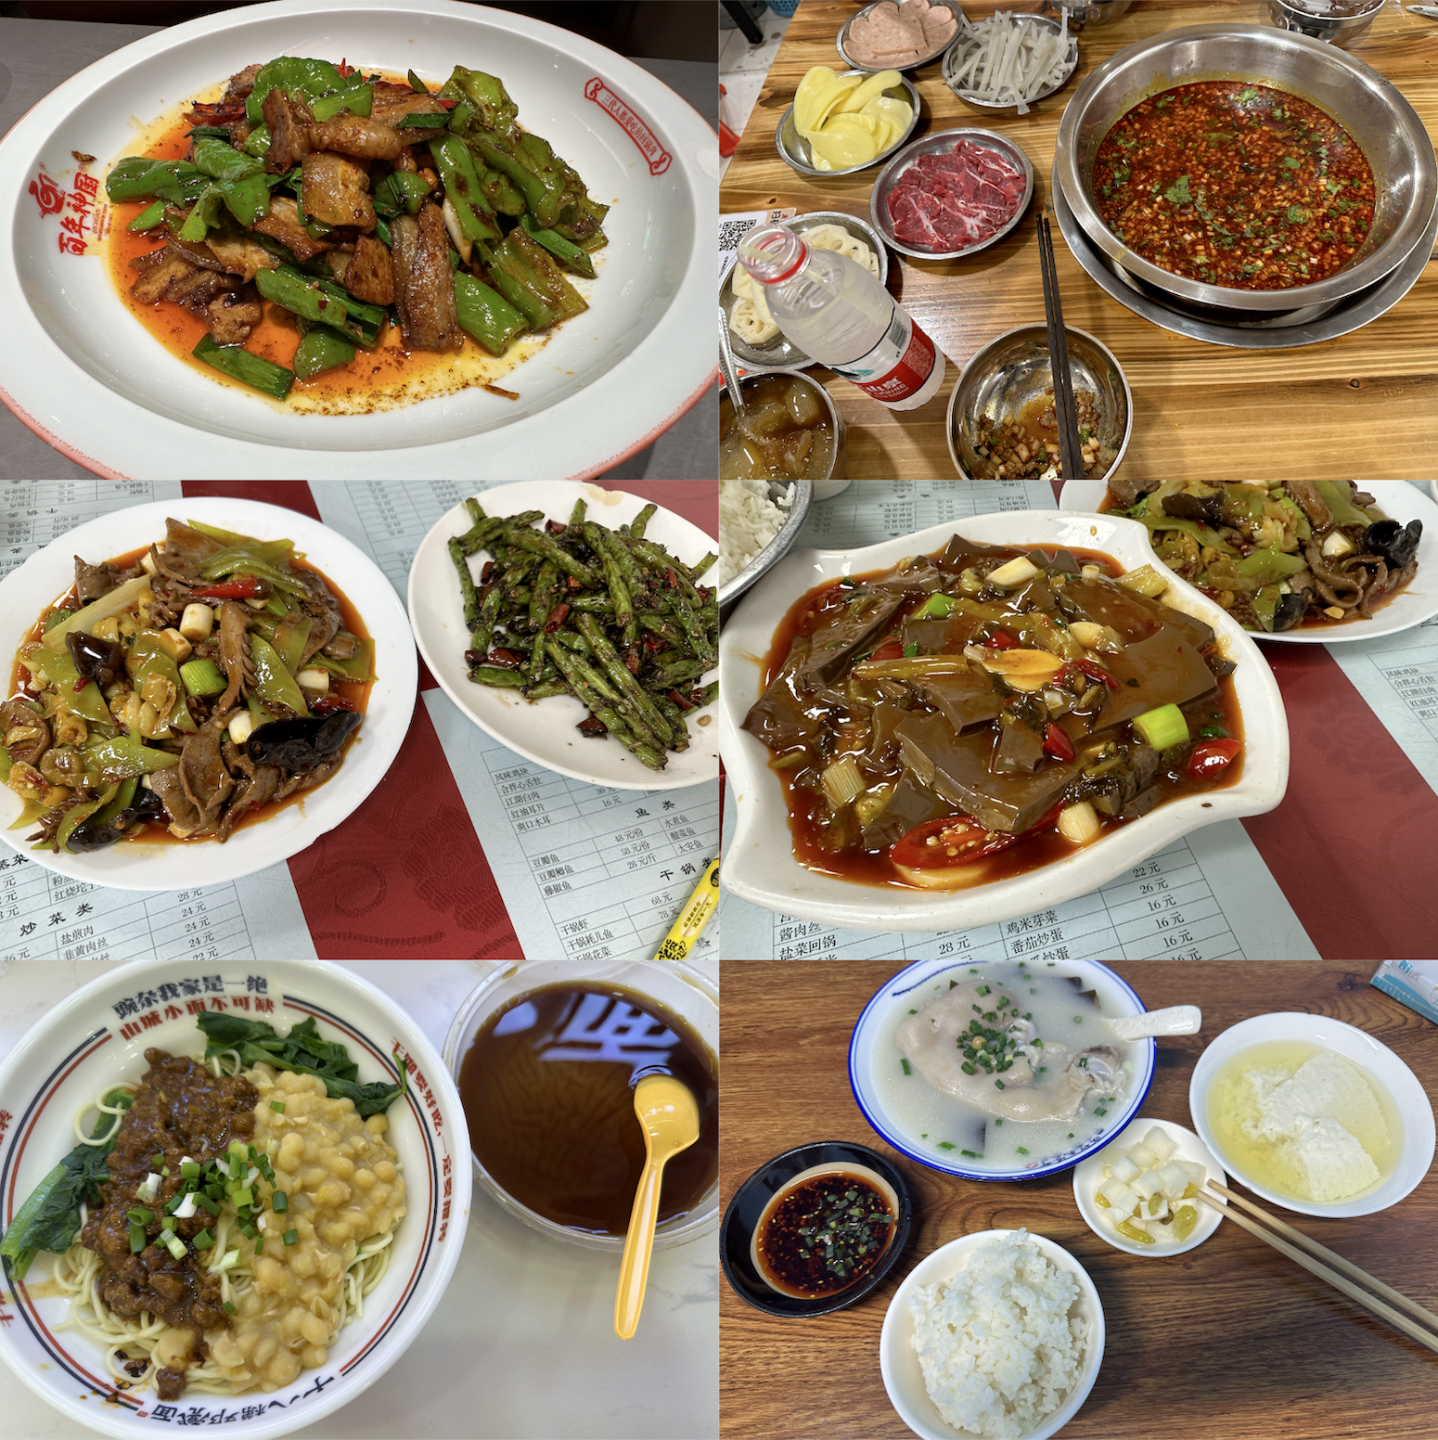
###### 北京(北京大学)
##### 美国境内
在 6 月份本科毕业典礼,我爸妈带着我妹来美国参加,带他们去了我本科所待了三年多的地方,也带他们在 Irvine 附近玩了一圈。
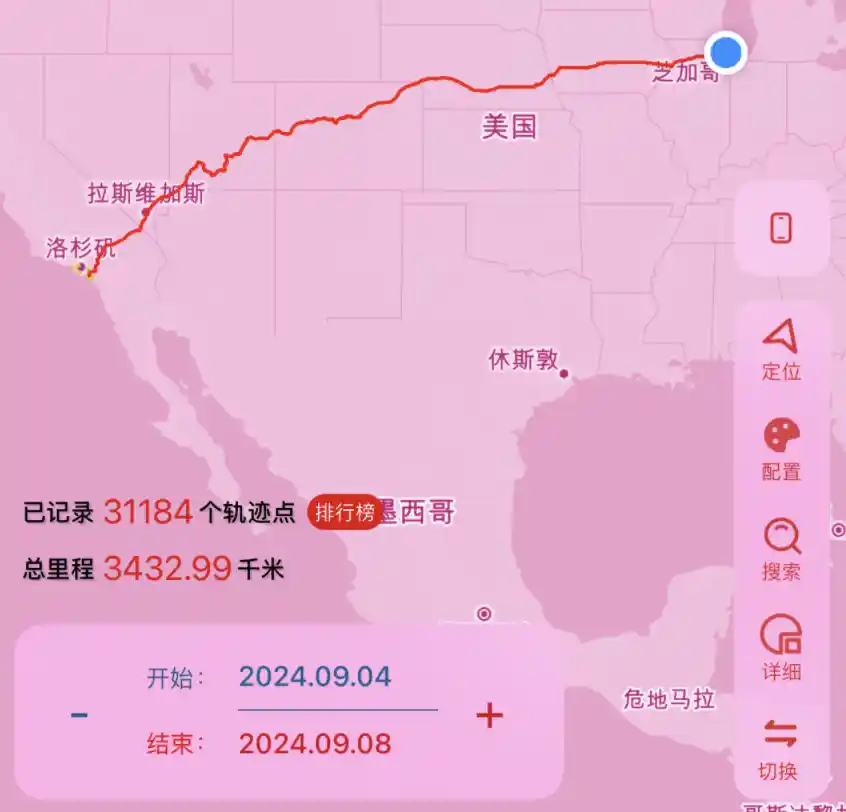
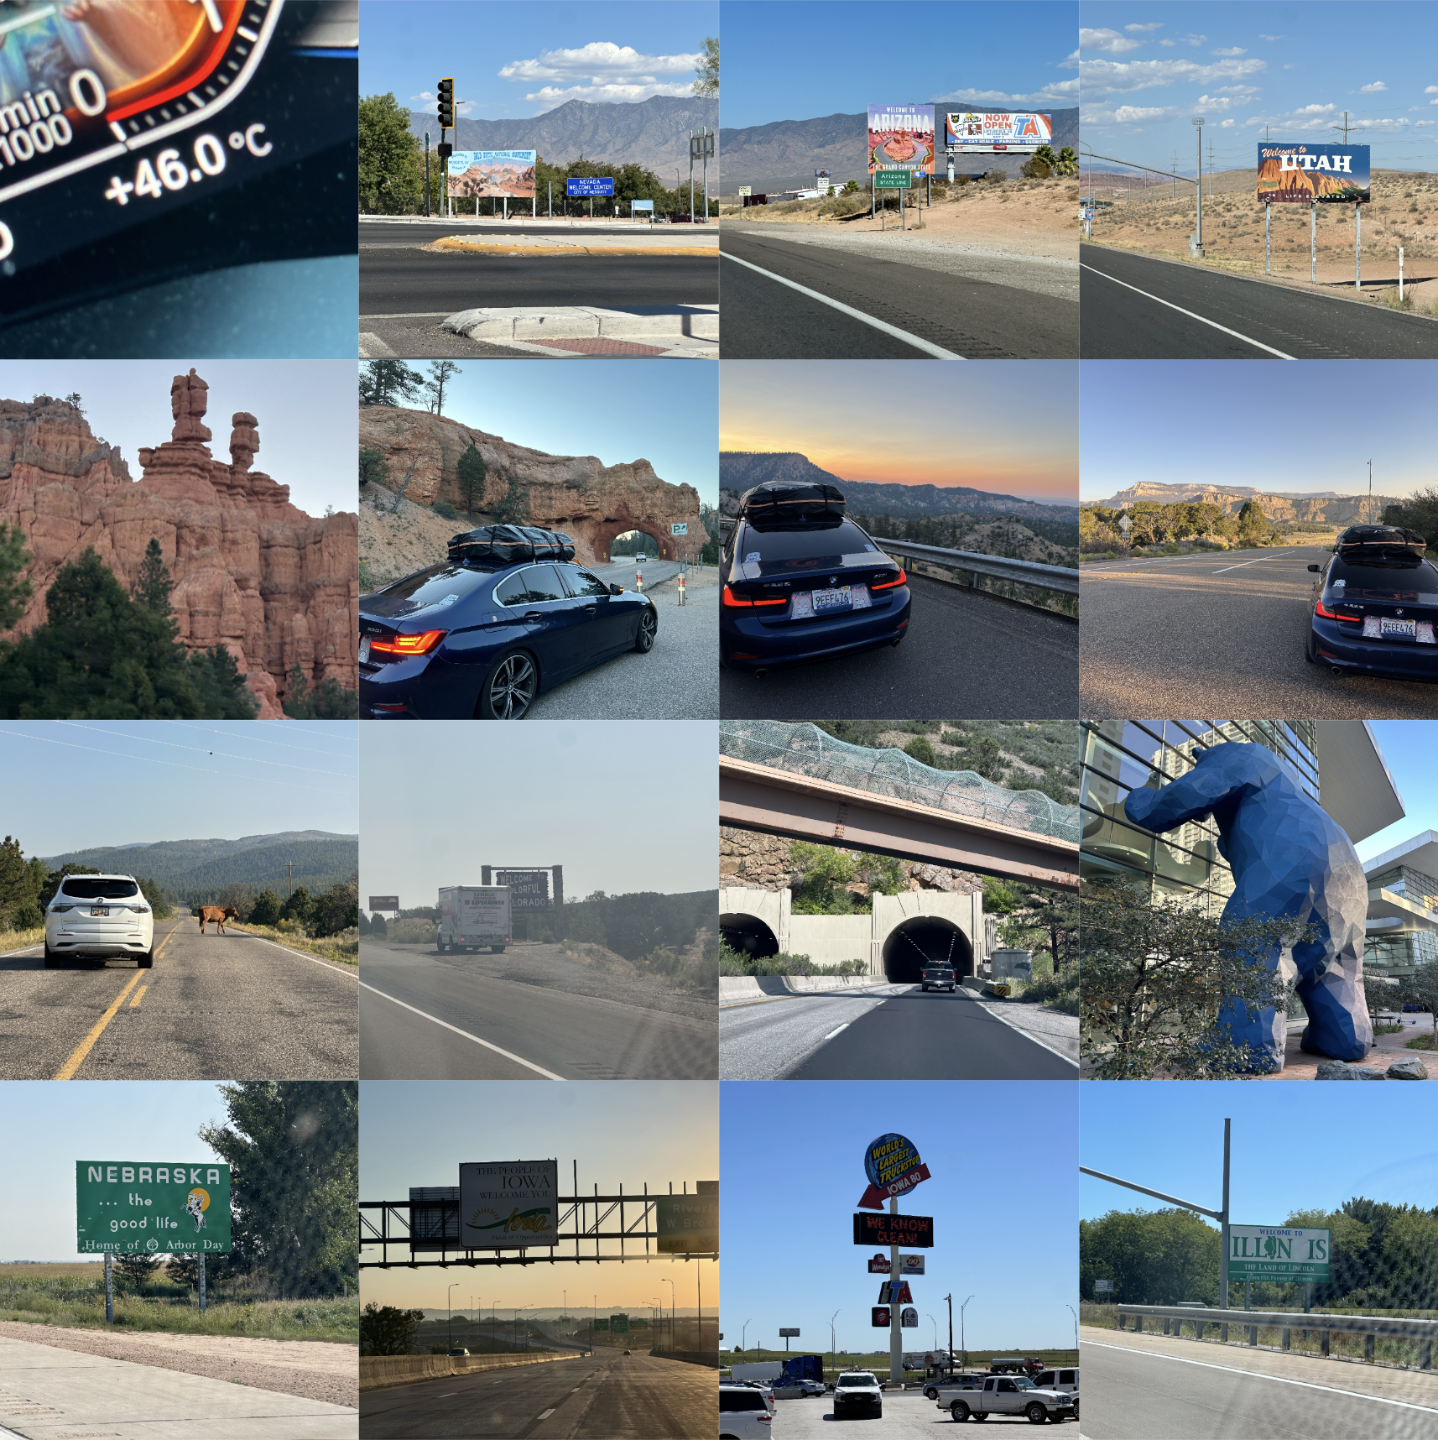
实际上这么多州就是我一时兴起从 Irvine 开车搬家来 Evanston,中间就跨越了 8 个州。然后来了这边以后分别去 Wisconsin 和 Indiana 买东西(芝加哥税太高了 10.5\%),都不远,开车 1 个小时内。关于这个搬家的事情我会在另一篇文章中详细写(有空我一定补)。
感谢我的小车车,没有出任何问题把我带到了这里,跨越 8 州,3400 多公里(2100 多英里)。
##### 哥伦比亚
看这里!看这里!我已经写好了完整详细的游记和实用信息分享,可以直接去看哦:
- [哥伦比亚旅游实用信息分享](https://www.zla.pub/columbia-travel-info)
- [哥伦比亚游记](https://www.zla.pub/2024-columbia-travelogue)
#### 车
去年我做了一个年度开车总结,今年再做一个。今年我自己的车一共开了 9213 miles(14,827 km),消耗燃油 309 gallon(1169 L),平均油耗 30.4 MPG(7.75 L/100KM)。一共油费大概是 1350 美元(约 9850 人民币),约每加仑 4.4 美元(8.4 人民币/升)。
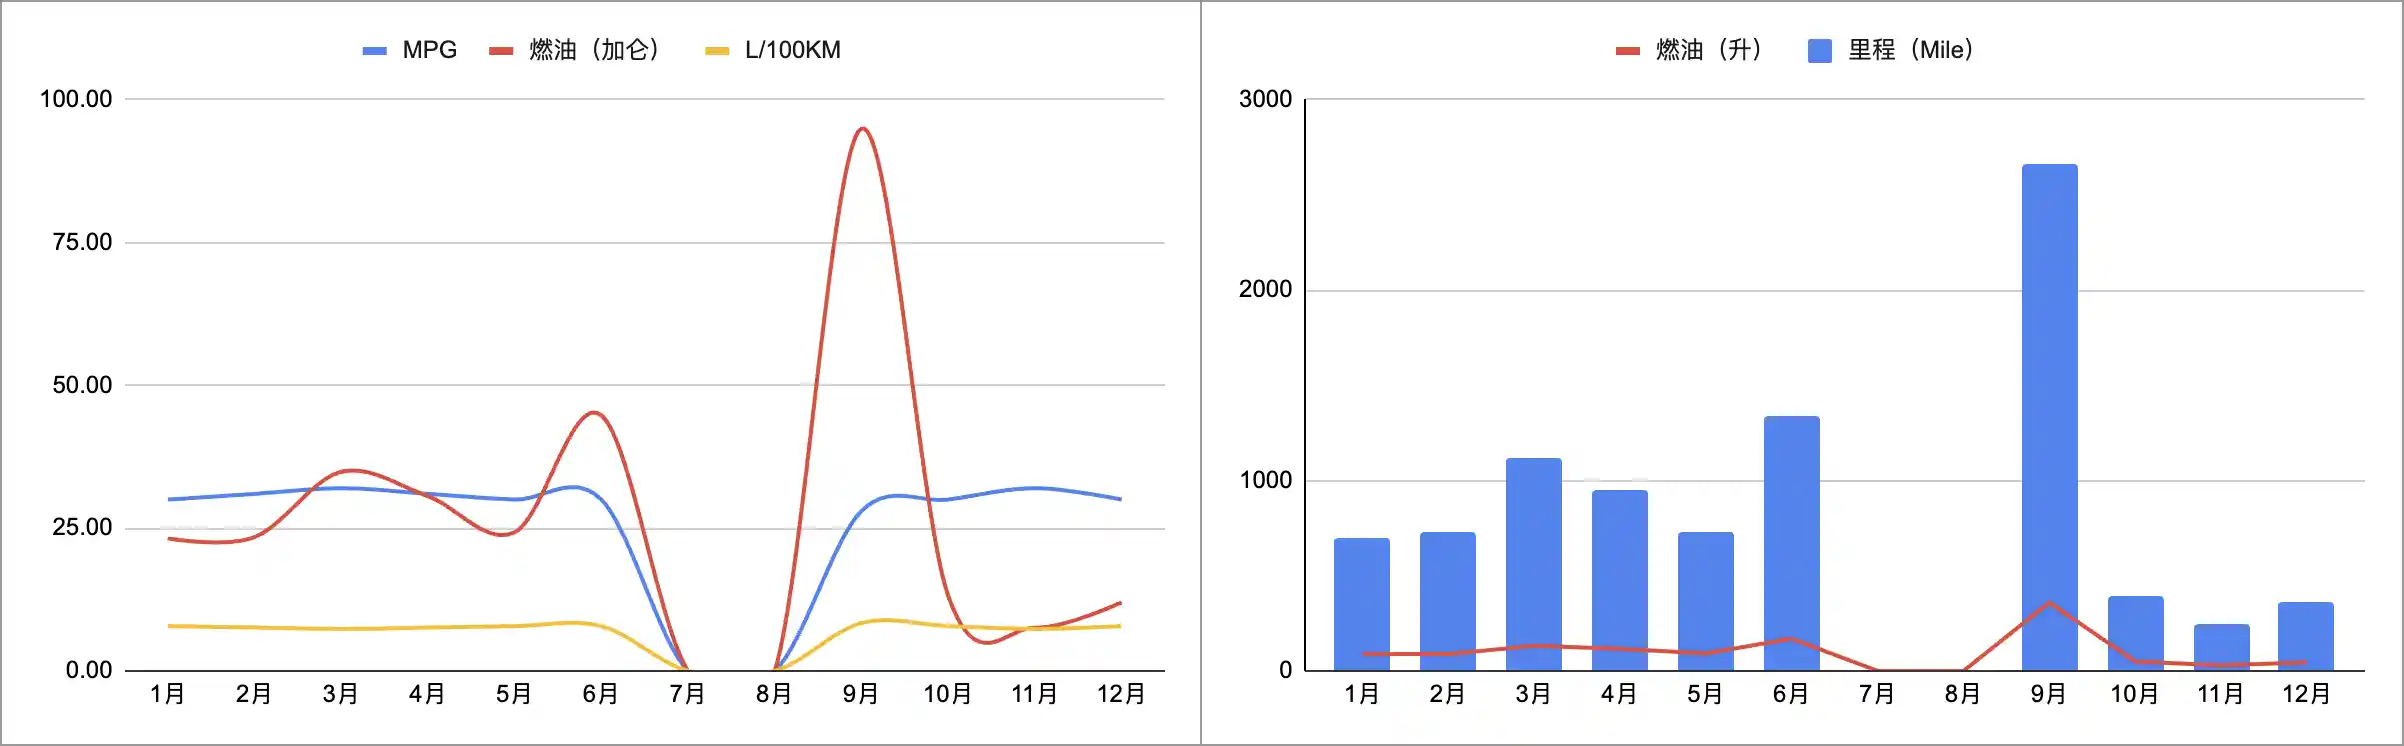
在国内旅行的时候基本都是地铁,打车也有但不多。但也在青海湖周围自驾了一圈体验还是不错的。来到芝加哥以后也基本没有什么开车的机会,上学都是走路或者坐校车,去市区都是坐地铁或者校车,所以开车在 10 月份以后开始减少。
#### 飞行
今年一共飞行 52.6 小时,飞行里程 37887 km,基本快赶上地球周长(约 4 万公里)了。飞了 14 次,3 个大洲,4 个国家,15 个城市。
第一次去南美洲,也是来美国这么多年第一次在非暑假离境,也是第一次从 ORD 出入境。
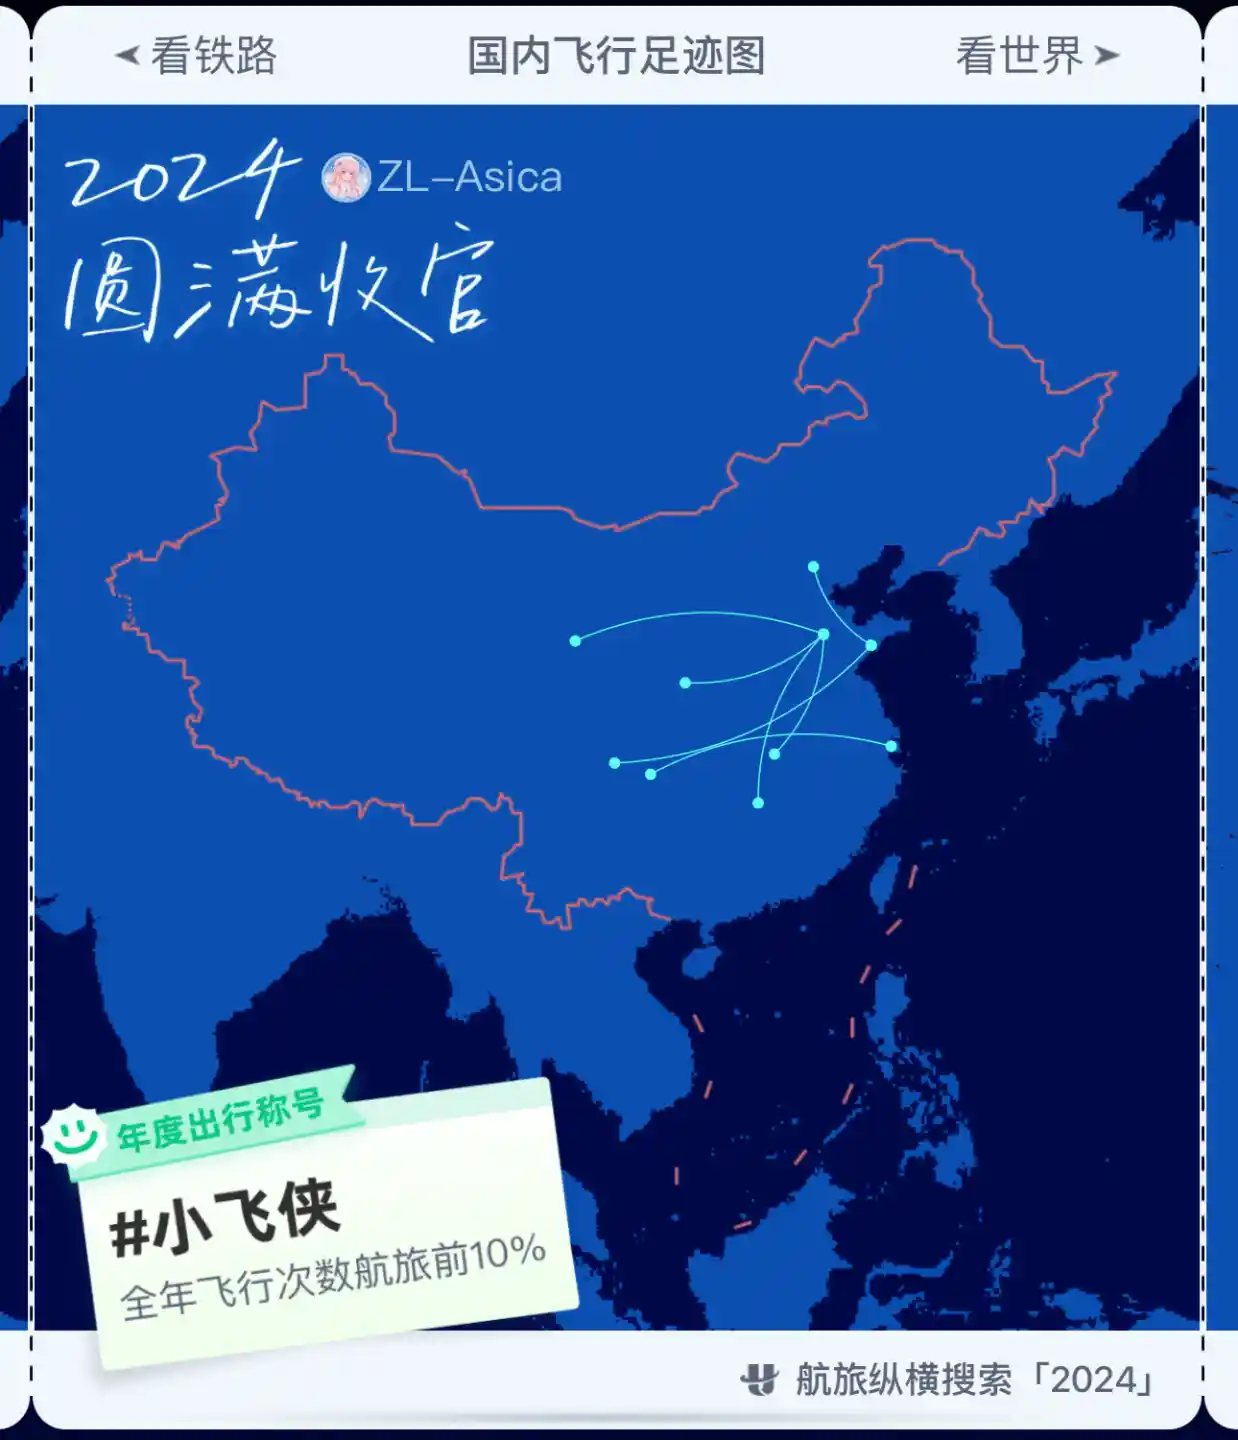
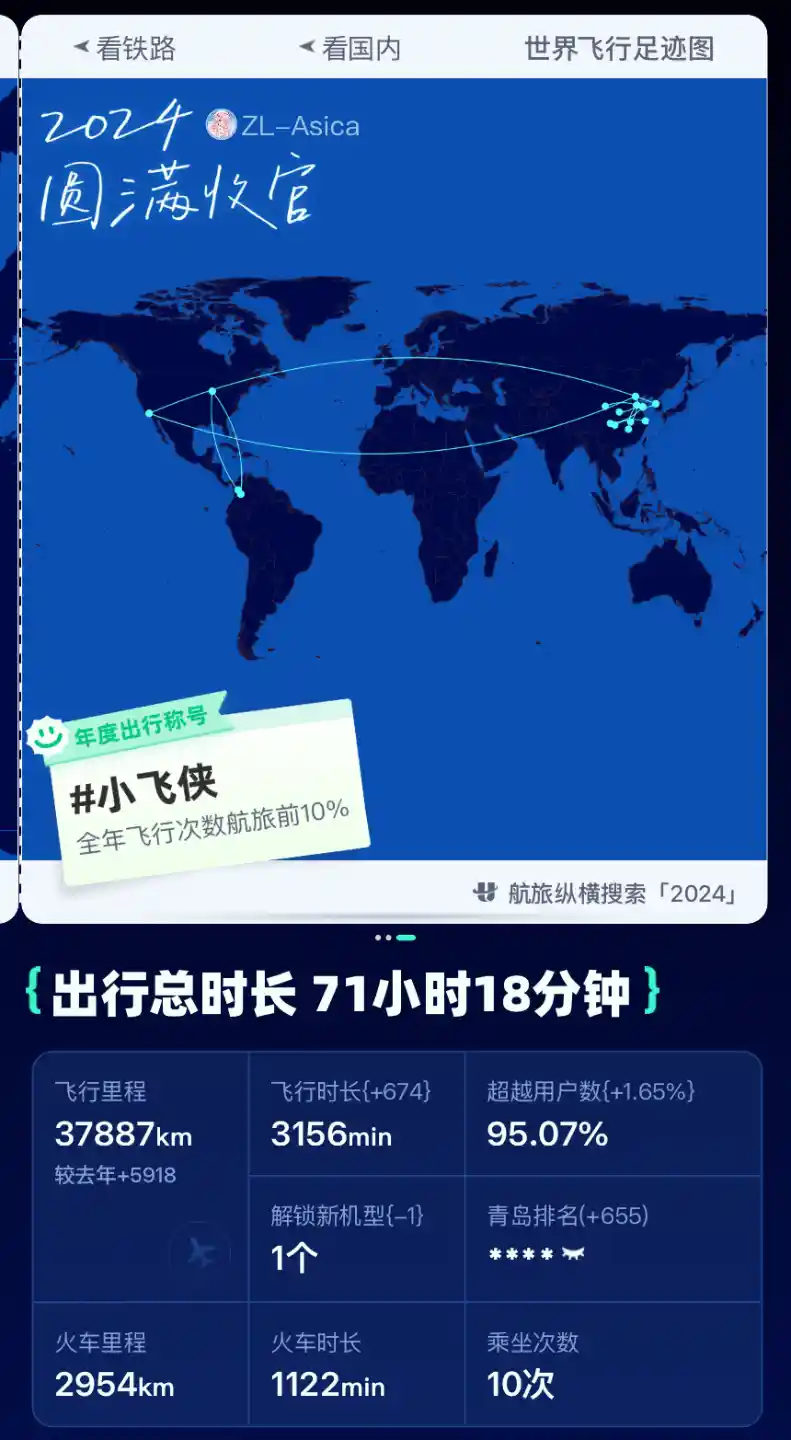
#### 火车
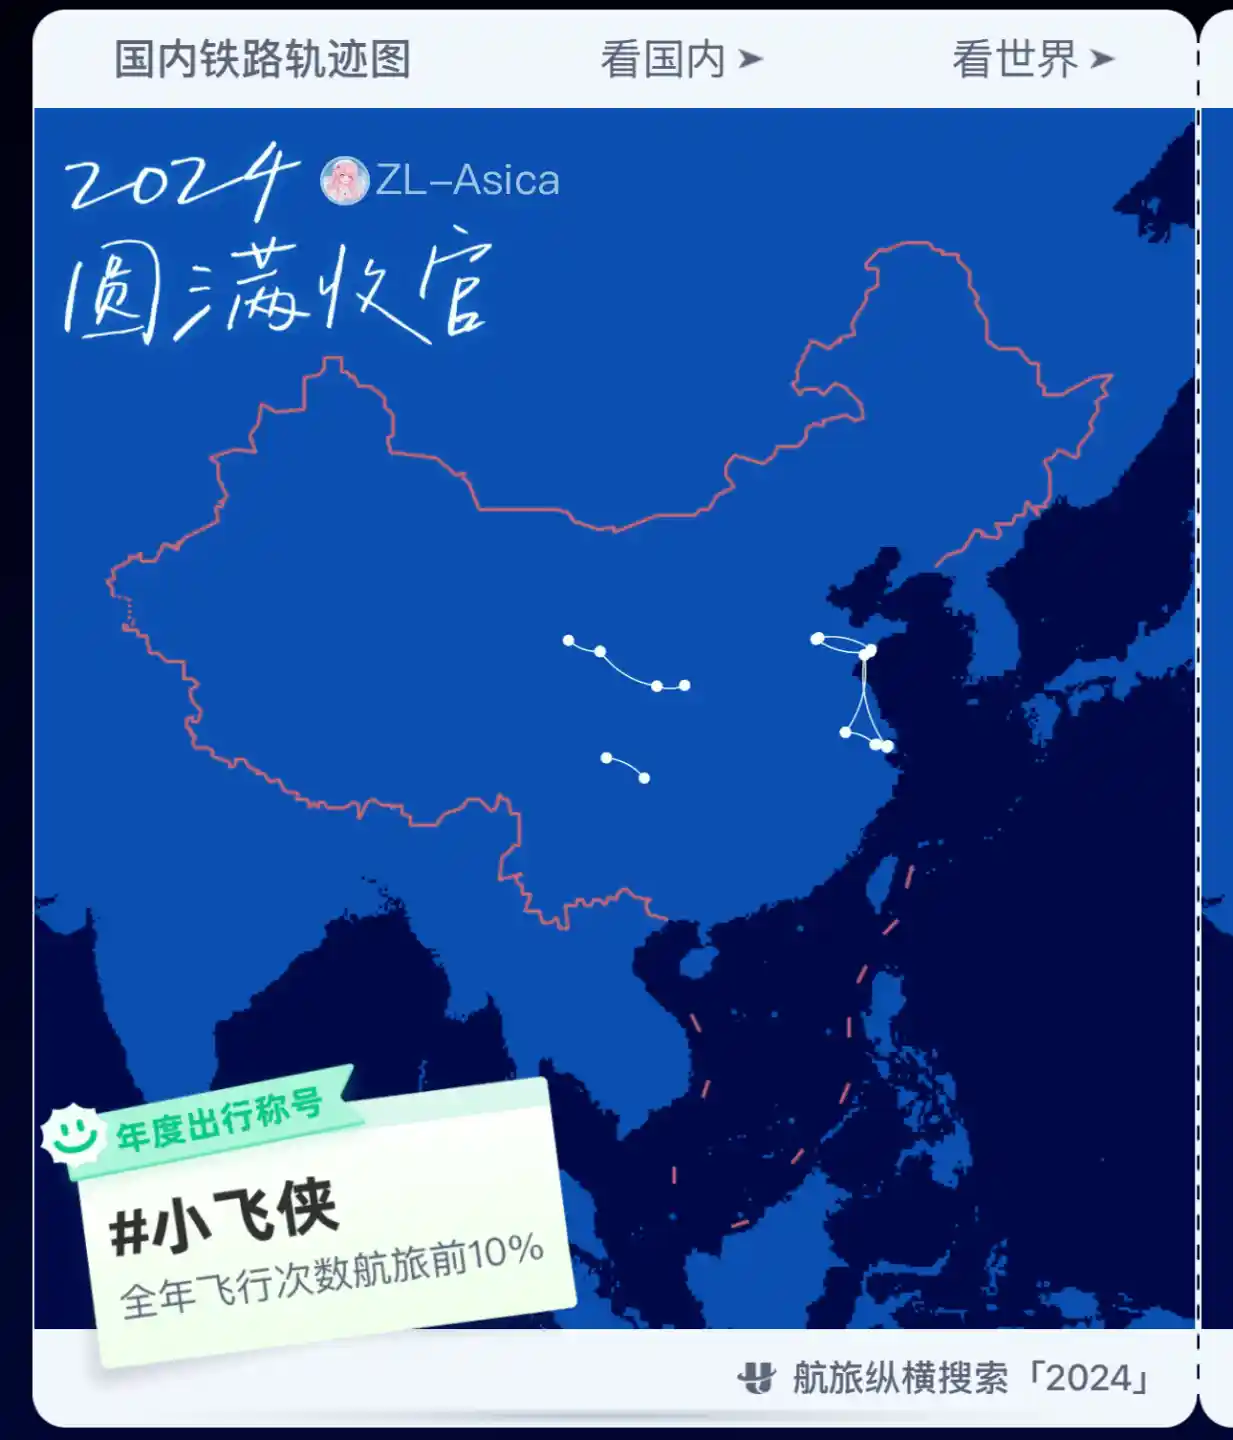
火车一共坐了 9 趟(有一趟是同车换座),17 个小时,一共 2954km,都是在国内坐的。说实话是真方便啊国内的动车高铁,美国的火车又贵又慢,班次也非常少。
### 住
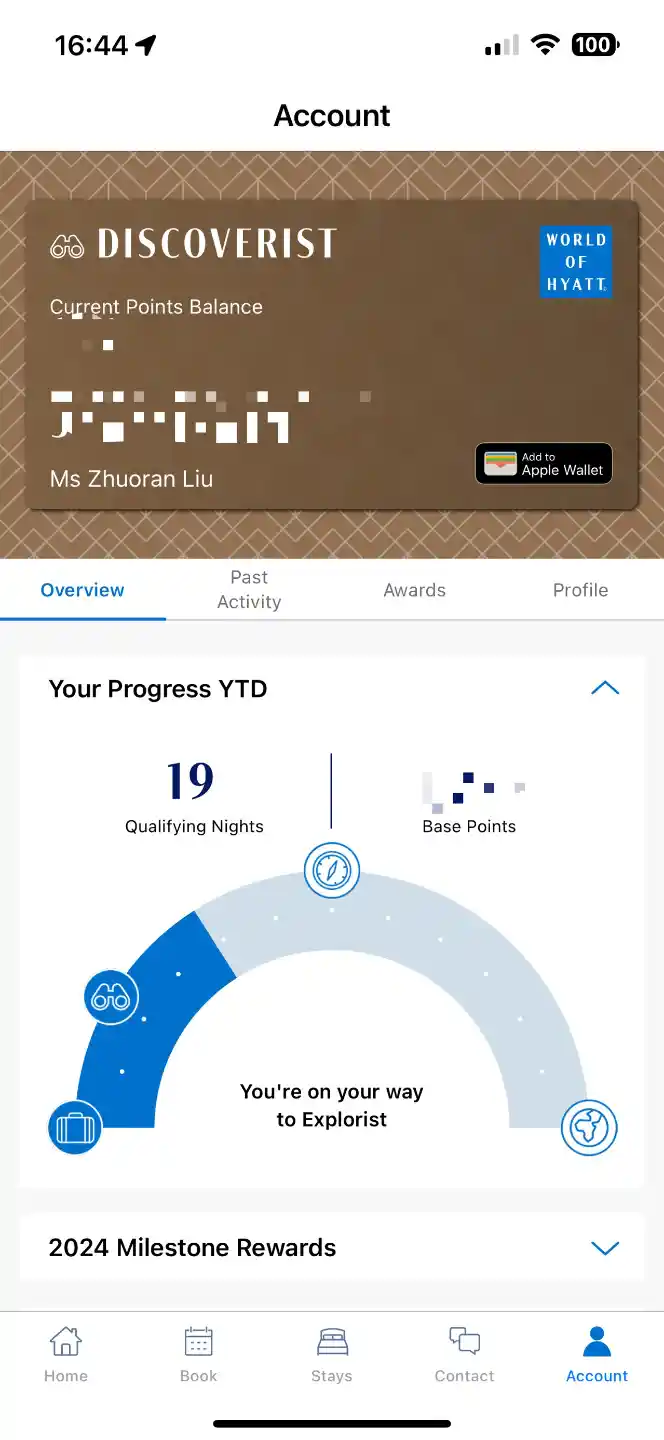
今年住到 Hyatt Discoverist 了(没开联名卡,纯靠房晚)。一共住了 19 晚(6个子品牌)。Hilton 住的不多,我个人还是更喜欢 Hyatt 多一些(对我个人的出行习惯来说,Hilton 钻在美国的体感一般)。
体验最好的酒店是如下三家:
1. [苏州凯越酒店 - Hyatt Regency Suzhou](https://www.hyatt.com/hyatt-regency/en-US/suzhr-hyatt-regency-suzhou)
我朋友的帽子在这里落下了,酒店帮忙找到并且寄回给她,非常感谢!
2. [重庆大都会凯悦酒店 - Hyatt Regency Metropolitan Chongqing](https://www.hyatt.com/hyatt-regency/en-US/ckgro-hyatt-regency-metropolitan-chongqing)
用了 GOH,免费升到了套房,早餐还算可以,酒廊比较一般。
3. [成都群光君悦酒店 - Grand Hyatt Chengdu](https://www.hyatt.com/grand-hyatt/en-US/ctugh-grand-hyatt-chengdu)
用了 Club Access,这个酒廊是真不错,我们坐的位置可以直接看到楼下的四川省委(就离谱)。早餐可以直接在酒廊里吃,可以单点一些菜品。
## 生产
### 财产
#### 收入
今年的收入基本全靠上半年还在学校的时候做的 Reader(TA 的一种,专门负责批作业),感谢我的好姐妹给教授推荐了我,时薪 \$ 19.4 比我之前的工作会高一些,而且工作时间比较自由可以 remote。
#### 信用卡
至于信用卡这边我今年只开了 US Bank Altitude Connect,趁着改版的间隙刷,而且还有 1 年 4 次的 PPS(正好 Hilton Aspire 的不是没了吗)。
明年就出 524 了啊啊啊啊啊,继续 Chase!!!
#### 银行账户
年初的 UCU(University Credit Union) 相信大家都薅蛮爽的,我稍微有点曲折但最后还是 CC Fund 了 \$ 8000。
Citi 的 Enhanced DD ,这个连 ACH 和 Zelle 都算,没法再简单了。
年底来到 IL 以后我尝试去薅 53,本来打算用 Fidelity 做 Fake DD 的,但我账户因为填 W8-BEN 的时候 IL DL 太新了(逻辑何在?)刚开户就被风控冻结了,目前还在等结果,大概率是无了。
#### 债务
终于在 6 月毕业前把车贷还完了,拿回了 Title,目前车的 Title 已经转移到 IL 了。
### 学业
#### 本科
还算顺利毕业,已经拿到了 Diploma(Fedex 空运寄到了国内)。Honor Program 在 6 月底论文审核过了。
#### 硕士
和我想象中的稍微有点不一样,当然也是主动的选择课选的都不算难,但因为在本科最后一年成绩太顺利,硕士的第一学期稍微有点懈怠了,GPA 比预期低一点,不过还在我能接受的范围内。西北的氛围和 UCI 非常不一样,而且学校对比 UCI 也小了很多,也不是在大农村了,所以生活上也有很多不同。
#### 项目
今年完成的开源项目主要是两个:
1. [SuzuBlog](https://suzu.zla.app/)
这是我今年最满意的开源项目,第一次使用 Next.js 开发项目,体验不错。如果想要了解更多可以看我的[这篇文章](https://www.zla.pub/suzublog)。
2. [@zl-asica/react](https://react.zla.app/)
我自己的一个 React Hooks 和 utils 工具库,主要是为了方便自己在项目中使用。因为是我自己写的给自己用的,可能不会和其他的 React Hooks 库一样适配那么广,但也足够基本的使用了。有兴趣的可以点上面链接去看一下文档。
目前我还在开发一个私有图床的项目,基于 React, Cloudflare Pages Functions, KV, R2,目前还在开发中,基本功能已经基本完善,但还需要一些优化、BUG 修复和文档编写。写好后我还是会照旧写一篇单独的文章来介绍。此站点基本所有图片都已经是基于这一个私有图床的了,目前使用的域名是 `r2.img.zla.app` 因为图片都放在了 CF 的 R2 里。
## 2025
### 愿景
申请到心仪的 phd 项目 (但这好像是后年才能知道的事,不过 25 年就要申请了)。
### 2024 OKR 回顾
#### O1: 健康管理
完成度:60\%
早睡早起做到了一部分,但不完全;运动在上半年还可以,下半年没有了;体重没问题,回国一趟就涨 5 斤,回到美国就跌回去(是这样的🙂↕️)
#### O2: 内容创作
完成度:40\%
ummmmm,今年博客更新了 5 篇文章(如果游记算 2 篇),都在 12 月,所以这个目标是失败的。根据我的分析主要是因为在 SuzuBlog 开发完成前 WordPress 的老博客体验确实是非常糟糕,就没有动力去写。手记还行,但也没有完全达成。
#### O3: 学术目标
完成度:90\%
文章的话有点希望,本科的 Honor Program 论文过了,MS 第一学期的成绩虽然出了点小插曲,但还是在目标值内,Research 也在进行中。
#### O4: 财务管理
完成度:80\%
主要原因是看 3 本书的目标没完成,我确实看不大下去这种类型的书,具体的可以看我上面写的阅读部分。但记账和定投都没问题,车贷也是没问题了。
#### O5: 个人成长
完成度:50\%
在线课程今年一个都没有学,日语进度还可以一直在用多邻国没有断过,读书数量够的,3 本非我领域内的书完成了(可以看上面阅读的部分)。
### 2025 年度 OKR
基本和去年的保持一致,去年的就很适合长期维持。
#### O1: 健康管理
KR1: 早睡早起 23:00-7:00
KR2: 增加运动(有点难🥹)
KR3: 饮食结构维持
#### O2: 内容创作
KR1: 博客每月至少更新 1 篇新文章,全年至少 15 篇文章
KR2: 手记每周至少 2-3 篇,旅游至少 1 天一篇
KR3: 维护 SuzuBlog
#### O3: 学术目标
KR1: 至少发1篇文章
KR2: 搞定 MS 的毕业相关要求
#### O4: 财务管理
KR1: 继续维持记账的习惯
KR2: 阅读2本关于财务规划和投资的书籍
KR3: 继续维持之前的理财计划(定投、储蓄等)
#### O5: 个人成长
KR1: 继续学习日语
KR2: 养成读书好习惯(至少 3 本不同领域的书)
**🥳2025新年快乐!!!**
---
https://zla.pub/2024-columbia-travelogue
---
#哥伦比亚游记
这次旅行是在出发前仅 6 天才开始计划和预订机票和酒店,虽然准备时间匆忙,但总体结果还算满意。不过,旅途中也不可避免地遇到了一些小插曲,可以说是充满了意外和惊喜的体验呢~
如果你正在计划前往哥伦比亚,可以先阅读我之前整理的[哥伦比亚旅游实用信息](https://www.zla.pub/columbia-travel-info/),里面有一些干货和贴士。这篇文章则更像是一份详细的旅行流水账,记录了我们此行的点点滴滴,希望我们的行程安排能为你的计划提供些许灵感~
## 出发
### 飞行
#### 机票
我们本次的机票为 Avianca (哥伦比亚国家航空)的 ORD-BOG 直飞往返,使用 MR 点数兑换,每人往返 50k 多一点的点数,外加 130 刀的税费。虽然它叫这个名还是载旗航,但实际上是个廉航,后排座位无法调节,6 个小时的航程也不包含餐食,这点要注意。如果可以接受转机并且时间比较多的话,可以选择从巴拿马或者弗罗里达转机的航班,顺便还可以多玩一个地方,现金票价格也会便宜一些。
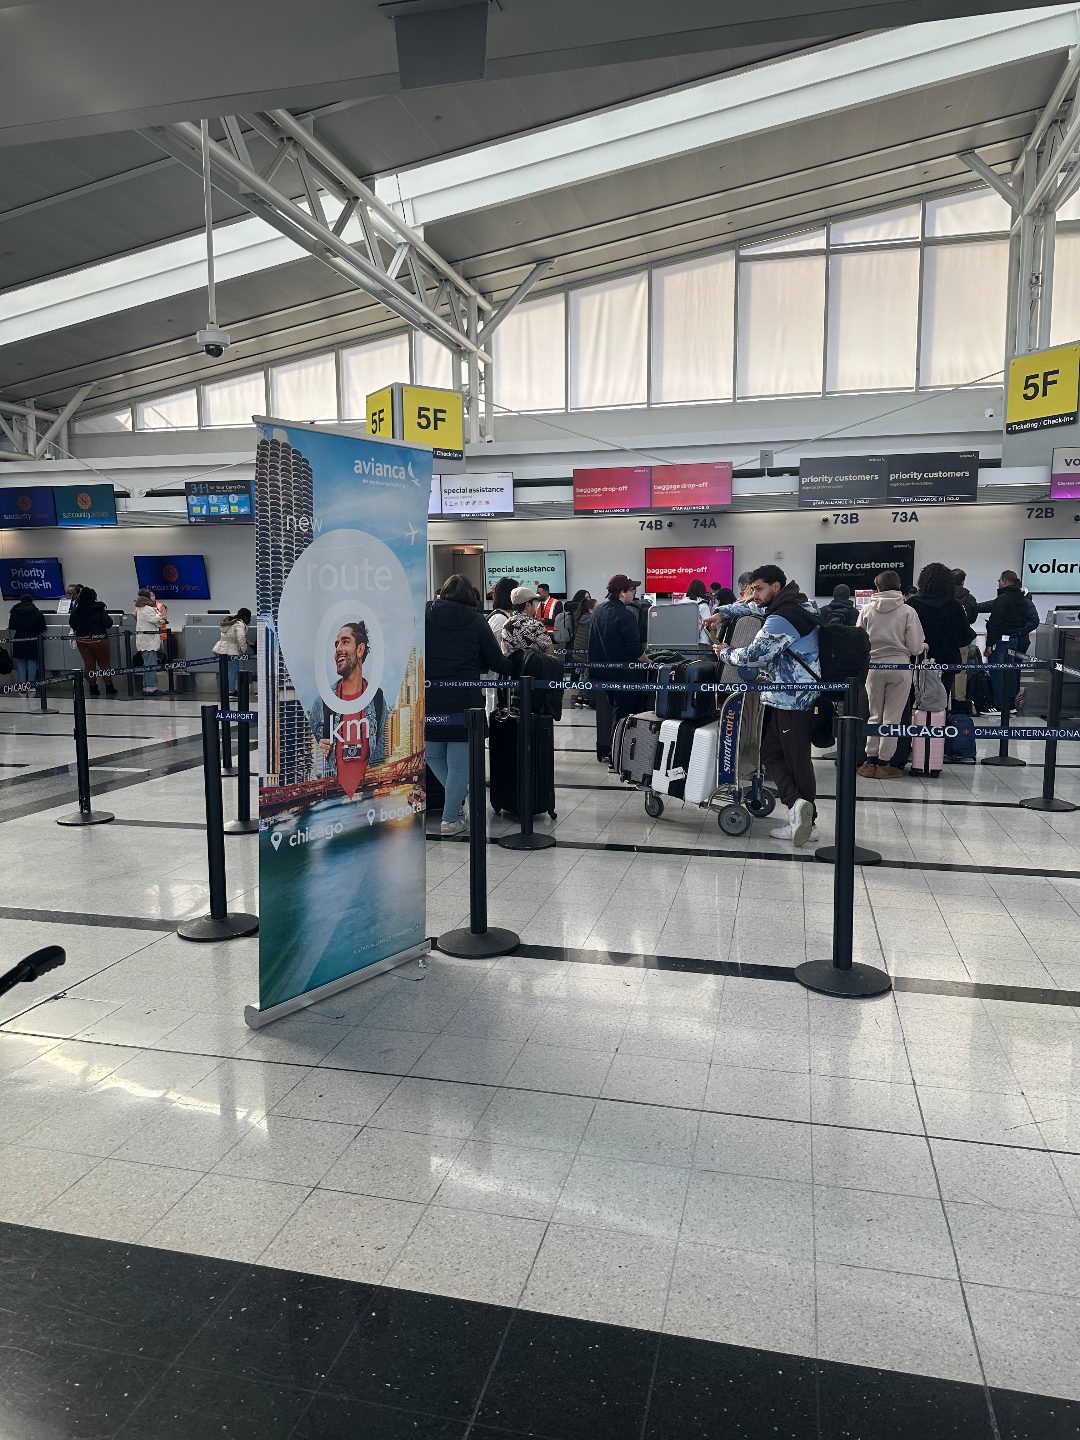
#### ORD-BOG
我们这次的航班实际上订的是有问题的,原始方案为 ORD-BOG-MDE,但国际转国内的航班预留间隔过小,如果前序航班不延误我们是有两个半小时的时间的。但因为境内的航班用积分换非常贵,我们采取了国际段积分、国内段现金的方式订的,结果这航司分开订票即是是自己家的也不给行李直挂,可谓是非常离谱(我在今年 5 月份分段订过 LAX-ICN-TAO 的大韩,行李直挂是完全没有问题的)。理论上来说一般同联盟的航班也是可以做行李直挂的,但它家就是不行。
这班航班在过去一周都没有落地延误超过 10 分钟的情况,本来以为这次稳了,但怕什么就来什么。我们的航班在延误 1 个多小时后才起飞,最后比计划晚点了 30 多分钟才落地,我们没有办法只能落地后狂奔去移民局。
### 移民局入境
在移民局入境需要出示护照和有效的美签/申根签证,我们本次使用的 F1 签证。最好提前准备好返程机票订单和酒店预订单,直接一起给移民局的工作人员即可,对方需要在系统内登记相关信息。如果是住在朋友家等没有预订单的情况记得准备好地址给他们。
### 人生中第一次误机
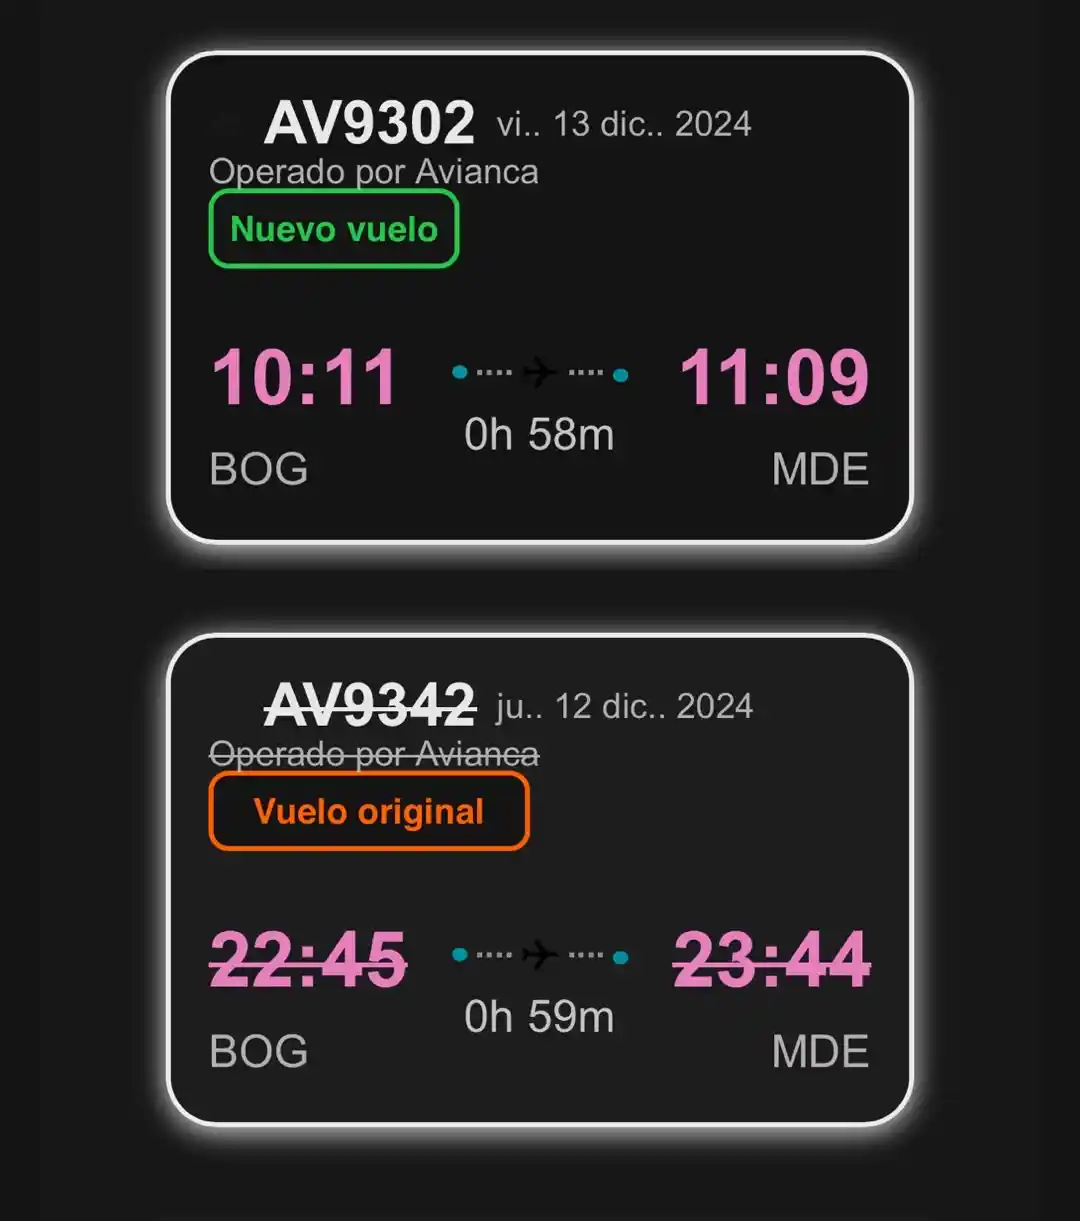
这真是第一次误机,从未有过的情况。由于订的不是联程航班,理论上后段是不会为前段的延误负责的。为了不影响后续行程,我当场开始搜当天更晚的机票,但发现我们误机的这班便是当天的最后一班了,于是就想着看提取行李后看看还能不能赶得上。事实证明,在我们提取完行李来到楼上想要办托运的时候,工作人员告诉我们已经不可以办理了。因为提前预料到了这个情况也没有很慌,开始思考后续的方案和行程调整,决定今晚先在波哥大过夜,第二天再飞麦德林。
抱着试试看的心态,我去找了 Avianca 的工作人员询问误机是否能够改签,付一些 penalty 也是可以接受的,总比两段都打水漂了要好。找到工作人员后,直接傻眼,人家不会说英语😢。好在有谷歌翻译,这已经是不知道多少年没有用过它的语音对话翻译功能了,都有点不熟练研究了一下怎么用。工作人员研究一番我们的机票后告知我们无需支付任何 penalty 改签到第二天一早 10 点飞麦德林的航班。悬着的心终于算是落了一半。
### 酒店
#### 入住
为了方便,我在机场掏出电脑用 UR 转了 Hyatt 的点数订了当晚的酒店,也就是我们本来要从麦德林回来住的那家。当然是为了方便,这样就可以把托运行李直接寄存在酒店不需要带到麦德林去了。
供大家参考我们订的是美国大使馆隔壁的 [Hyatt Place Bogota / Convention Center](https://www.hyatt.com/hyatt-place/en-US/bogzb-hyatt-place-bogota-convention-center),Cat 1,积分价是淡季 3500 一晚(在机场订的当晚稍高一些),现金价 100 刀左右一晚。
这家酒店前台英文不错,但完全没有免费的一次性用品(不是只有这家,麦德林的也是),牙刷牙膏浴帽都是要收费的,一次性拖鞋在我们住的两家酒店你想要付钱都是没有的,强烈建议自备。洗发水沐浴露是有提供的,是大瓶的。
晚上已经很晚了(11点多),我们也都很累,刚到波哥大还不熟悉周围环境也不敢出去找吃的,便草草洗漱后就睡了。
#### 早餐
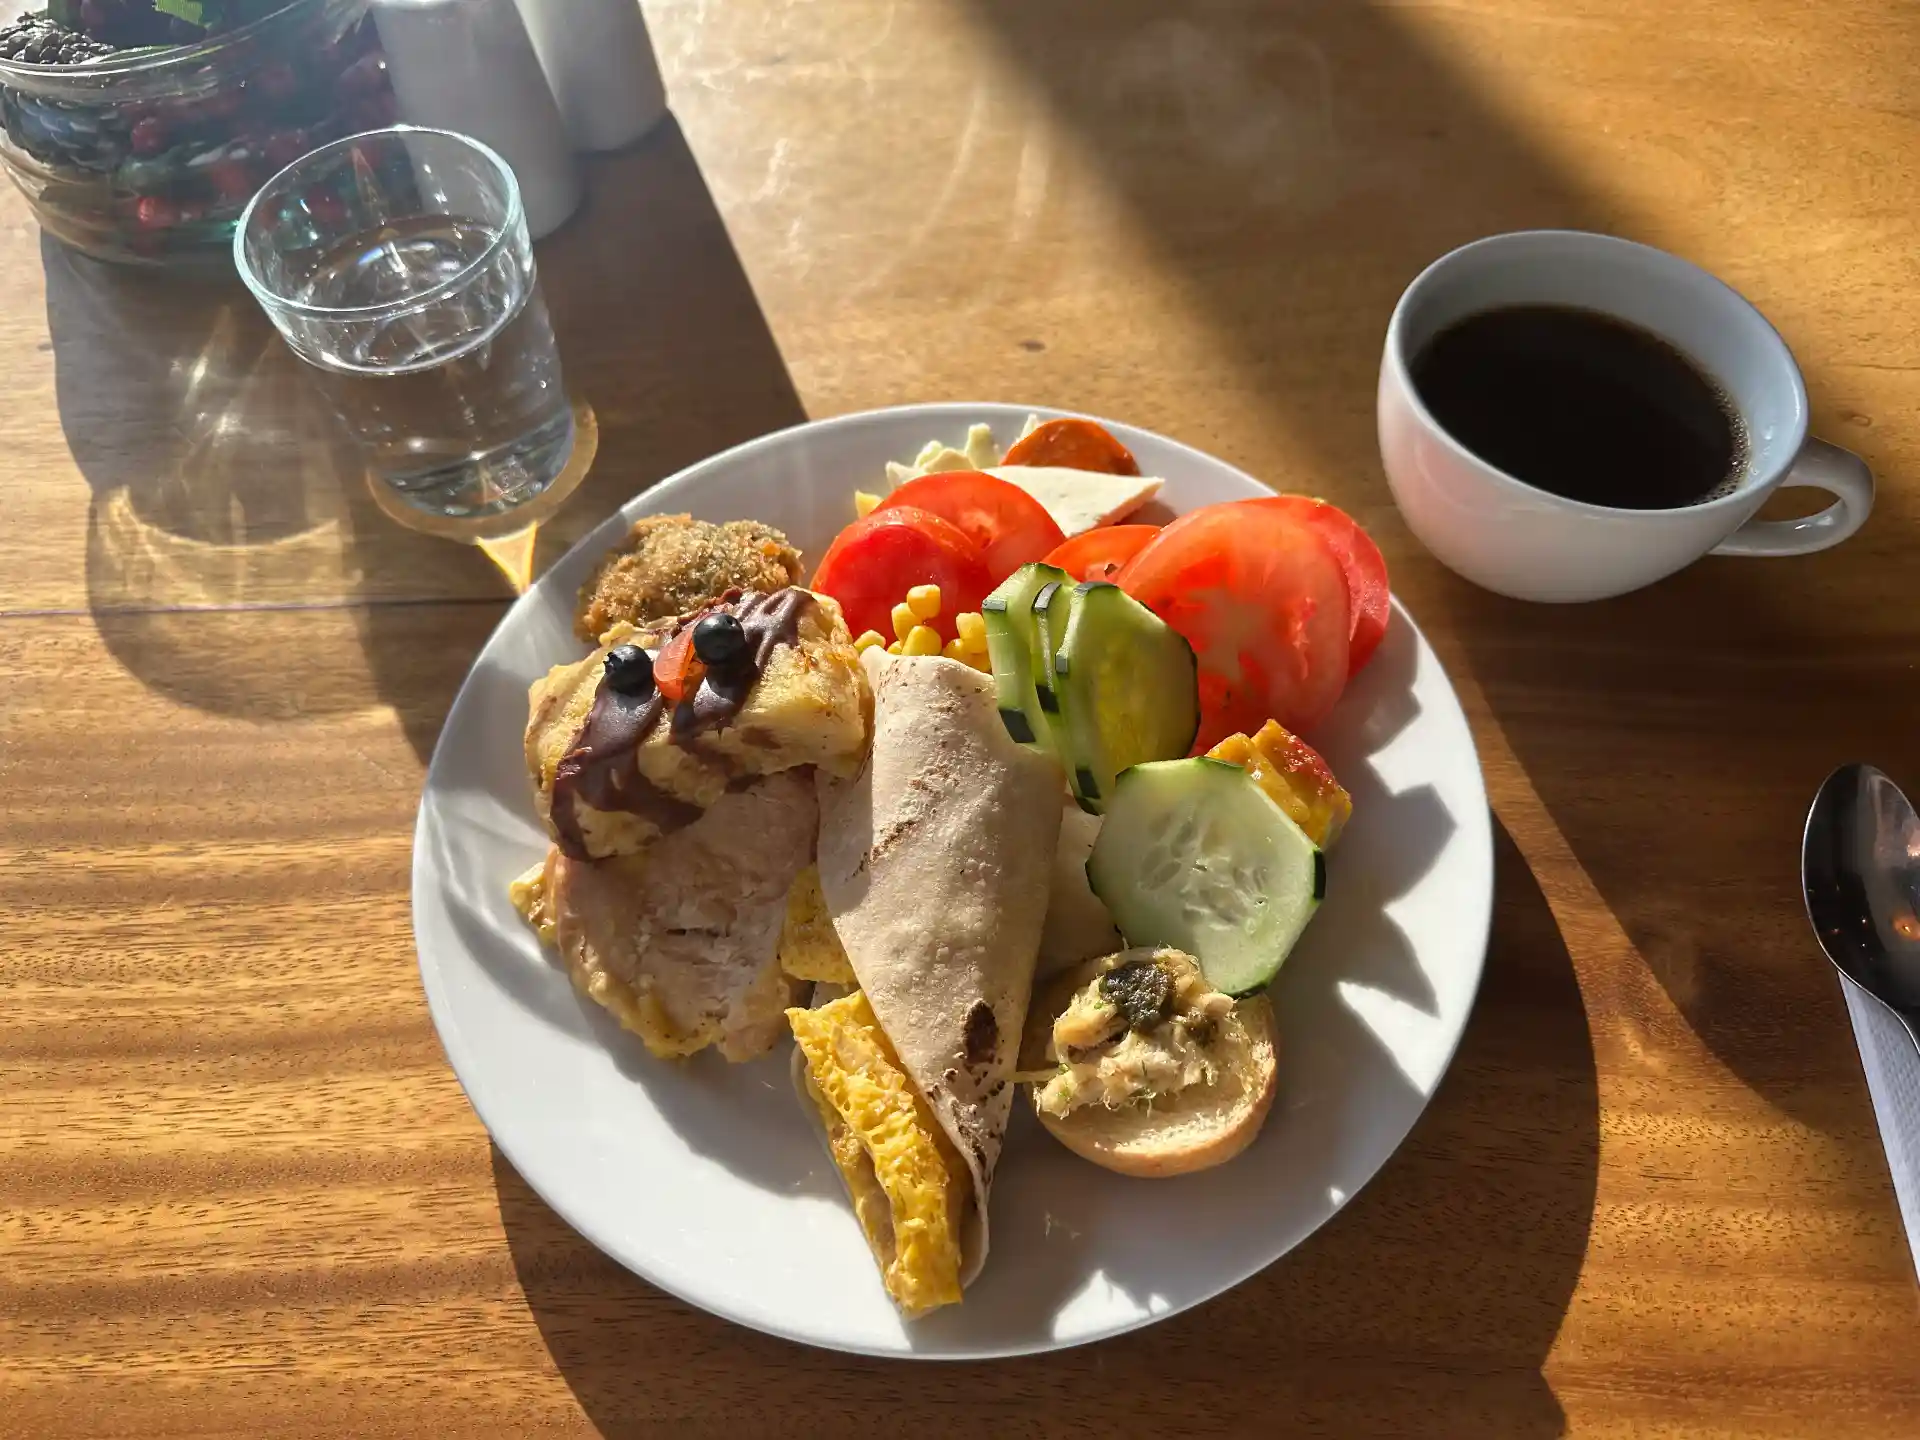
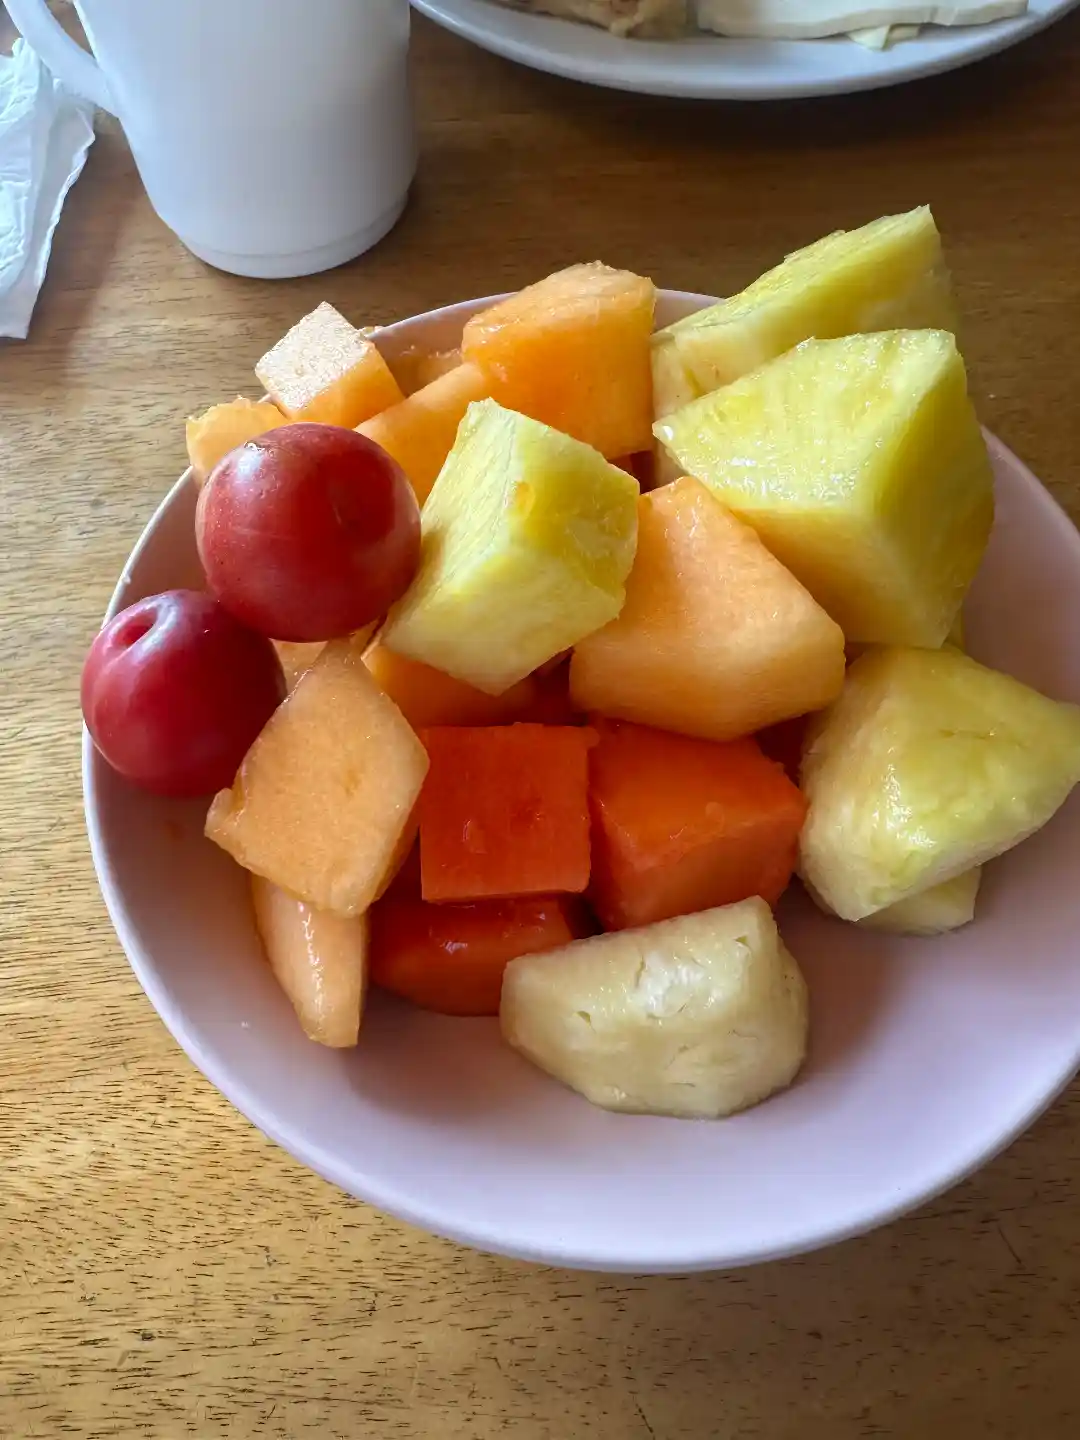
对比美国境内同档次酒店提供的早餐,这酒店的早餐可以说是非常豪华了,就光这水果拿到美国去单买不得卖个 7-8 刀。而且木瓜和菠萝都非常甜,哈密瓜也很甜但对比另外两个稍显逊色。还有一些地方特色的玉米饼、大蕉饼一类的,也有鸡胸肉和炒蛋,当然也少不了咖啡。
### 机场半日游
第二天一早,我们把行李寄存在酒店后,便赶往了机场,但等待我们的是航班超售。在登机口终于看到登机且排到队的时候被告知没有座位了,我们只能再次找到机场的工作人员去改签。工作人员告诉我们上午的所有航班所有位置都卖空了,只能给我们下午两点的航班有位置(那能怎么样呢,没有问我们要钱已经是非常好了)。因为当时已经是11点,我们就决定在机场解决午饭问题了。
不愧是盛产咖啡的国家,这机场里也到处都是咖啡店,而且基本都有豆子在卖。
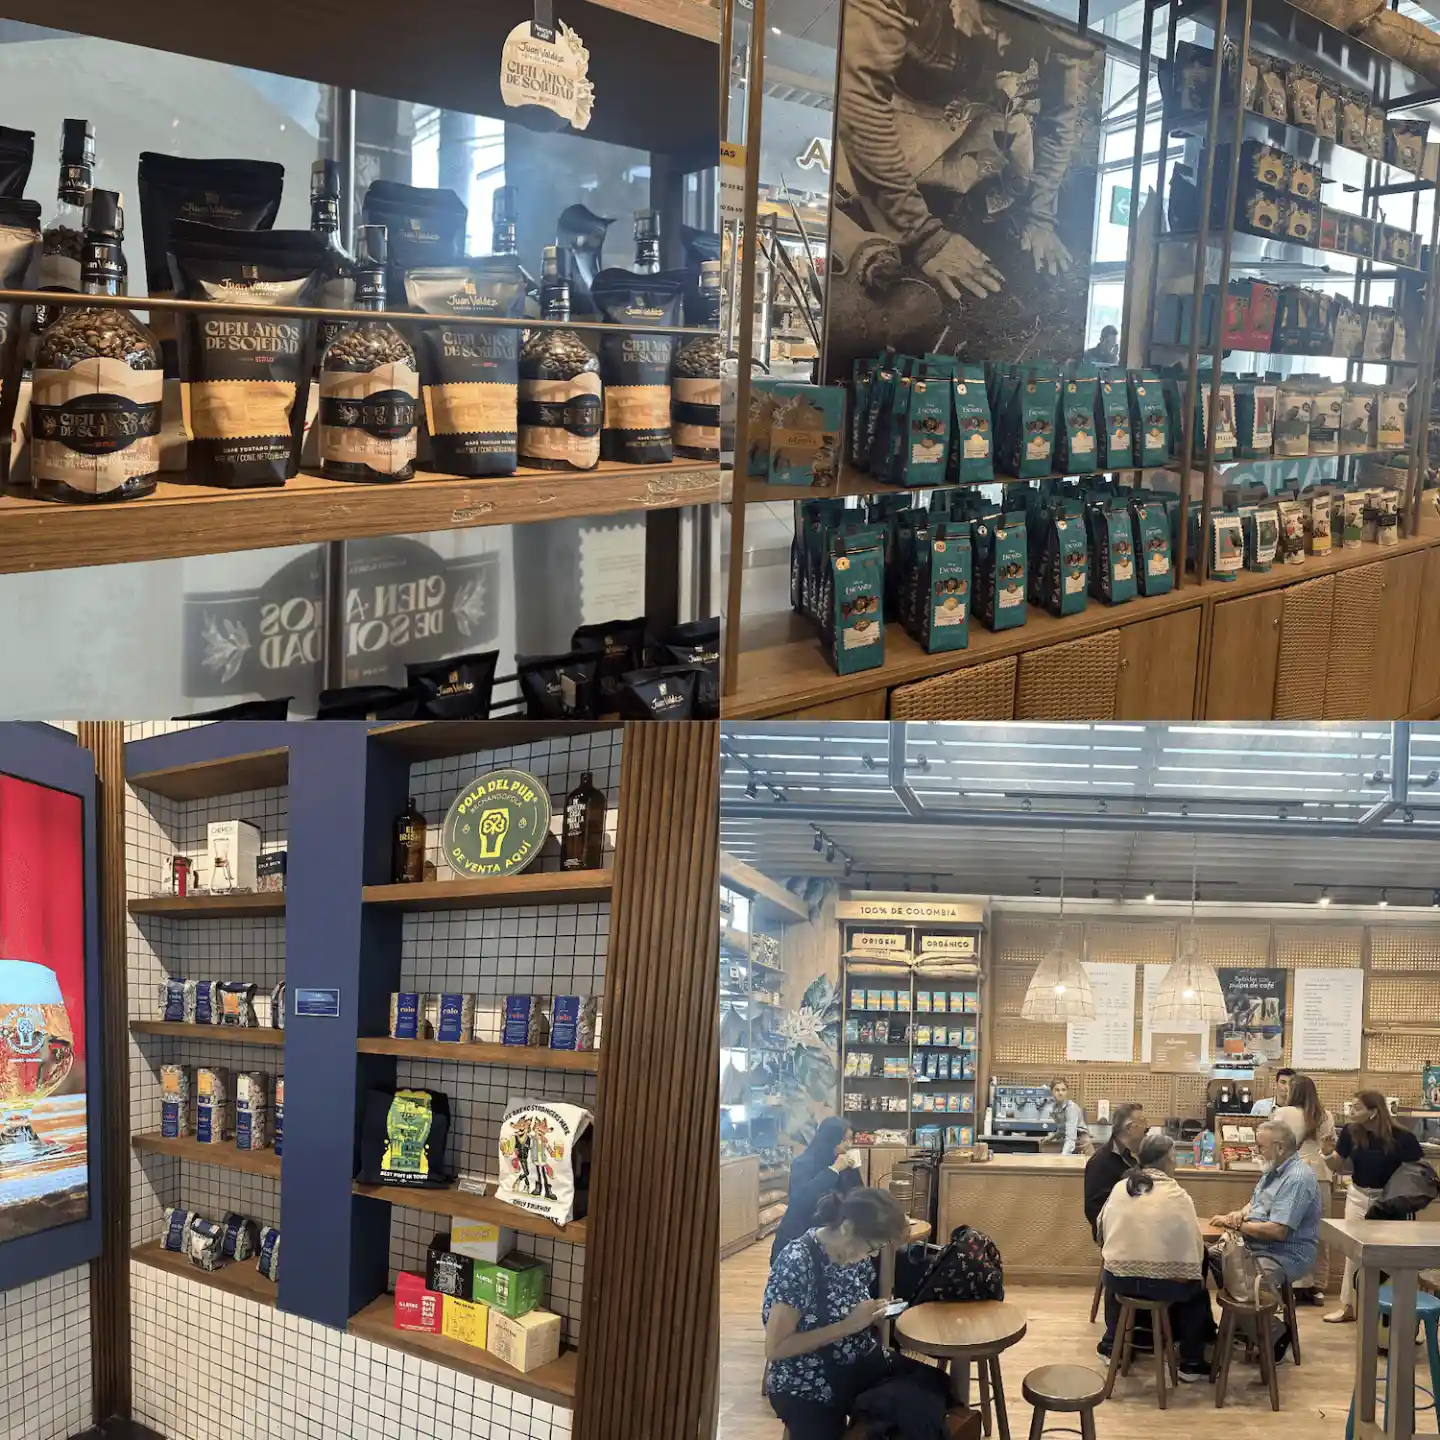
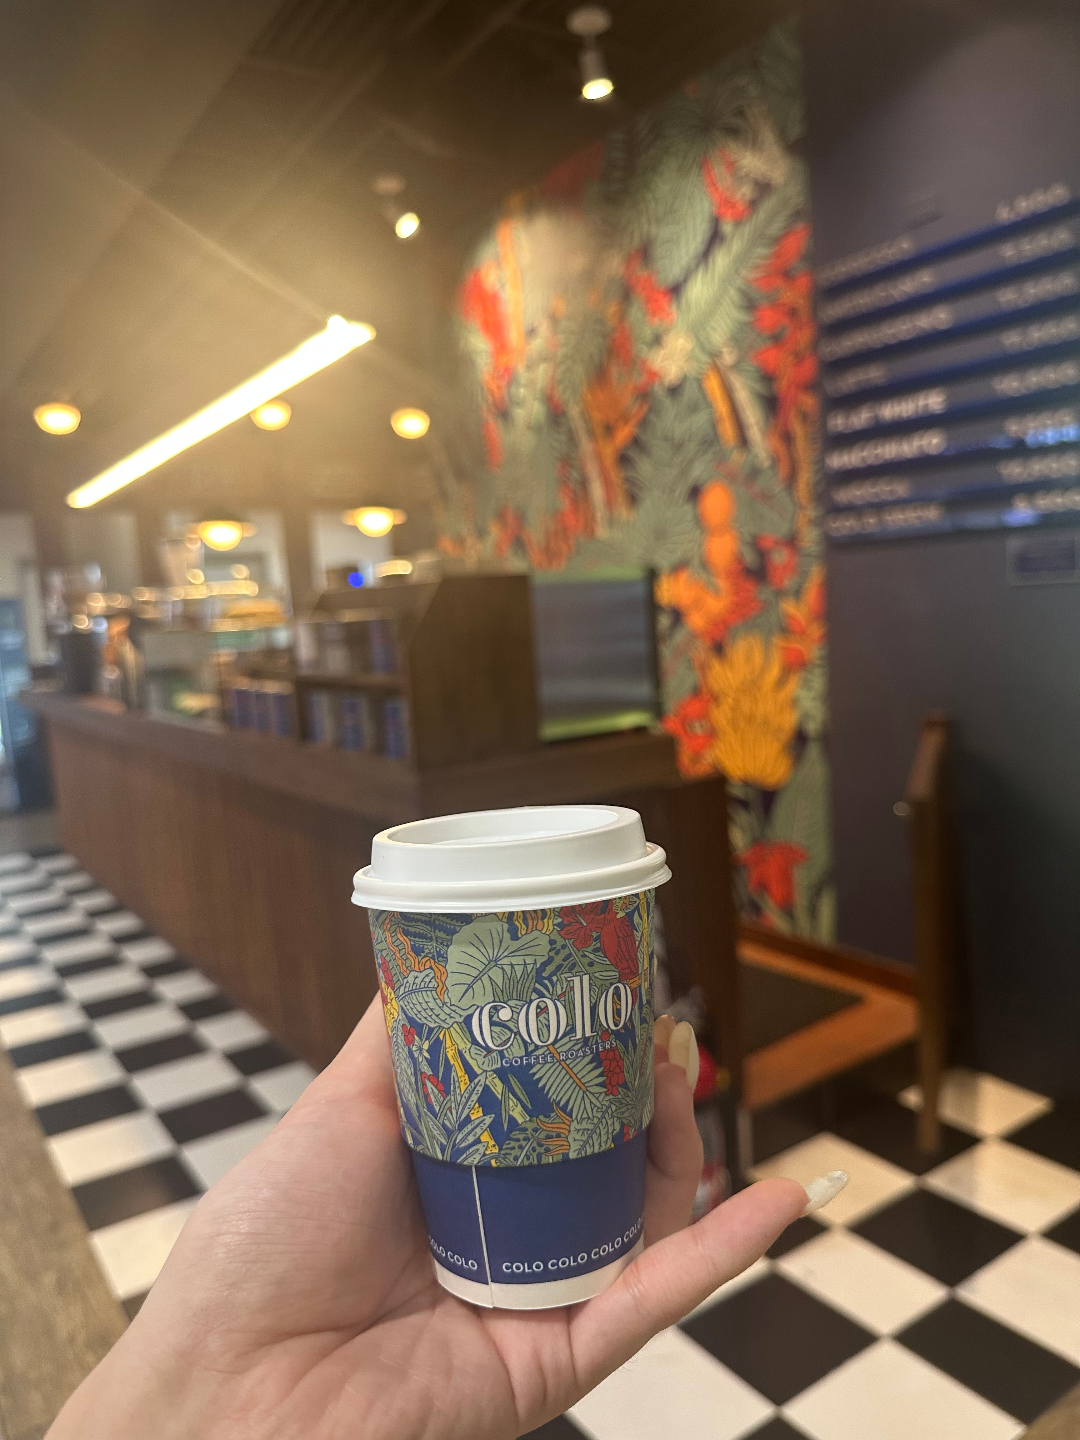
随便找了一家咖啡店来了杯 v60 的手冲,价格不算便宜,机场里快赶上美国的价格了。
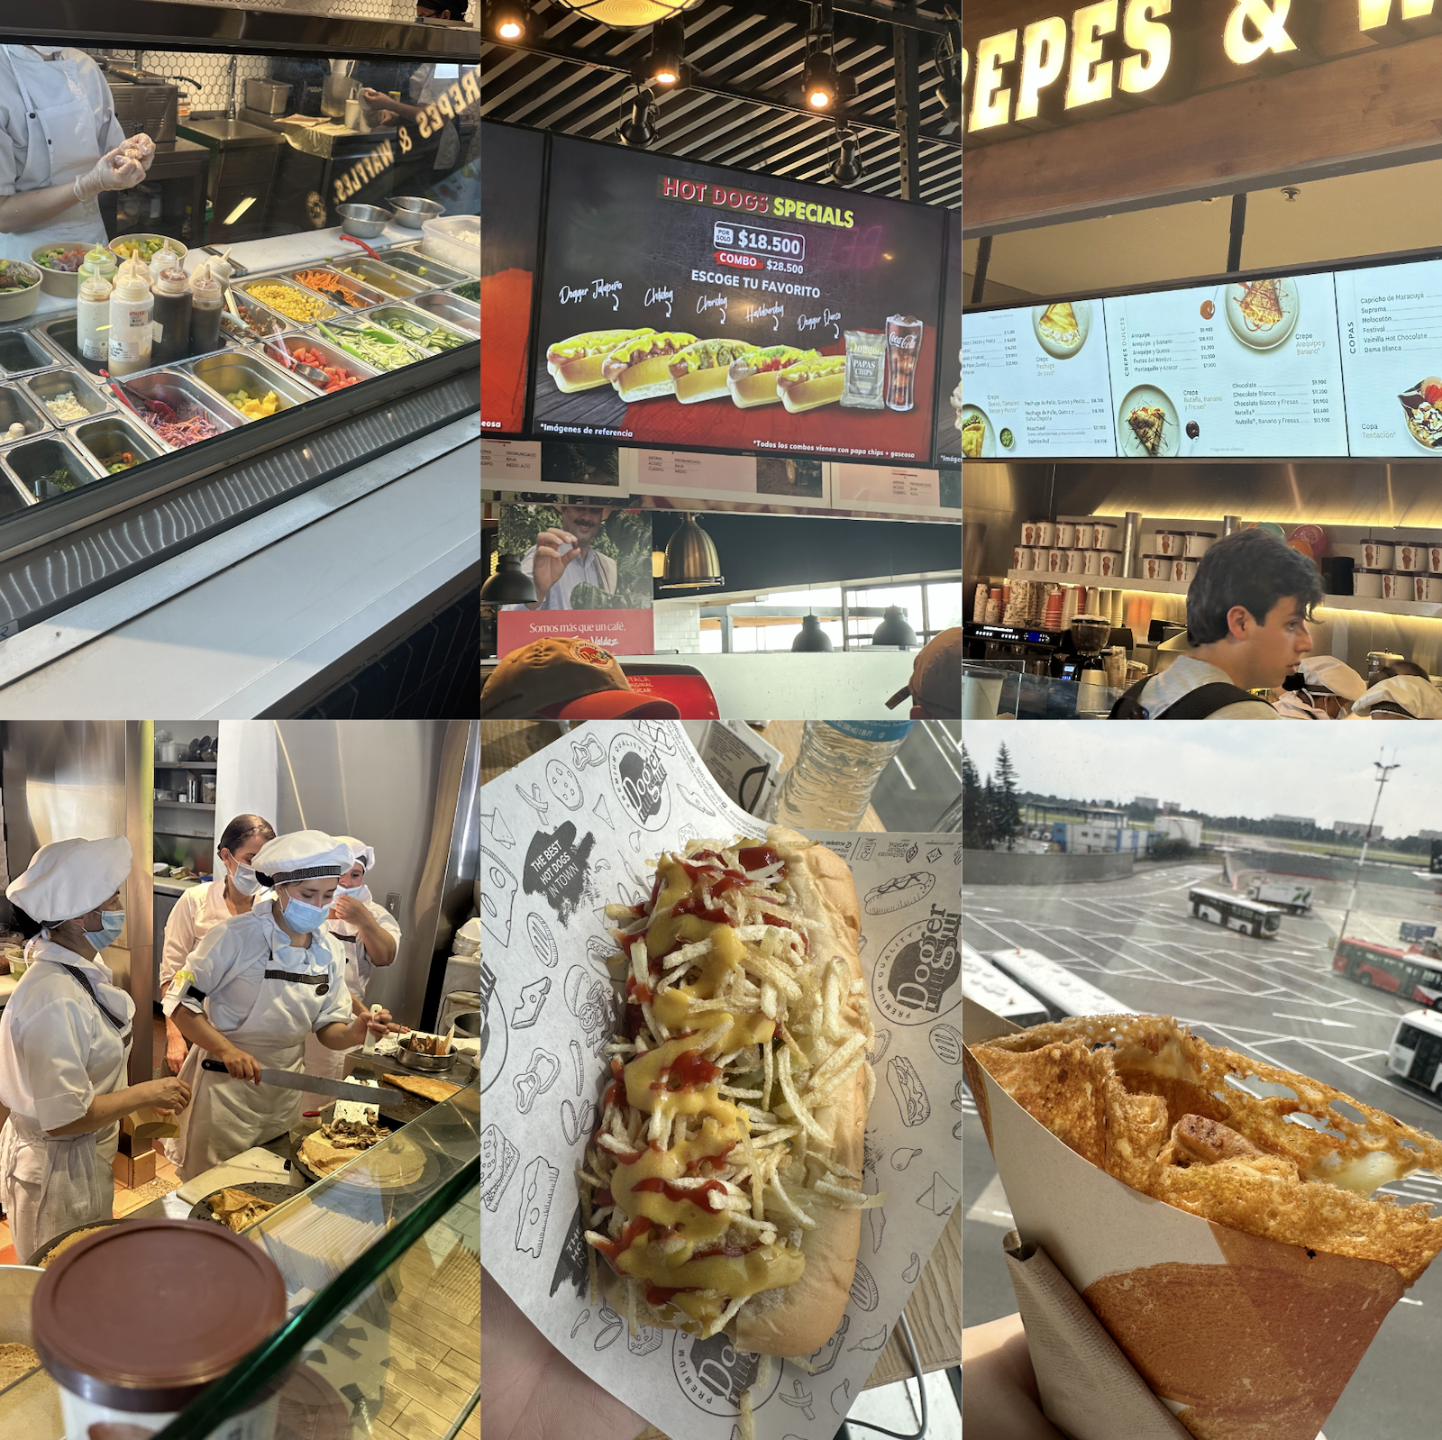
咖啡不能当饭吃,我们又盯上了机场内的其他吃的,选择还是蛮多的,比如有波奇饭、热狗、可丽饼。基本和不要钱一样...大概也就是个位数美金的价格,选择太多,不如全都尝尝。
### 到达麦德林
#### 机场
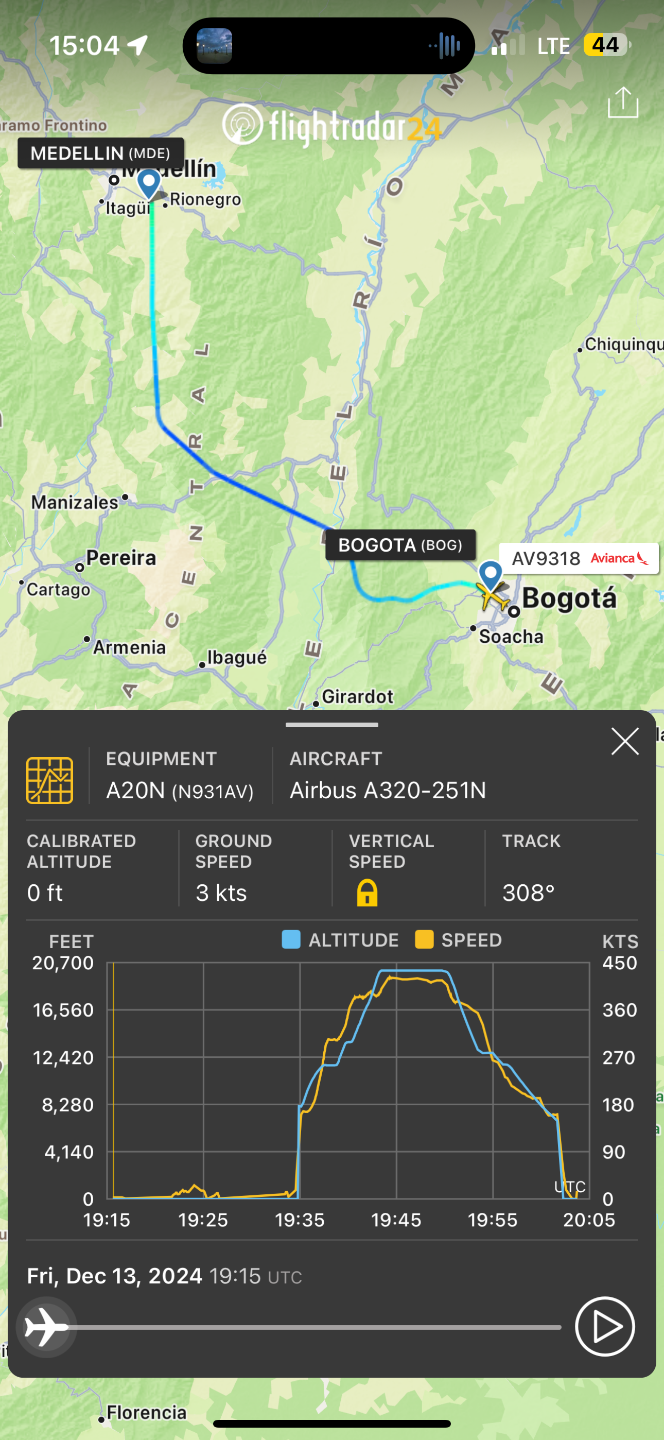
经过了十几个小时的赶路(这也太艰难了),终于顺利坐上了这只飞了半个小时的航班到了麦德林。要注意的是麦德林市区虽然在盆地里,海拔较低大概 1500m 左右,但机场是在山顶上的,海拔和波哥大市区基本一样,在 2600m 左右。
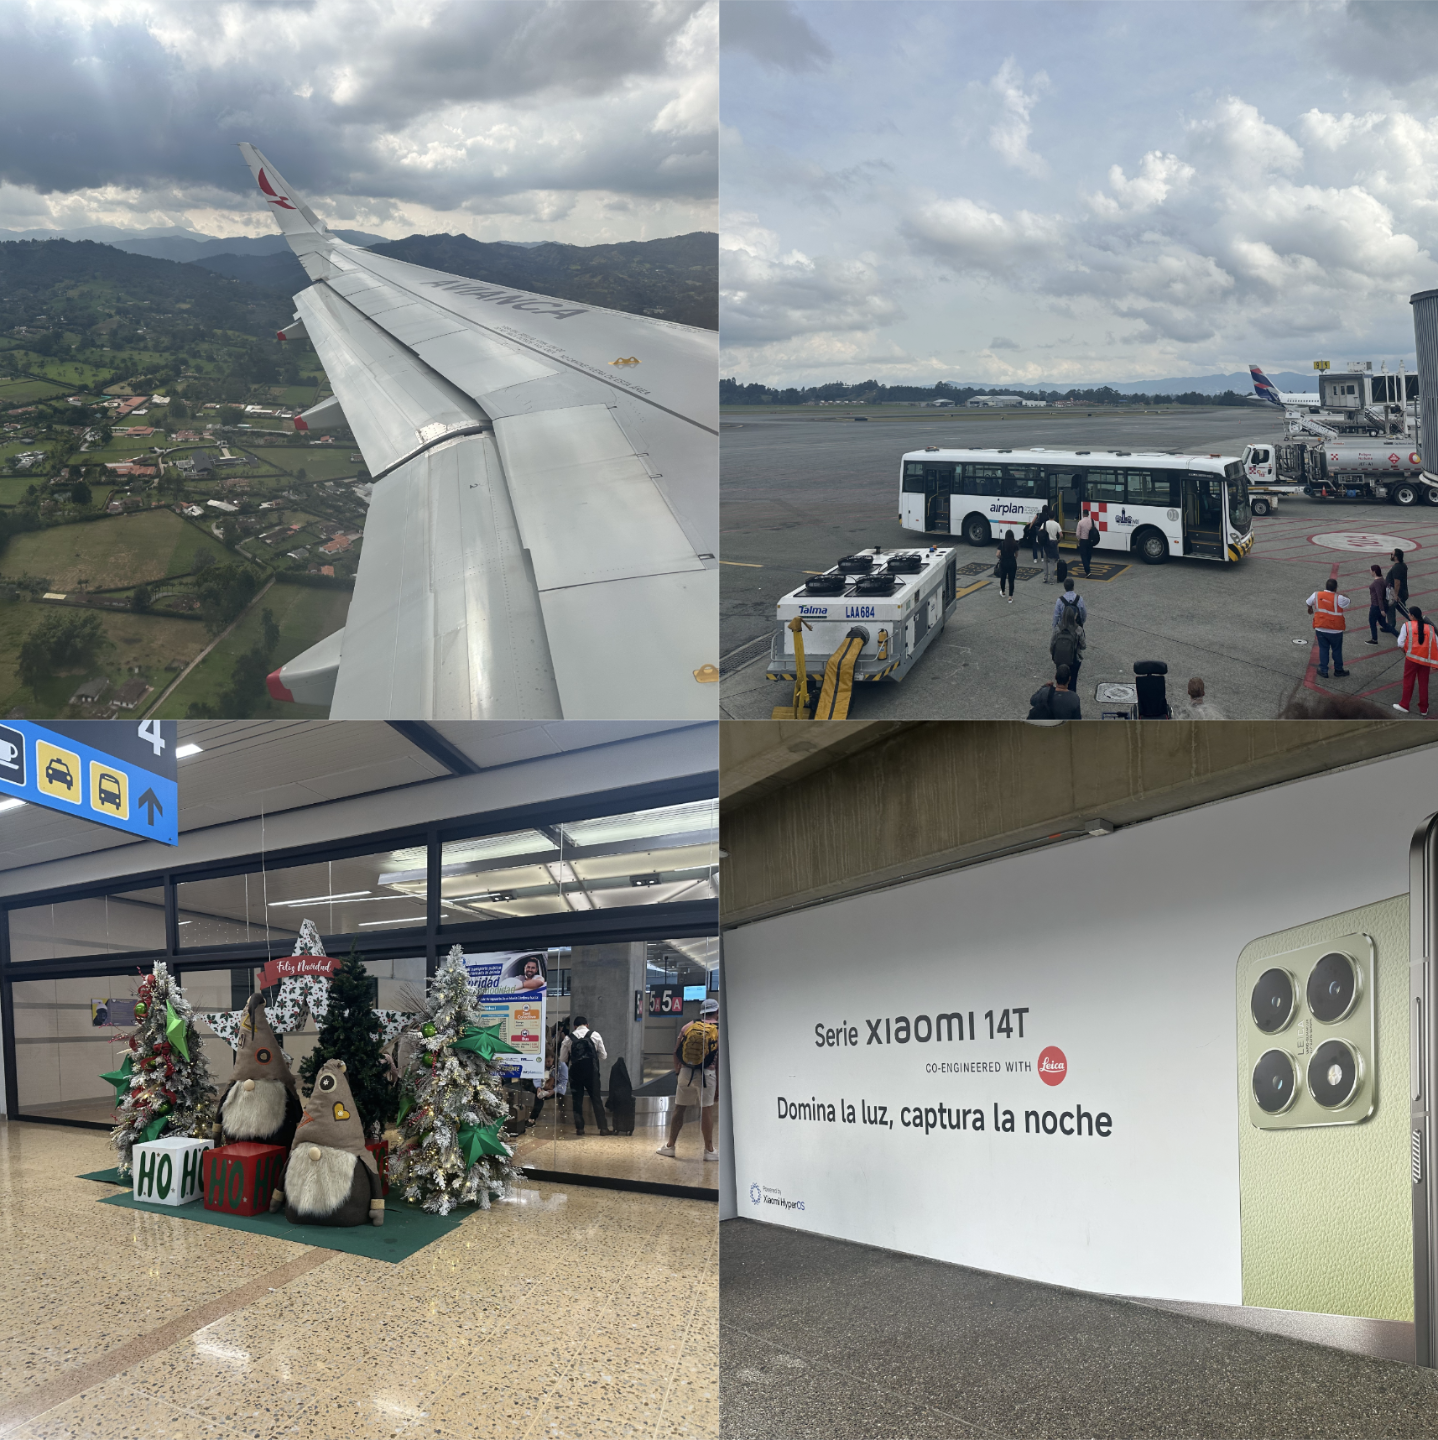
麦德林的机场本身实际上并不小(对比同体量的其他国家的机场),但落地的跑道、滑行道和停机坪看起来比较小。摆渡车感觉起来比较老旧,开的不可谓不猛,注意扶好。天主教国家,圣诞节日气氛是比美国要浓厚很多的,机场到达行李提取的地方出来可以看到有圣诞树和圣诞矮人(gnomes)的装饰。同时还可以看到小米的广告。
#### 第一顿正餐
没想到在到达哥伦比亚将近 24 小时后,我们才终于吃上了一顿正式的饭!💦 因为我们到达酒店的时候时间还不算太晚,于是决定步行前往餐厅,大约需要 15 分钟的路程。这个决定也让我们有机会稍微感受一下城市的夜晚氛围,顺便熟悉周围的环境。毕竟原本计划在这里待两天,却因为延误硬生生少了将近一天的时间,我们更想抓住每一个可以探索的瞬间。
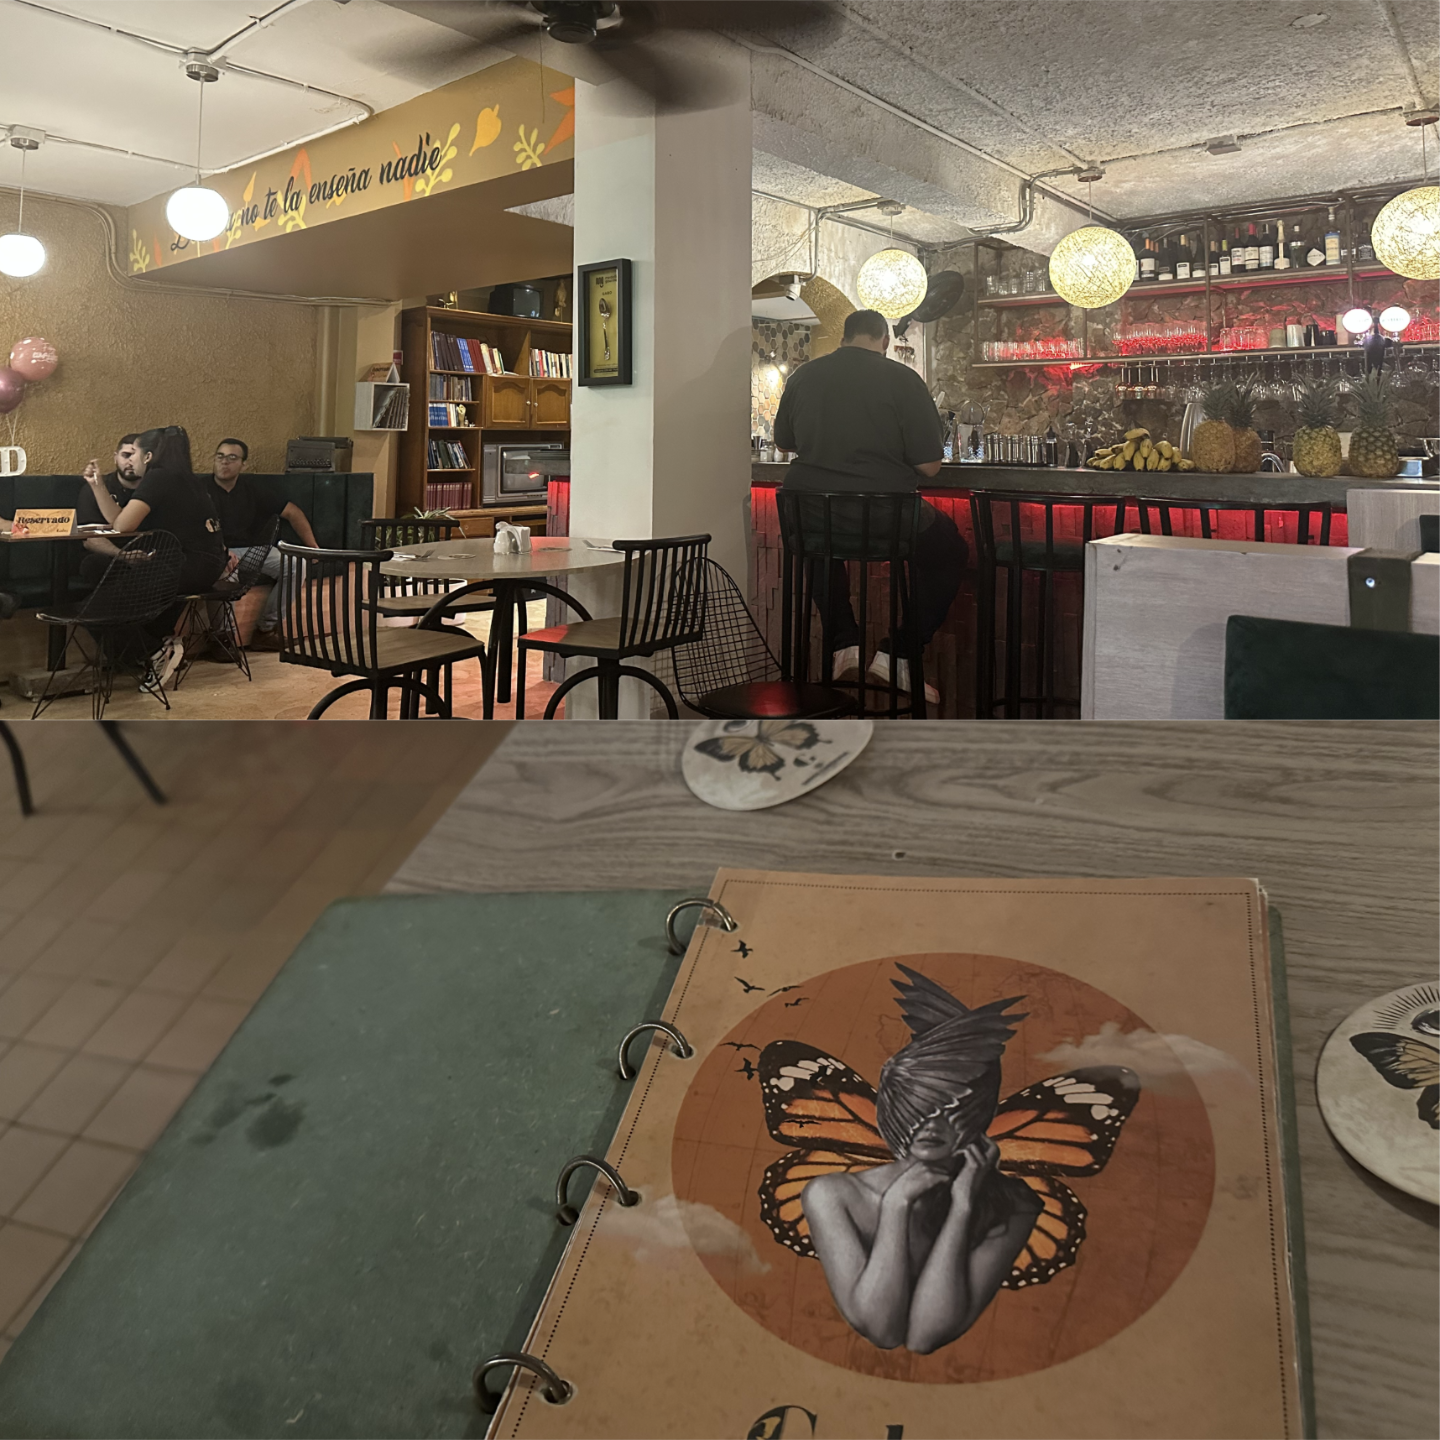
当晚我们选择了 [Restaurante Gabo.mde Poblado](https://maps.app.goo.gl/gER9CG38hnGdh9c68),一家带有浓厚文艺气息的餐厅。从餐单的设计到整个空间的布置,处处透着一股别具匠心的韵味。这家餐厅的名字 “Gabo” 是对哥伦比亚文学巨匠 加夫列尔·加西亚·马尔克斯(Gabriel García Márquez) 的致敬。
作为魔幻现实主义文学的代表,马尔克斯通过他的经典作品,如《百年孤独》和《霍乱时期的爱情》,将哥伦比亚和拉美的文化、历史以及人们的生活深刻地展现在世界面前。餐厅的艺术装饰似乎也在传达一种“魔幻现实”的氛围——比如菜单封面上那幅融合了蝴蝶翅膀与女性剪影的插画,仿佛是一场视觉和想象力的奇妙旅程。这种设计风格,既赋予了空间一种超凡脱俗的文学气息,也让人感受到马尔克斯笔下那种丰富的拉美文化色彩。
餐厅环境舒适而富有特色:低调的灯光、复古的木质桌椅以及色彩鲜明的装饰品为整个用餐体验增添了温暖的基调。酒吧区陈列着五彩缤纷的热带水果和酒品,仿佛在诉说着哥伦比亚的热情与活力。背景音乐悠扬动人,为我们享受这顿晚餐创造了一种安静又充满故事感的氛围。
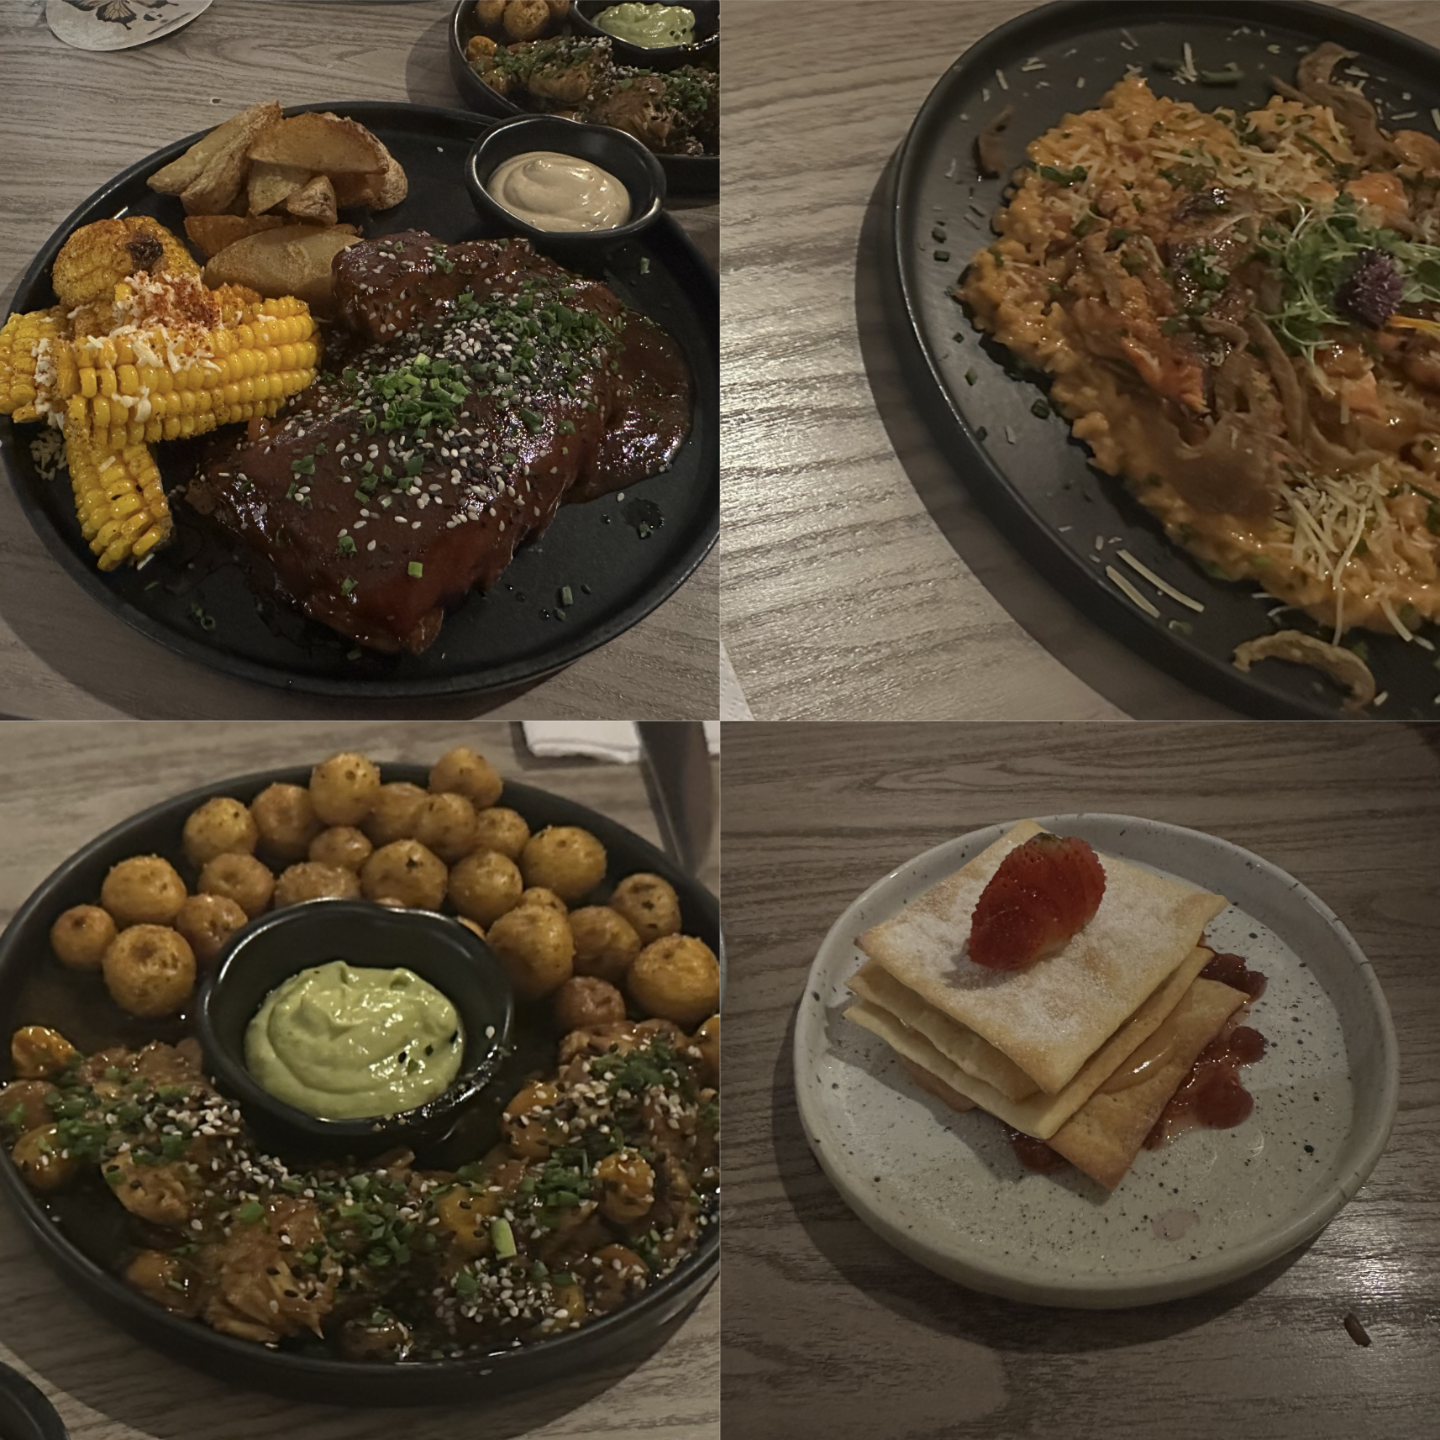
令人欣喜的是,这里的服务非常友好且贴心。服务员会说英语,而且提供英文菜单,即使对当地语言不熟悉也完全不用担心交流问题。我们在服务员的耐心推荐下,最终选择了三道菜:
- Pork Ribs with Guava BBQ:用番石榴 BBQ 酱烹制的猪肋排,搭配香烤玉米和乡村风格大块薯条,果香浓郁,口感层次分明。软烂滑嫩不油腻,番石榴的味道浸入了猪排深处;
- Creamy Rice with Chicken and Chorizo:奶香浓郁的米饭,佐以烟熏香肠和嫩滑鸡肉,入口即化,充满家的温暖感;
- 还有一道类似 猪油渣和小土豆 的菜品(虽然忘了名字,但印象却非常深刻),小土豆外皮香脆,内里绵软,与香气十足的猪油渣搭配得恰到好处,猪油渣并不是类似国内比较脆没什么肉的那种,肉还蛮多的,搭配牛油果酱,极具特色。
结账可以刷 AMEX,人均大概 20 美金,对比美国的价格可以说无比实惠了,还是在点了甜品与饮品的情况下。
## 第二天:麦德林
### 早餐百香果与酒店楼下咖啡
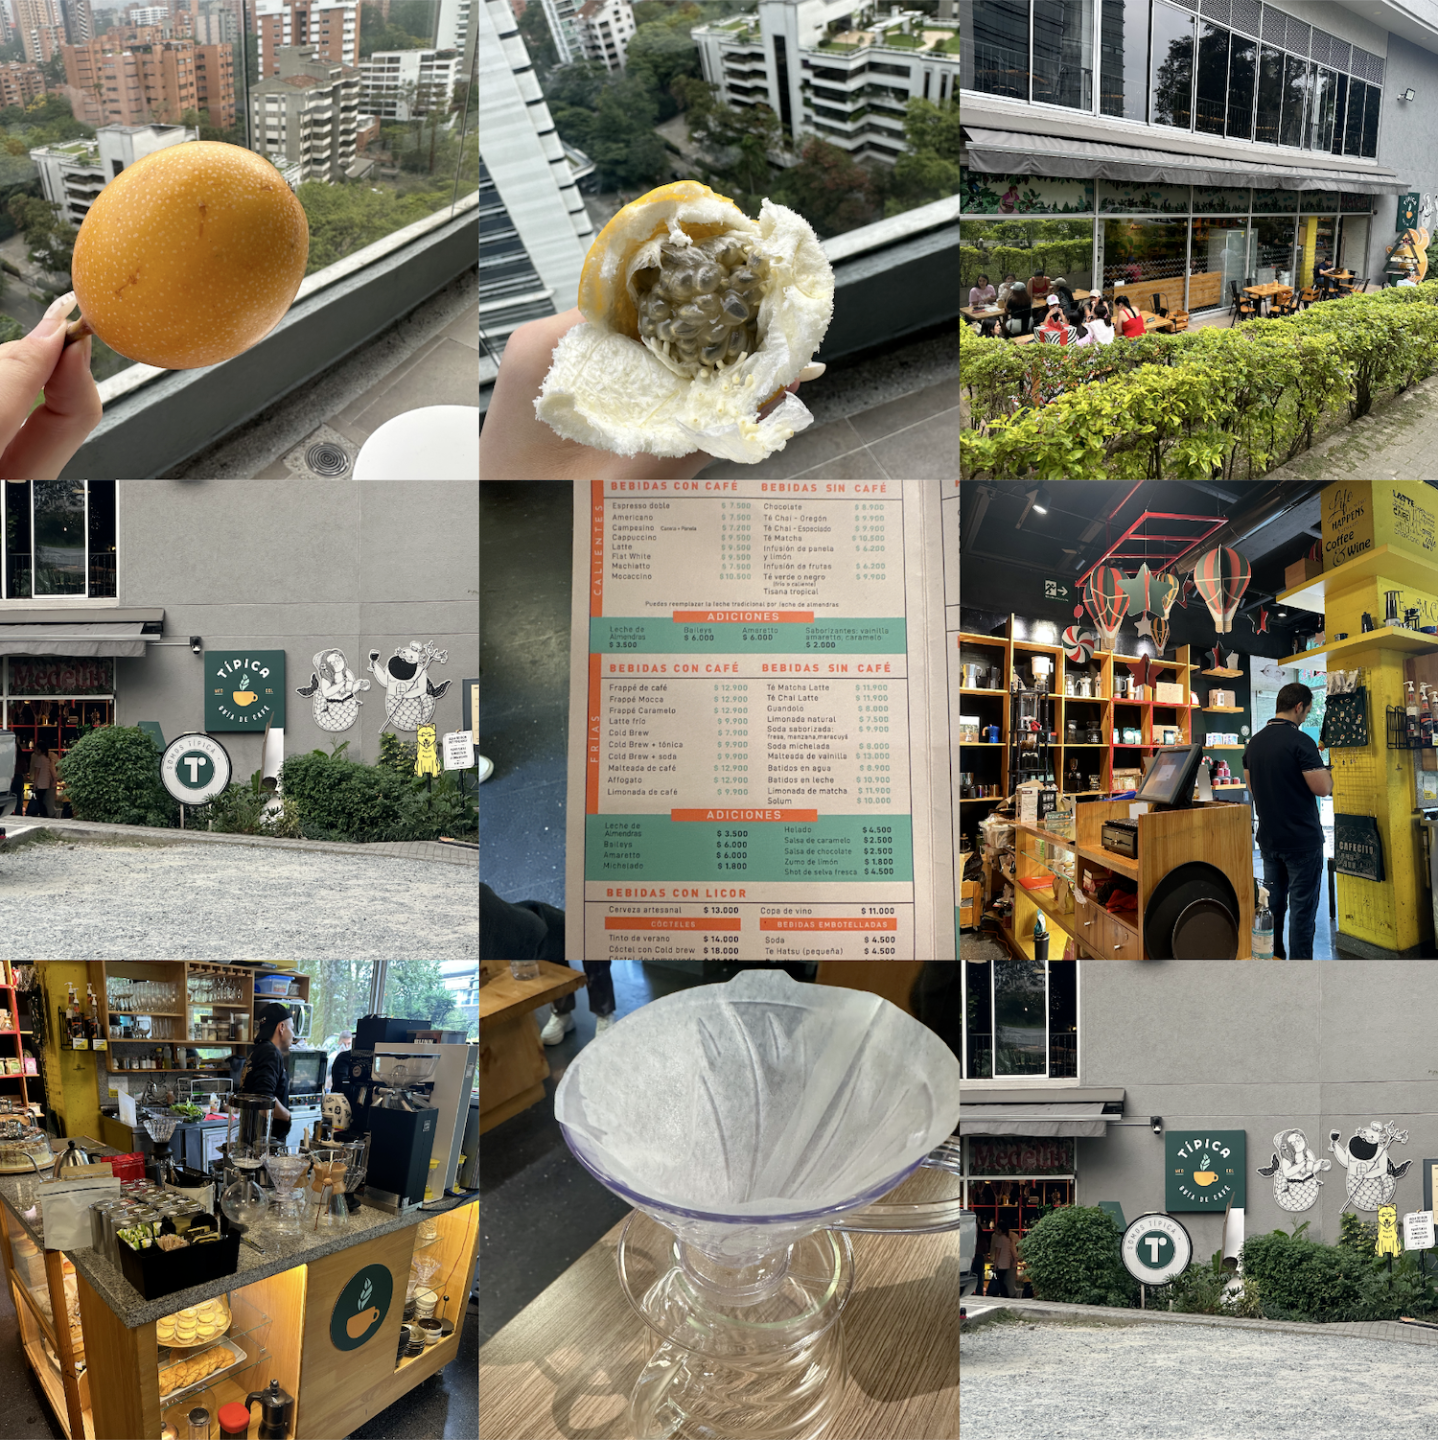
早晨,桌上摆着几个从没见过的黄色果子,样子有点奇怪,于是拿了一颗试试。外皮摸起来像硬纸,手感特别。小心剥开后发现,里面的结构竟然和百香果非常相似!查了一下才知道,这是一种哥伦比亚特有的百香果品种,搜了一下好像在云南也有种植,但价格高达 40-50 元人民币一颗,非常奢侈。幸运的是,酒店早餐是免费的,于是我们毫不犹豫地一人吃了三颗。😋
口感上,这种百香果和普通的百香果相似,但汁水更加丰富,甜味和香气特别浓郁,每一口都让人感受到热带水果的热情与阳光的味道。这样的早餐体验让人觉得麦德林的早晨也多了一丝奇妙与新鲜感。
早餐后,我们来到酒店楼下,走进了昨天散步时路过的一家咖啡店。店门口的美人鱼图案让人联想到星巴克,但又多了一份拉美的独特气质。但因为语言不通,我们一开始根本无法和店员沟通,正当有些迷茫时,碰巧有一位美国大哥出现在我们身后。他似乎注意到了我们的困境,热心地用流利的英语问我们是否需要帮助。
在他的帮助下,我们成功点到了一杯 V60 手冲。豆子的风味让人眼前一亮,浓烈的哈密瓜香扑面而来,烘焙度偏浅,酸值干净明亮,几乎没有苦感,整体呈现出一种极为愉悦的果味调性,仿佛在用味觉告诉我们麦德林的一天应该如此明快地开始。
### Sculpture park Nutibara Hill
我们的行程在出发前一周才匆忙安排,加上航班误机,时间被压缩得有些紧张。来到 Nutibara 山(Cerro Nutibara) 的时候,我们其实是把这里和下一个要去的景点搞混了。不过,这种“误会”却带来了意外的收获,让我们更深入地感受到了拉美文化的独特之处。
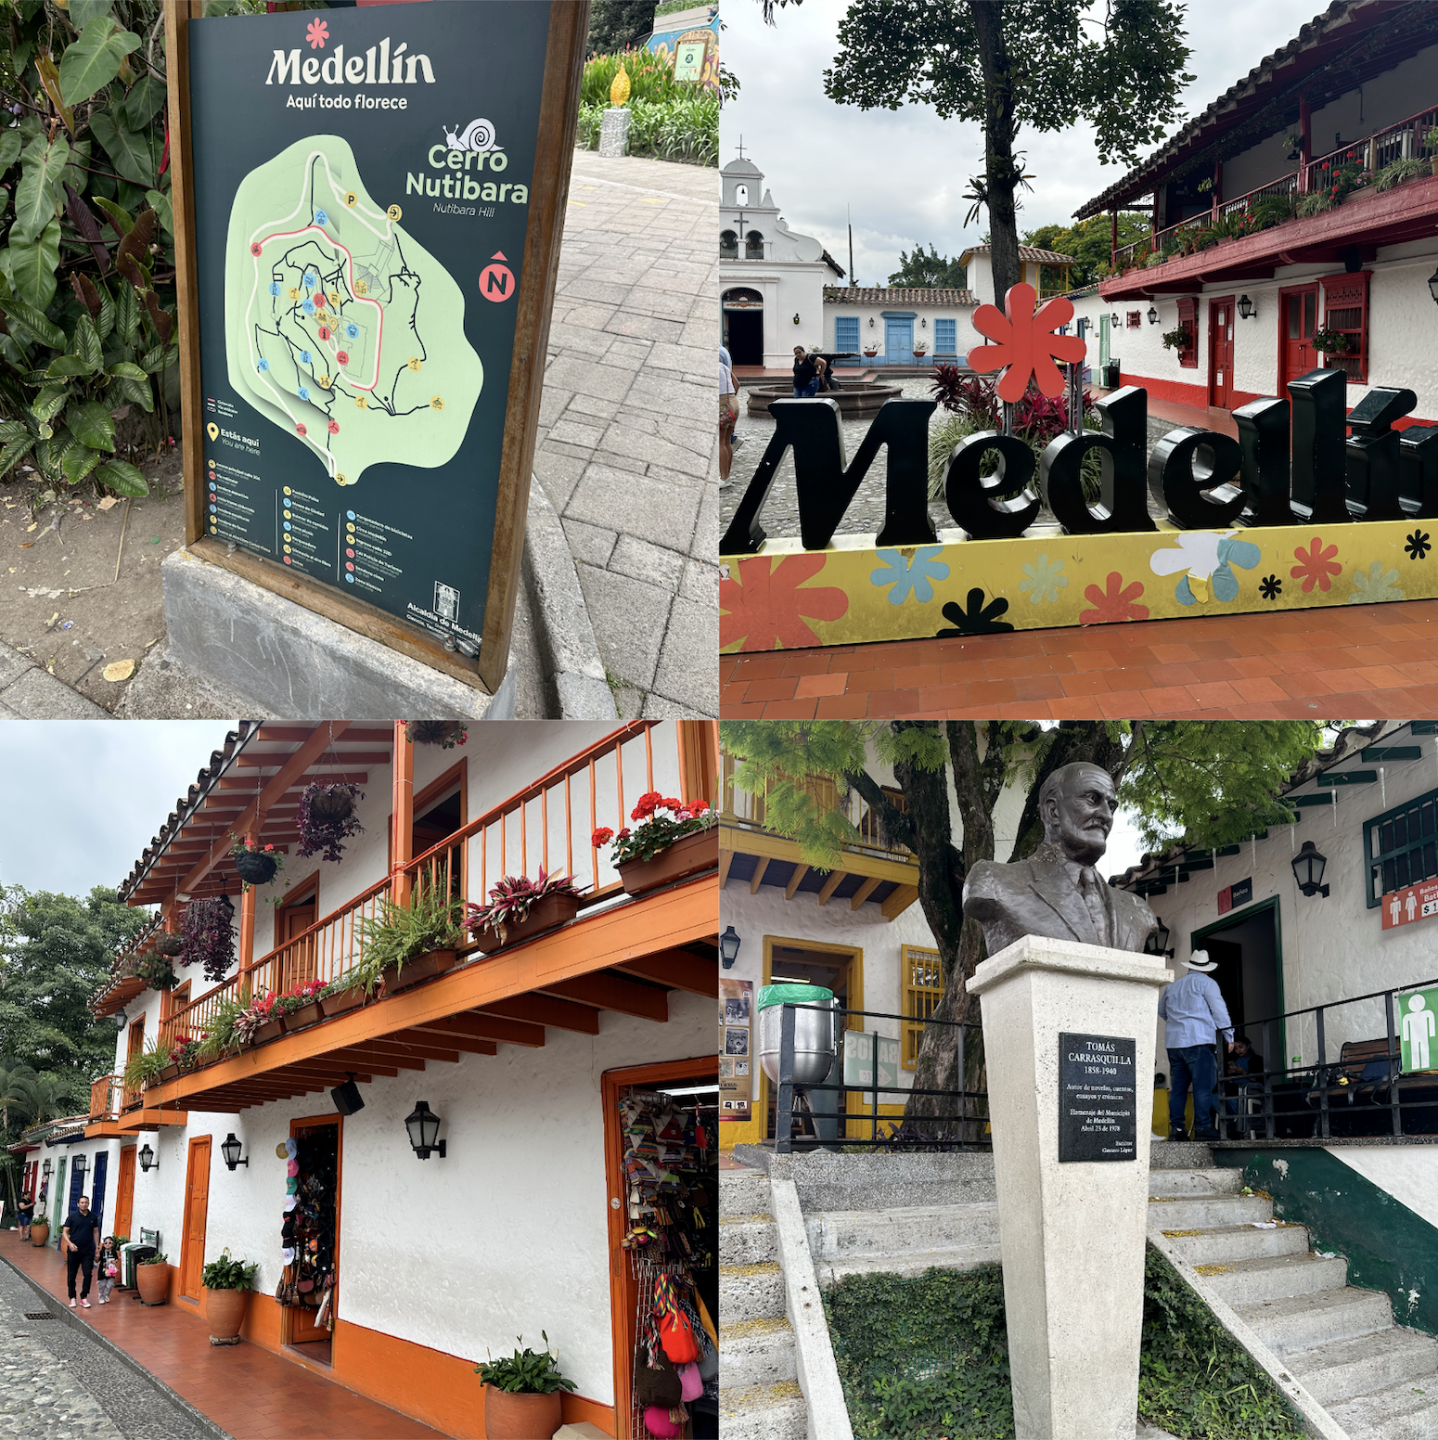
Nutibara 山上的雕塑公园是一片融合了艺术、文化和自然景观的地方,公园里到处可见哥伦比亚传统建筑的复刻版,还有许多色彩鲜艳的小店铺,卖着当地的工艺品和纪念品。这里也有纪念人物的雕像,比如哥伦比亚作家 Tomás Carrasquilla 的半身像,他的作品对哥伦比亚的文学和文化发展有着重要影响。这些雕塑和建筑风格都传递着浓厚的拉美文化气息,仿佛在诉说这片土地的故事。
不过我们到达时是白天,视野开阔,但城市的全景显得有些凌乱,缺乏震撼力。如果时间充裕,更推荐傍晚或夜晚来这里观景,夜幕降临时,麦德林的灯火会勾勒出完全不同的迷人轮廓。而相比之下,如果想要更深刻的文化体验,13 区(Comuna 13) 的贫民窟壁画之旅会带来更强烈的视觉和情感冲击。
### 参观13区
我们的原计划是先乘坐缆车俯瞰麦德林的全景,感受这座山城的壮丽景色,然后再前往著名的 13区(Comuna 13)。不过,Uber司机却直接将我们拉到了13区的入口,让我们跳过了缆车的部分。这虽然打乱了一点计划,但也为我们节省了时间,得以更专注地体验这个区域的独特文化与历史。
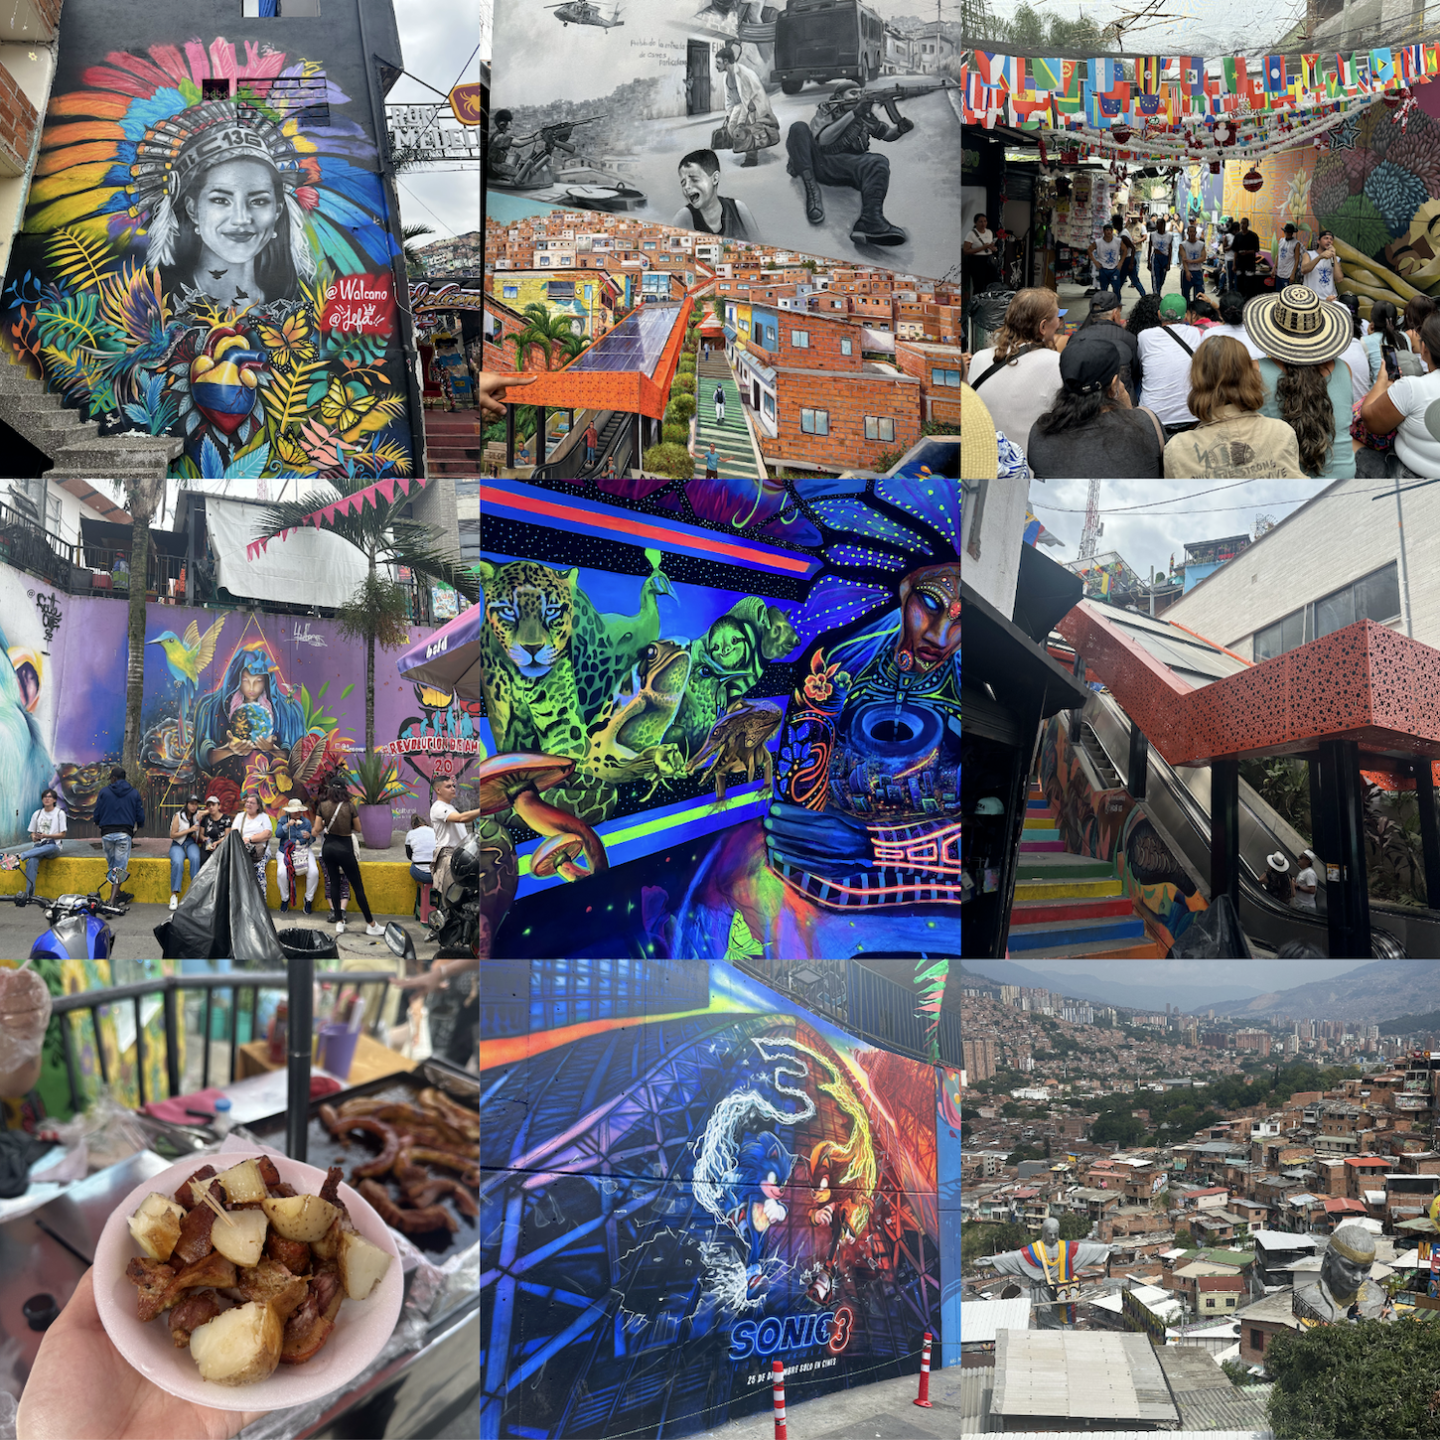
13区曾经是全球闻名的暴力高发地之一,也是巴勃罗·埃斯科巴时期毒品交易的核心地带。当时,这里是贩毒集团的“后花园”,以其复杂的地形和贫穷的居民区成为犯罪分子的天然庇护所。导游向我们详细讲述了这段黑暗历史,以及自埃斯科巴被击毙后,这里经历了怎样的剧变。居民们通过艺术和社区改造,逐渐摆脱了过去的阴影,将这个区域打造成了一个充满希望和活力的地方。
一个有趣的事实是,这个地区现在完全没有警察驻守。导游解释说,这是因为当地居民已经形成了一种自我管理的机制,警察的介入反而会引发更多矛盾。这里的安全感更多来自于社区的团结和内部秩序,而不是依赖外部力量。
我们跟随导游参观了区域内的众多壁画,每一幅都讲述着一个故事。从表现当地居民生活的绚丽画作,到反映社区历史的黑白壁画,艺术已经成为这里最有力的表达形式。导游还带我们见到了著名的“Las Madres de la Candelaria(坎德拉里亚母亲协会)”,这些坚强的女性是推动区域变革的重要力量,为了失去的亲人,她们发起了争取正义的斗争,也为社区注入了希望。
除了艺术,这里安装的 电动扶梯系统 也引人注目。过去,这里的居民需要攀爬数百级陡峭台阶,如今,这套扶梯不仅改善了他们的日常生活,也成为区域变革的象征。
我们还看到了一些著名的网红地标,比如象征团结的巨大雕塑“La Mano”,以及用丰富色彩和大胆线条描绘的震撼壁画。这些作品不只是视觉上的享受,更是社区居民努力的成果,充满了生命力和创造力。
当然途中我们也尝试了这里的街头小吃,炸五花肉、猪皮、下水等配土豆的组合,搭配了牛油果酱,口感丰富,非常适合我们的口味,让人感受到浓浓的地道风味。
当然最有趣的莫过于我们一路上被南美人拉着合照,看着到处写着的拍照收费 2000COP 的标识,我们觉得我们需要在脖子上挂个牌子也写上拍照收费了(笑)。
### 当街毒品交易
当我们乘车经过 Plaza Rojas Pinilla(就在 Plaza Botero 的北边)时,司机特意提醒我们要关好车窗,甚至主动打开了空调(在这之前 20 分钟的车程都开着窗没开空调)。他解释说,这个区域非常危险,是毒品交易的活跃地带。我们也亲眼目睹了当街进行的毒品交易:一人手里拿着一小袋药片,另一人将现金递了过去。相较而言,大麻和大麻烟这种在美国比较常见的东西反而显得不那么突兀(反而闻到这些味道非常熟悉)。
### 胖胖博物馆
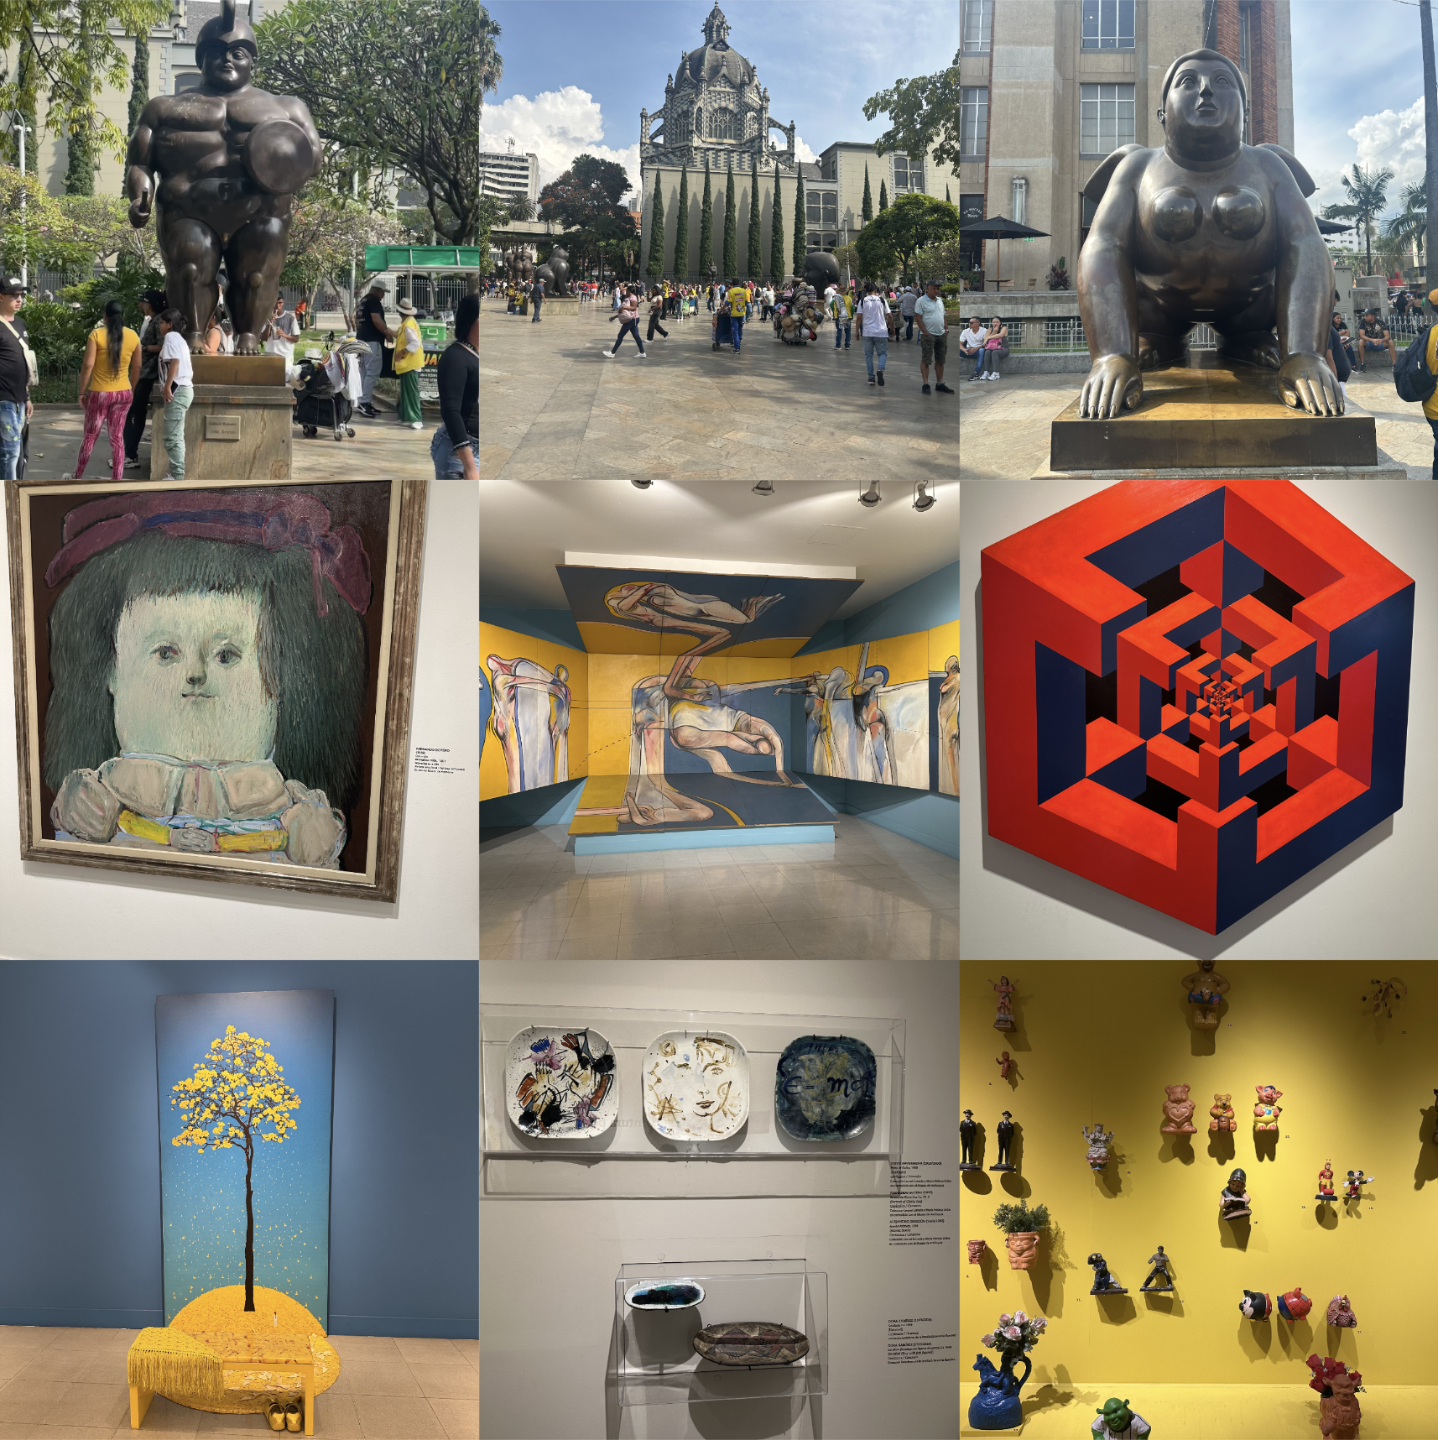
来到 博特罗博物馆(Museo Botero),我们终于得以一览这位哥伦比亚艺术大师费尔南多·博特罗(Fernando Botero)的独特艺术风格。博物馆坐落在麦德林热闹的 Plaza Botero,周围点缀着博特罗的经典雕塑作品,这些作品以夸张的体型和圆润的线条为特点,我称之为“胖胖风格”。
馆内收藏了大量博特罗的画作和雕塑,他将“胖胖”的元素融入到人物、动物甚至静物的描绘中,以独特的方式展现了丰富的情感和幽默感。除了博特罗的作品,博物馆还展示了一些现代艺术家的创意作品,包括视觉错觉的几何画、表现日常生活的装置艺术,以及带有浓厚拉美风情的陶艺。这里既有艺术的美感,也充满了文化的深度。
博特罗的胖胖风格并不以传统的审美标准为依归,却通过夸张的形式语言让观众重新思考体型、身份和社会的多样性。这一体验,让人感受到艺术不只是审美的延展,更是文化与思想的碰撞。
### 麦德林地铁体验
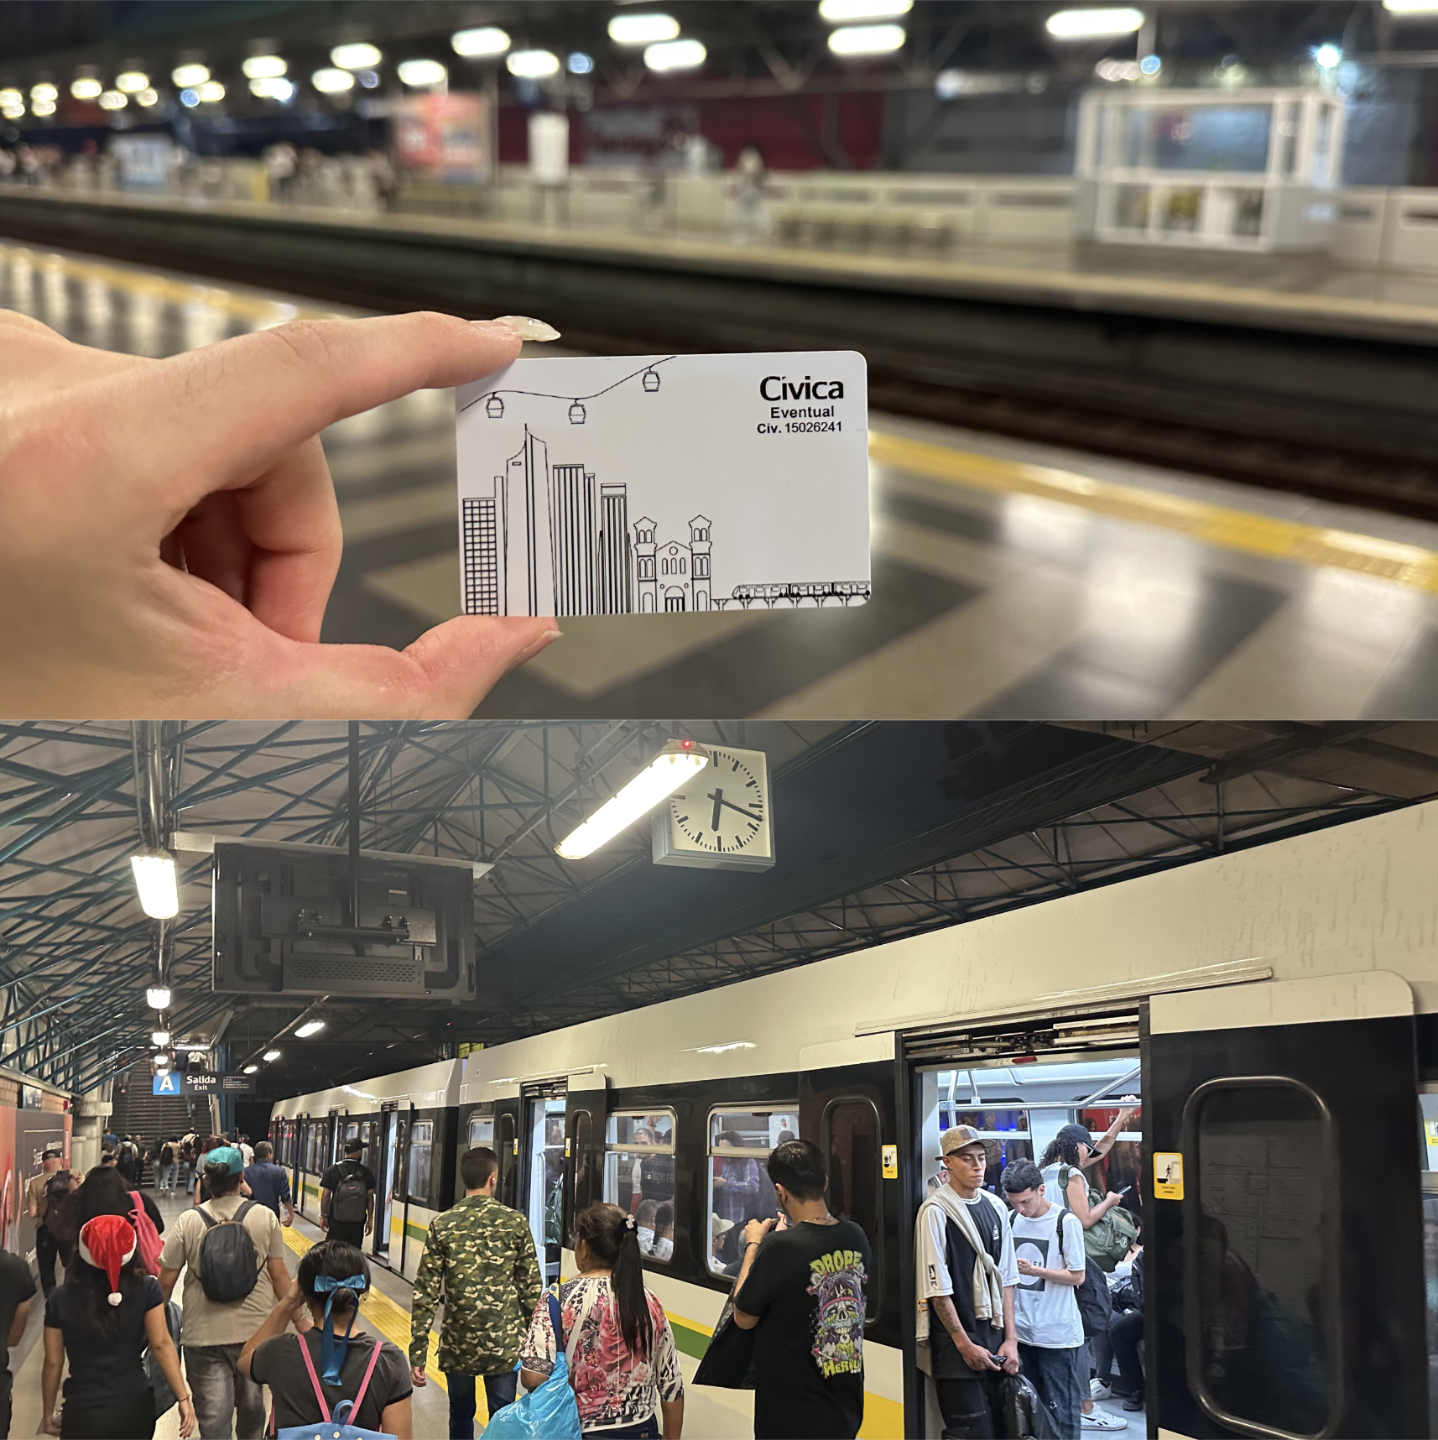
麦德林的地铁,比芝加哥地铁好上不止一亿、万亿倍!这条地铁线不仅平稳得让人惊讶,车厢也干净整洁,完全没有任何异味。根据名牌上标识的牌子,这些地铁由西班牙公司 CAF 制造生产的。但有一个有趣的细节是,地铁车门会在列车尚未完全停稳前稍微提前打开,这在其他地方是很少见的。
麦德林是全哥伦比亚唯一拥有地铁的城市,就连首都波哥大都没有这样的交通系统,这一点让麦德林显得尤为特别。不过,地铁票的购票方式可能会稍微复杂一些:你必须先办理一张地铁卡,卡本身需要 10000 COP 的押金,然后再充值支付地铁票价。地铁票是按次计算的,而不是按距离计费,这和芝加哥的地铁系统有点类似。所以一张卡可以给多个人用的。
### 晚上飞回波哥大
这次从麦德林飞回波哥大的航班经历可以说是“绝对难忘”。原定于晚上 20:19 起飞的航班,在我们从酒店提取行李去行李的路上,硬生生因为各种原因延误了整整四次,当我们到机场的时候,航班已经延误改时到了凌晨 00:44。
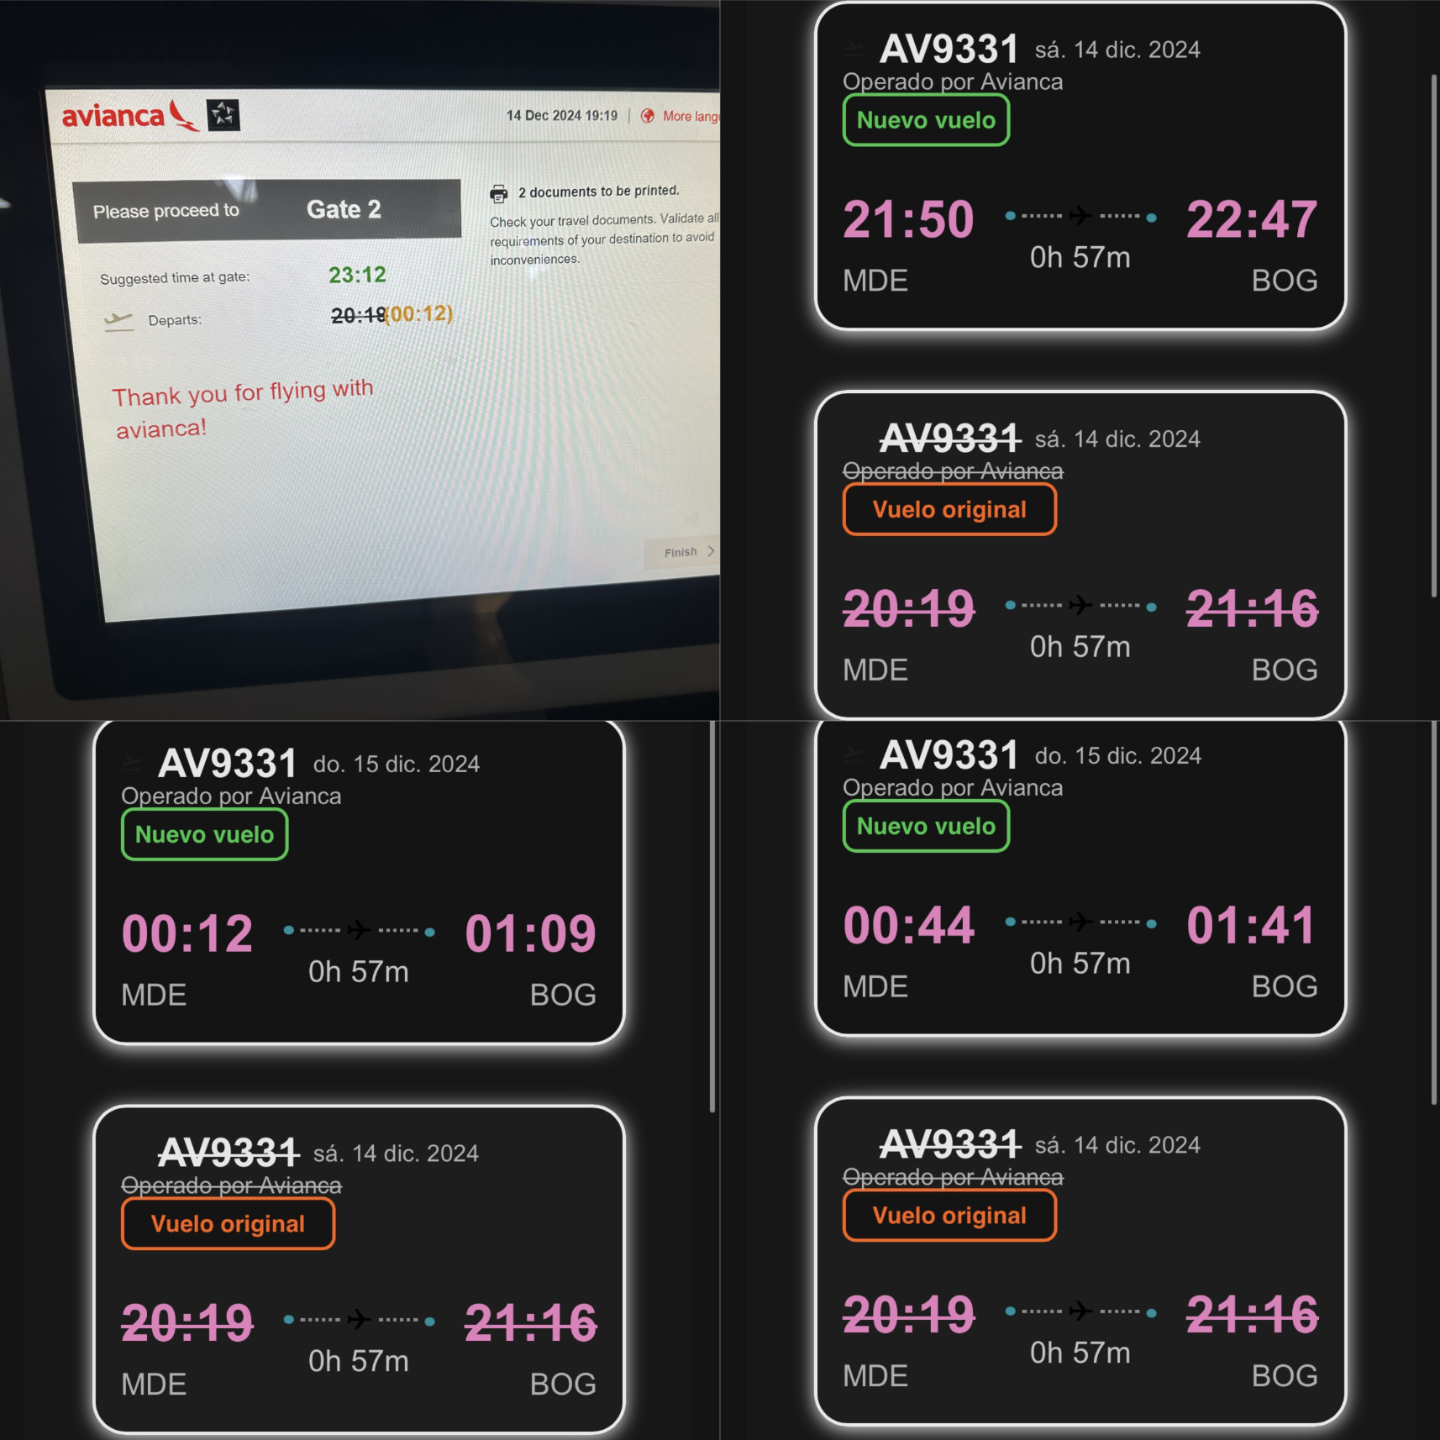
在改签时,难得会说英语,工作人员看到我们是外国游客,便好奇地问起我们从哪里来。当得知我们来自中国时,他显得有些惊讶,直接一句:“Why are you here? It's so far away.” 确实,我们对比中国的位置都已经快要到地球的另一侧了。
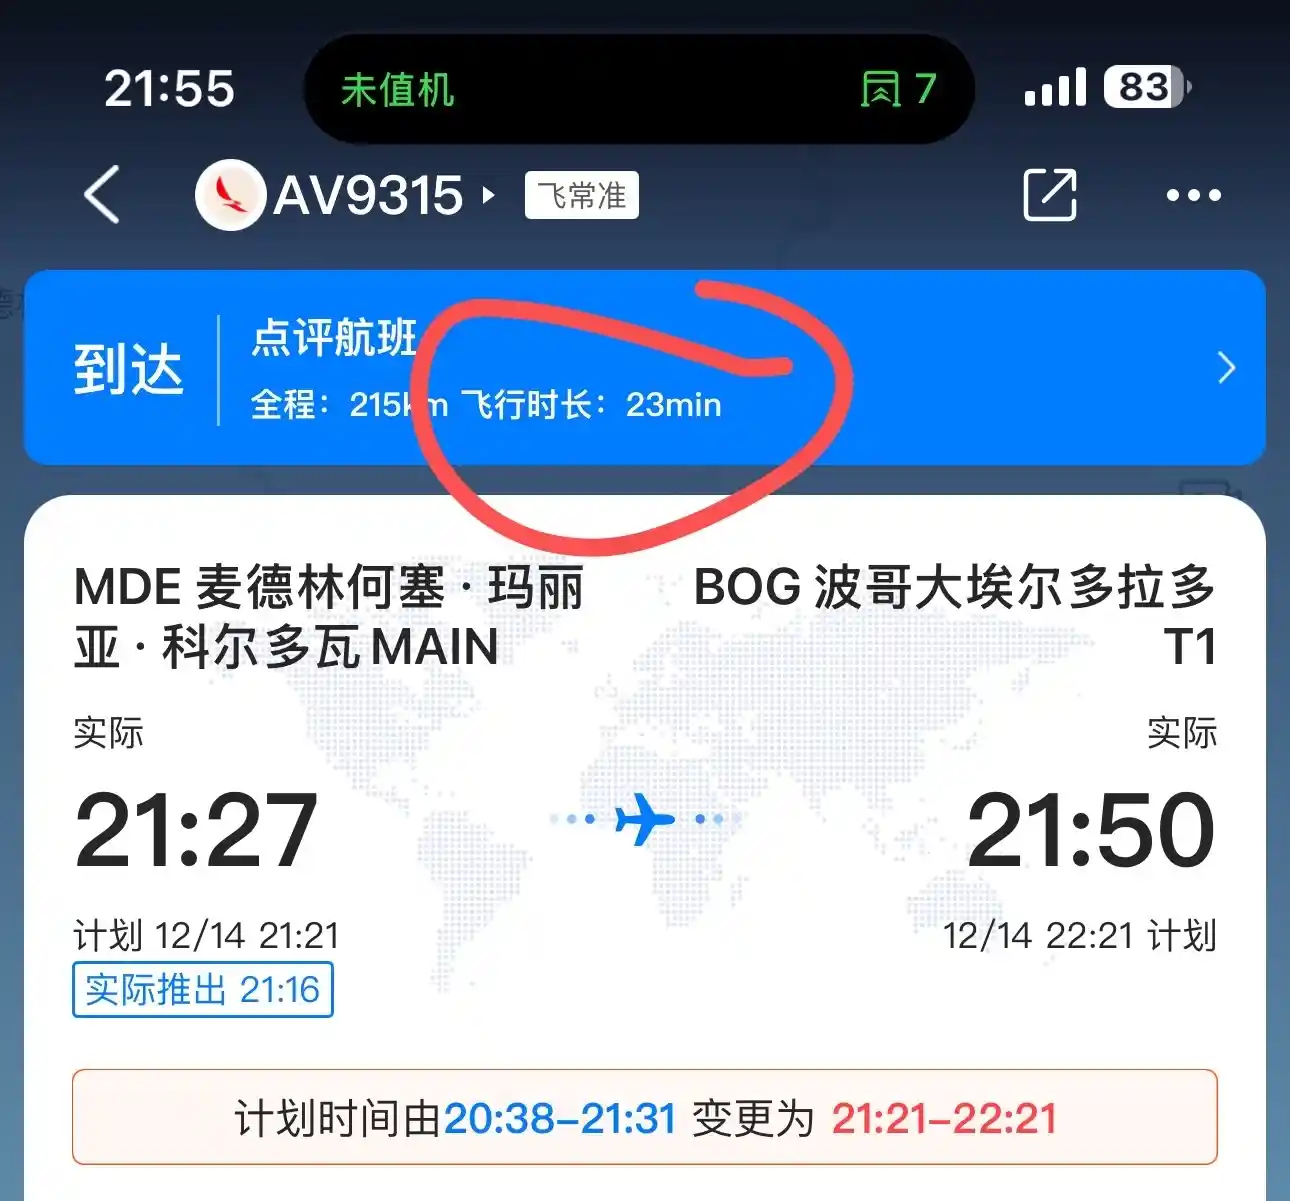
改签到了 21 点多的航班本来我们是蛮开心的,尤其是这趟航班只飞了 23 分钟,短到有点让人怀疑我们是不是到了。但“惊喜”还没结束,飞机降落后并没有直接到达登机桥,而是在波哥大的滑行道上停了将近1个小时。直到我们被送到一个远机位才终于下了飞机……
## 第三天:玻利瓦尔广场与黄金博物馆
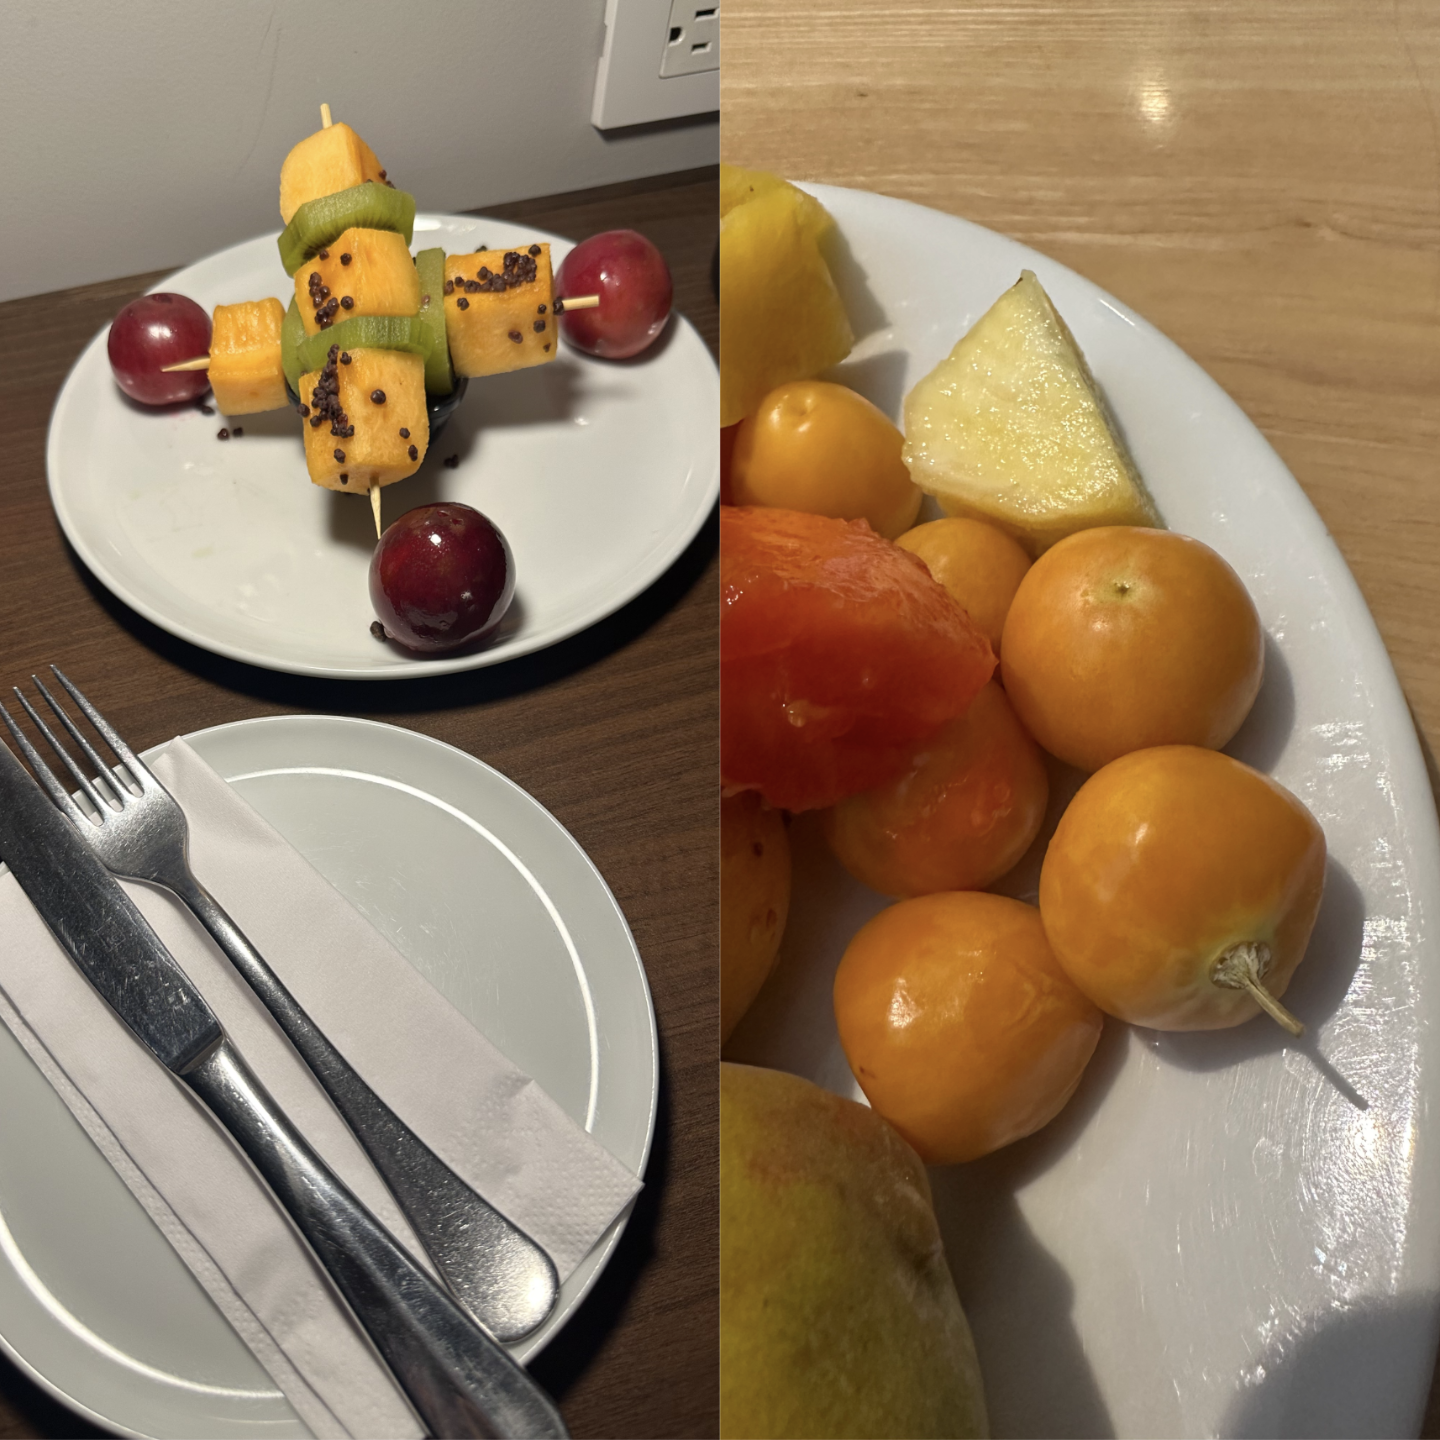
再次回到第一晚入住的酒店时,我们发现酒店贴心地为我们准备了一些欢迎水果,颇有些暖心的小惊喜。第二天的早餐更是让人眼前一亮,竟然有姑娘果登场!不过令人遗憾的是,这里的姑娘果是我在哥伦比亚吃到的所有水果中,唯一一个不如国内好吃的。它的味道偏酸,更接近美国的口感,缺少了国内那种鲜甜的韵味。
### 玻利瓦尔广场
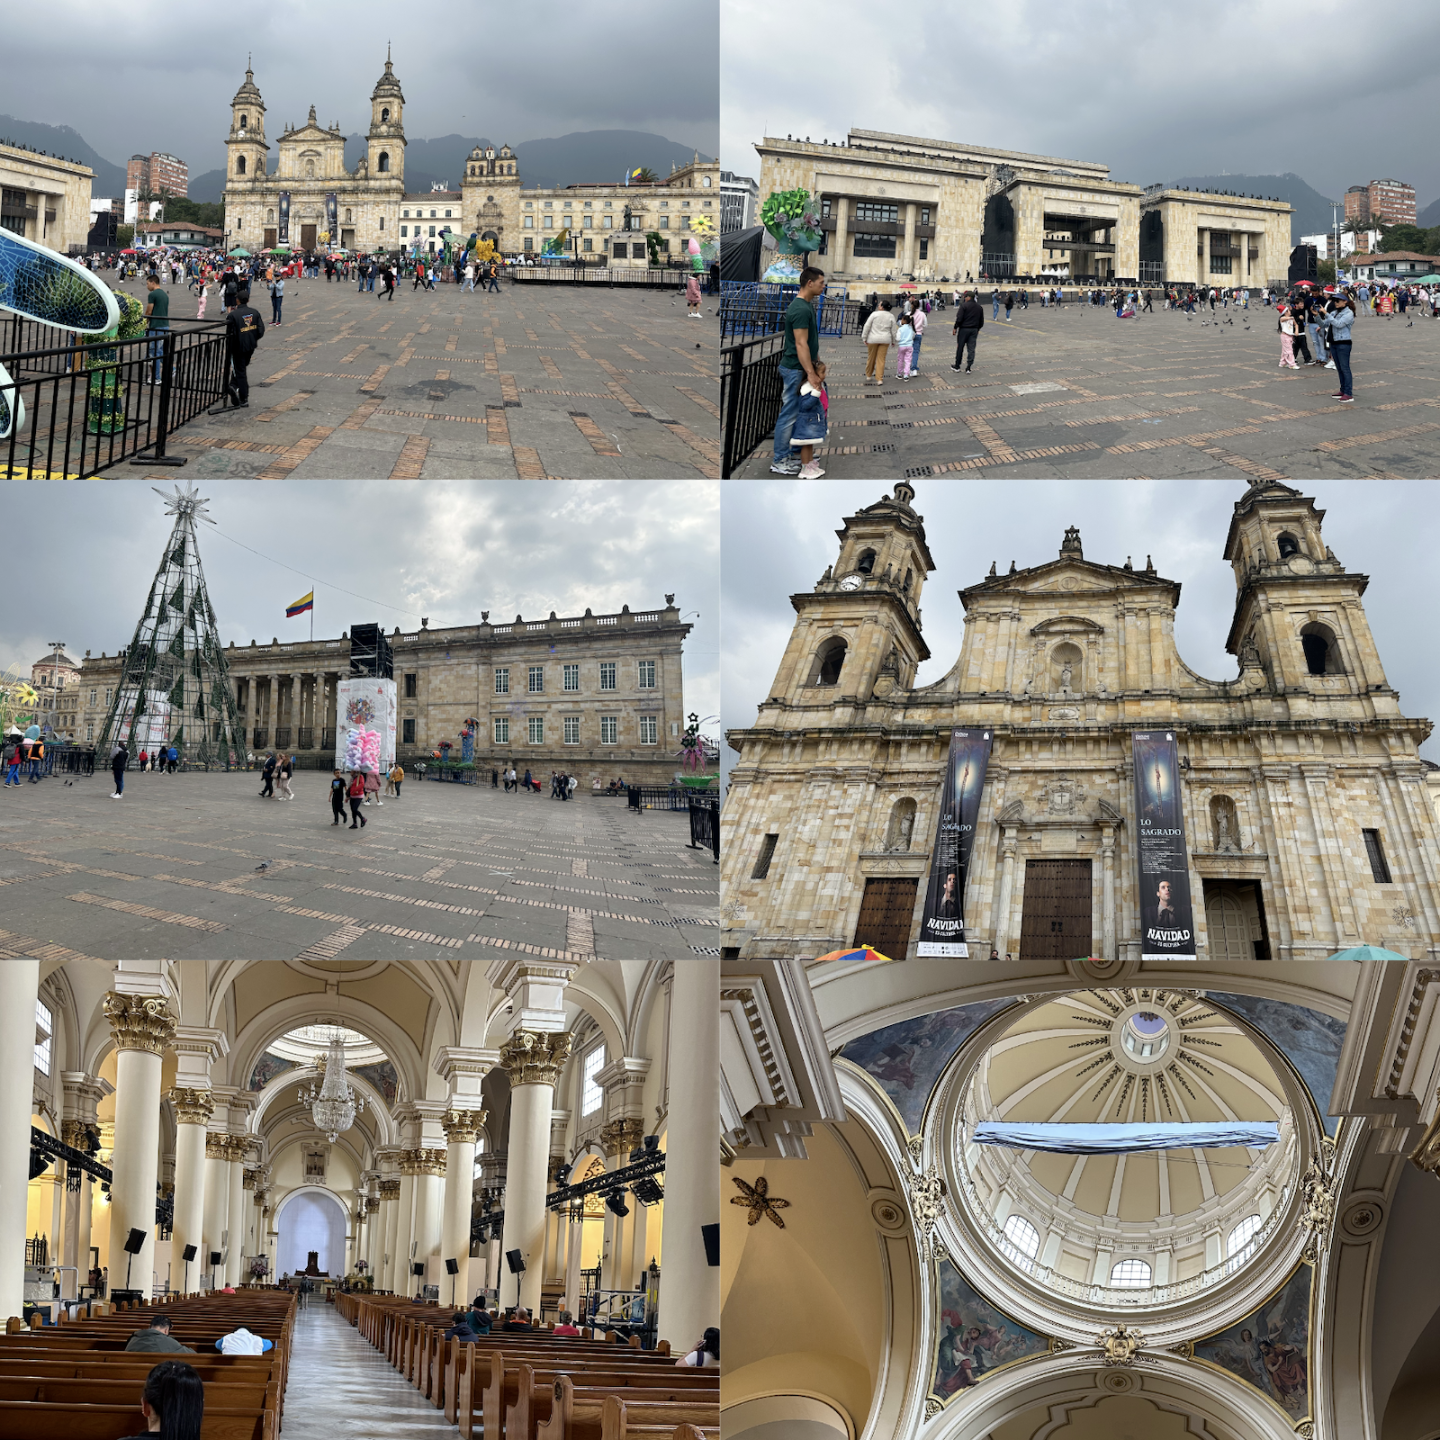
波哥大的旅游景点基本都集中在老城区,而玻利瓦尔广场(Plaza de Bolívar)无疑是这里最重要的地标之一。广场四周环绕着一系列国家级的重要建筑,包括总统府、国会大厦、最高法院和大主教座堂。这不仅是哥伦比亚的政治中心,也是这个国家历史和文化的象征之一。
我们从玻利瓦尔广场的核心出发,映入眼帘的是大主教座堂(Catedral Primada de Bogotá)。这座哥特式风格的大教堂是玻利瓦尔广场最具标志性的建筑之一,庄严而宏伟。从外观上看,大主教座堂的正面立面由对称的双塔和高耸的主门组成,散发出浓厚的宗教与历史氛围。
进入教堂内部,迎接我们的是典雅的拱顶和细致的壁画装饰。大教堂的内部设计让人感受到一种宁静与肃穆。长椅的木质质感与耀眼的吊灯形成了强烈的对比,而穹顶上描绘的宗教场景则为整个空间增添了艺术的神圣感。
广场上的气氛也十分热闹,就是羊驼🦙有点多,味道比较大(动物园类似的味道)。临近圣诞,有很多彩灯装饰,颇有一种国内元宵节花灯的感觉。注意保管好自己的手机和贵重物品就好。
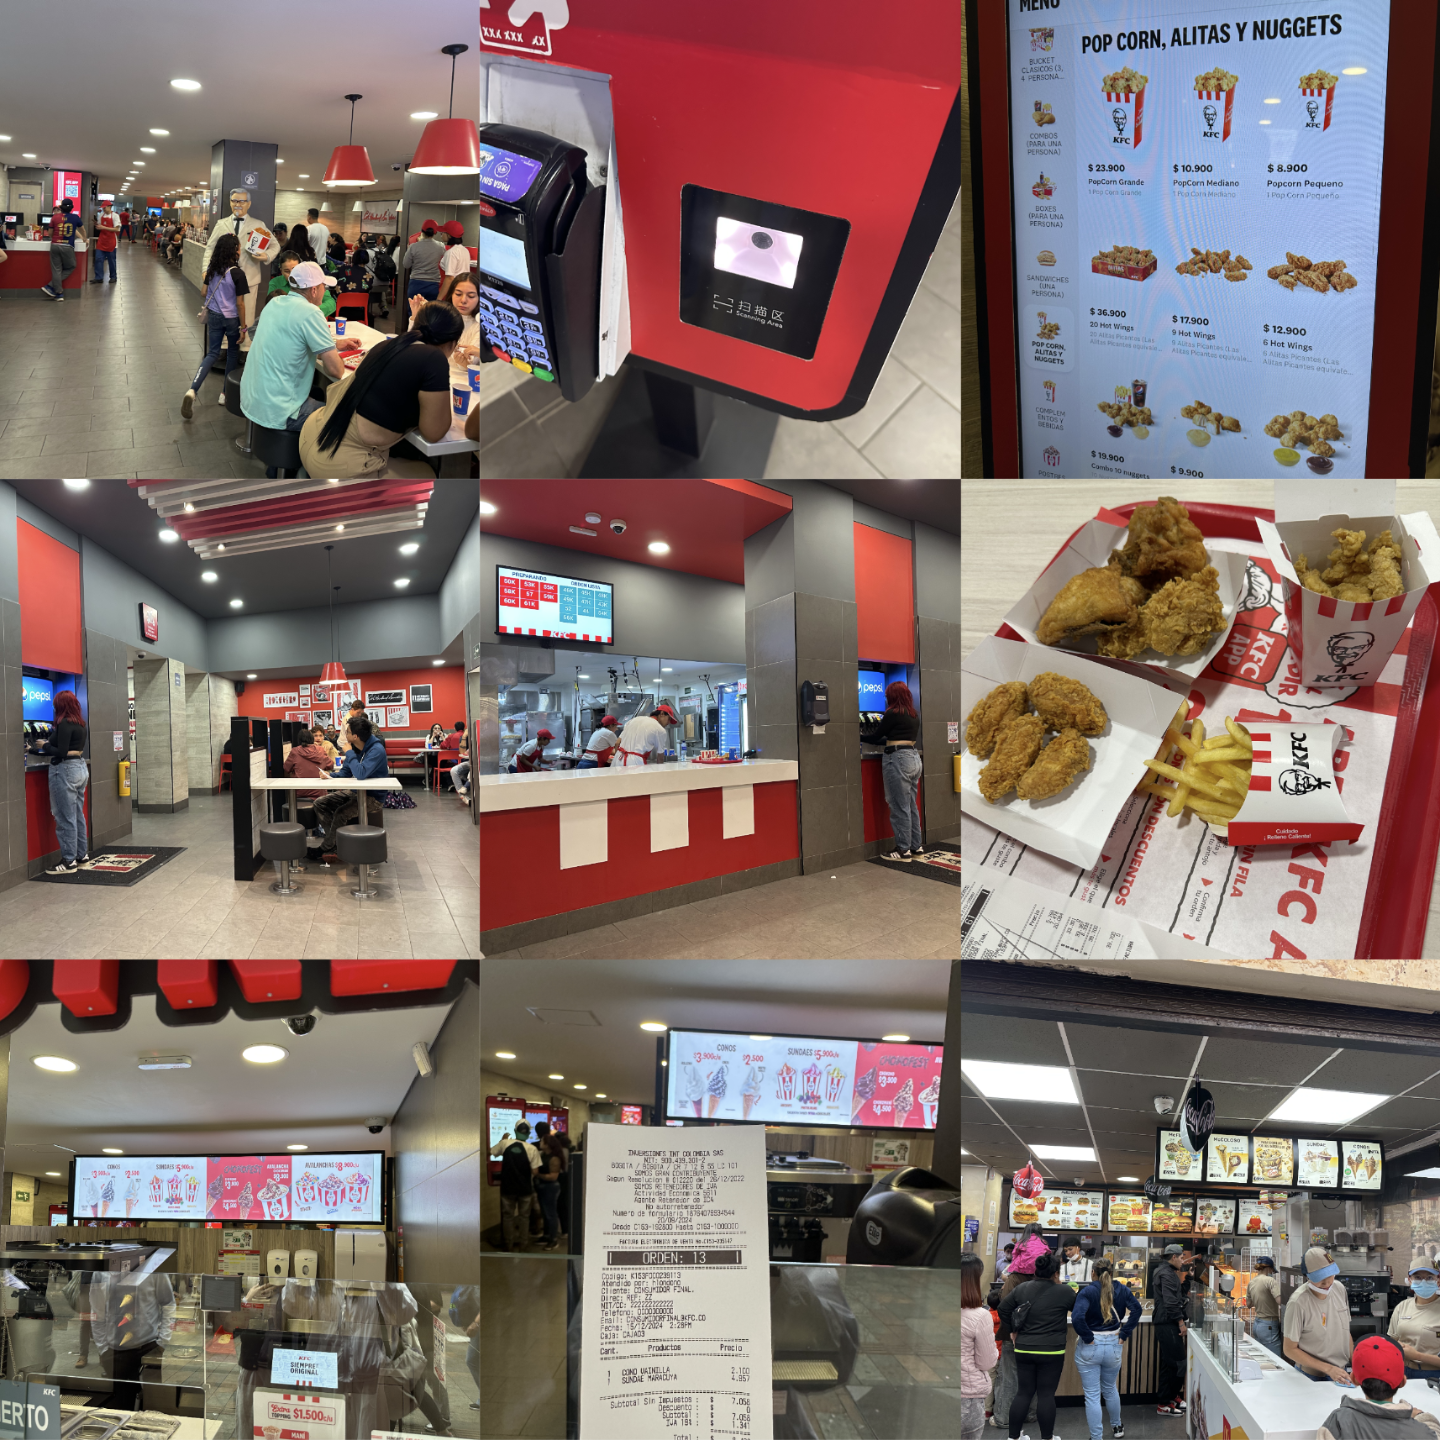
### 肯德基
在参观完大主教座堂后便到了午饭时间,因为黄金博物馆距离这里非常近,我们便步行前往。无意间发现了一家 KFC。周围的小店让我们不是很敢尝试,我们便选择了这家作为今天中午的午餐。作为一个肯德基的“环球尝鲜者”,这次在哥伦比亚的肯德基体验让我对比起了多个国家的口味与特色。先来下个结论吧:美国的肯德基依旧稳居“最难吃”榜单,当然大陆的肯德基体验一如既往地占据“TOP 1”。
哥伦比亚的肯德基和泰国、马来西亚、香港等地的类似,种类不如大陆那么多,但基本的产品都存在。鸡肉鲜嫩,调料比美国版本清淡一些,更加贴近大陆的原味鸡风味。尤其是鸡米花,面衣很酥脆,和大陆的口感类似。薯条则有点迷你到可爱,辣翅也非常小。
价格方面,虽然比美国稍便宜,但以哥伦比亚的整体消费水平来说,肯德基可以说是有点“轻奢”。仅比美国的价格稍微便宜一点。
最让我震撼的,居然是自助点餐机上的中文“扫码区”提示!看到这三个字的时候真没绷住,而且那个扫码区域的功能根本没有任何实际用处,完全就是摆设。
### 黄金博物馆
从玻利瓦尔广场步行到黄金博物馆仅需十几分钟的时间,每逢周日这里免门票,我们在饭后便步行前往。
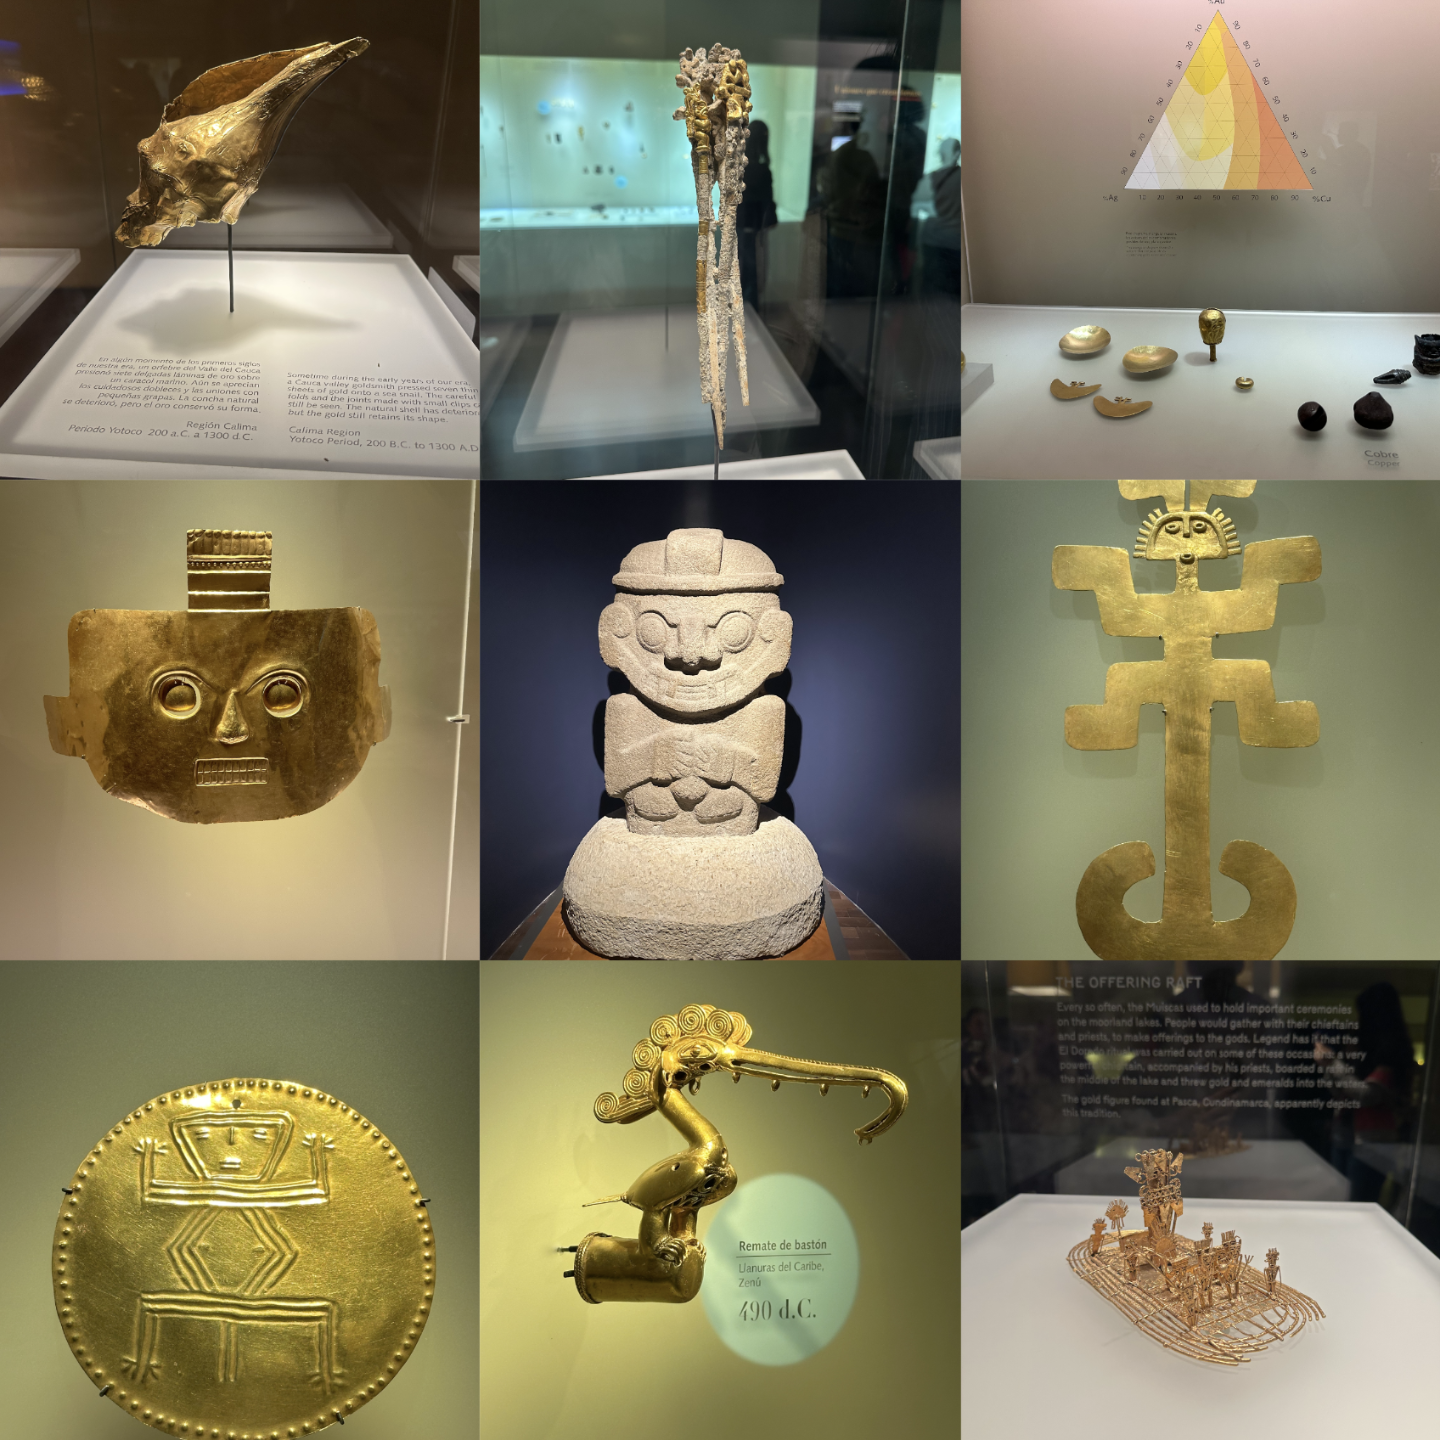
黄金博物馆是拉丁美洲最大、最著名的黄金艺术品收藏馆之一,展示了哥伦比亚及周边地区古代文明的辉煌成就。这里的藏品不仅展现了黄金工艺的高超水平,还反映了当时社会的宗教、信仰和日常生活。简单来介绍一下其中两件比较有代表性的藏品:
1. **黄金木筏(The Offering Raft)- 右下角这个**
这一藏品是黄金博物馆的明星展品之一,发现于哥伦比亚的Pasca地区,被认为与“埃尔多拉多”(El Dorado)的传说有关。据说木筏上的人物象征着穆伊斯卡(Muisca)部落的酋长与祭司,他们在湖泊中央进行献祭仪式,抛洒黄金与宝石以取悦神灵。这件作品精致细腻,细节之处展现了古代黄金工艺的高超水平。
2. **蛇形权杖末端(Remate de Bastón)- 下方中间**
出自Zenú文化,约公元490年。这件蛇形的权杖末端以流畅的线条和细腻的雕刻闻名,体现了古代宗教仪式中黄金饰品的象征意义。蛇在许多拉丁美洲文化中象征着智慧与力量。
昨天在麦德林时,我们就被好几波当地人要求合照,没想到到了首都波哥大竟然还有这种情况出现。在黄金博物馆参观时,有两波人主动向我们提出合照请求,或许是因为我们罕见的亚洲面孔让他们觉得非常有趣。
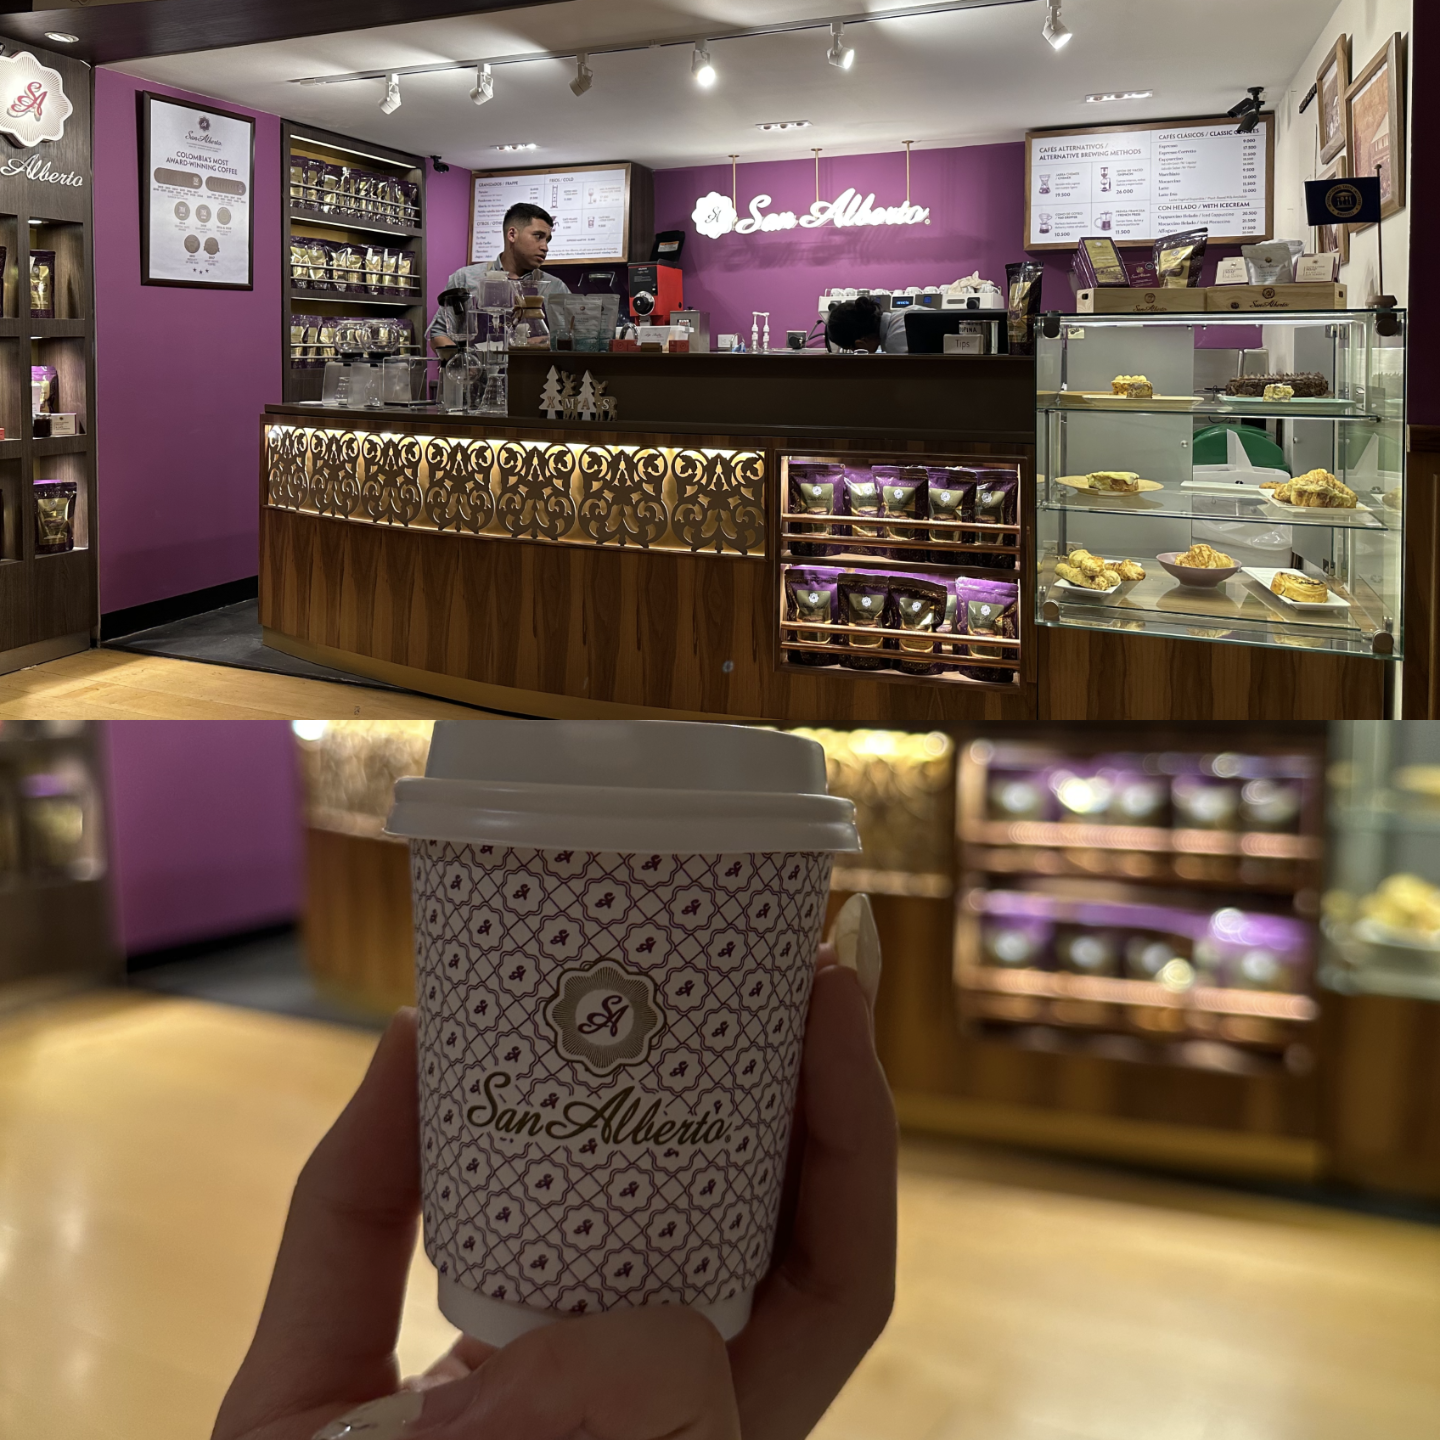
在黄金博物馆楼下有一架 San Alberto 的咖啡店,在喝之前并不知道这家咖啡名头这么大,是拿过最多奖的咖啡。照旧一杯 V60,入口确实被惊艳到了,非常柔和的红色水果味,酸值不强但甜感明显,烘焙度大概是中浅烘,这也是我这次哥伦比亚之行中体验过最适合大多数人的咖啡。
### 小插曲与晚餐
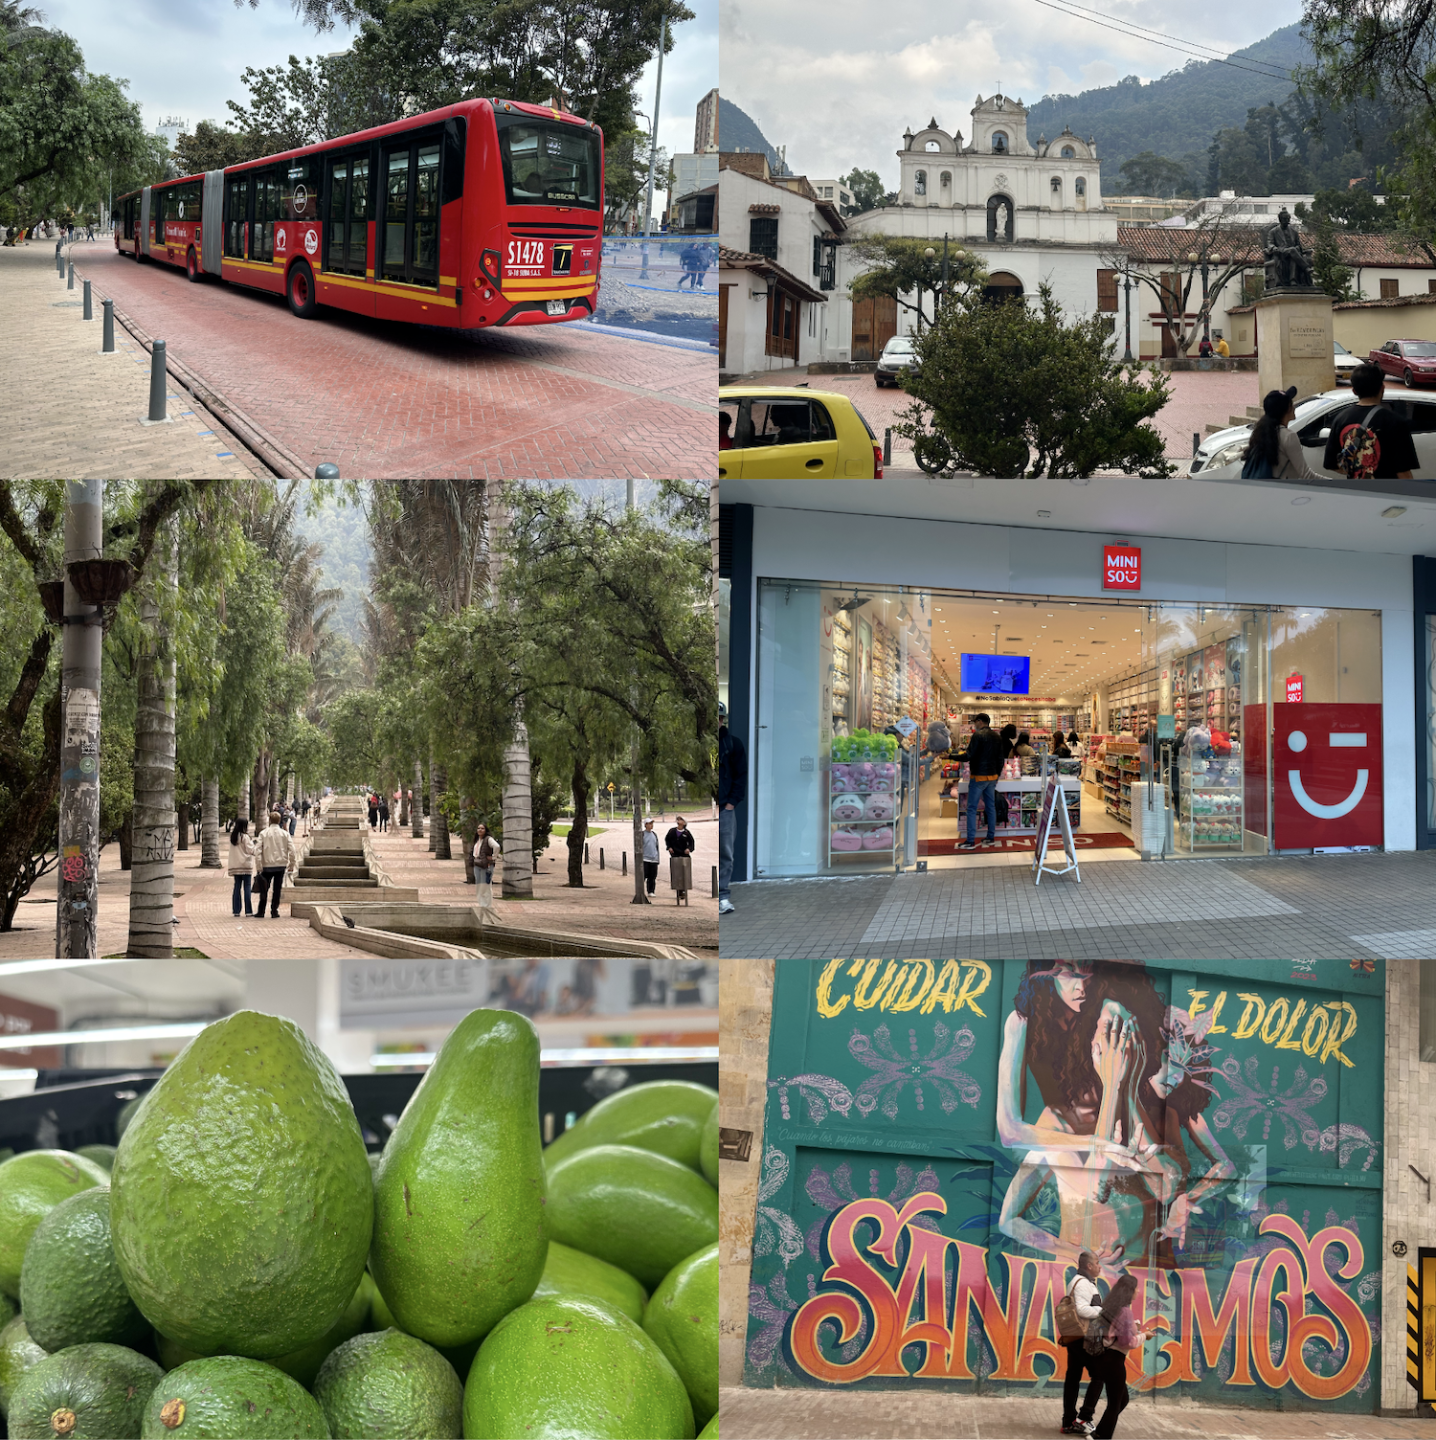
正如我之前提到的,这里的酒店并不提供一次性拖鞋,而我们在出发前非常巧合地忘记了这件事。于是,这几天我们便开始了“拖鞋大冒险”,几乎每次出门都顺带寻找卖拖鞋的地方。在黄金博物馆闭馆后,我们发现附近有一家 Miniso,也还不是很饿,于是决定在晚饭前步行前往,顺便解决这个拖鞋难题。
在路上,我们看到了足足由三节车厢组成的公交车;在商店里,我们见到了巨大的牛油果,比我平时在美国见到的还要大上好几倍,表面却异常光滑。
晚饭我们选择的是 [La PUERTA de la CATEDRAL](https://g.co/kgs/LekQqBJ),一家哥伦比亚菜。是从小某书上看到有其他人的推荐,而且位置正好就在大主教座堂旁边,体验很好哦。
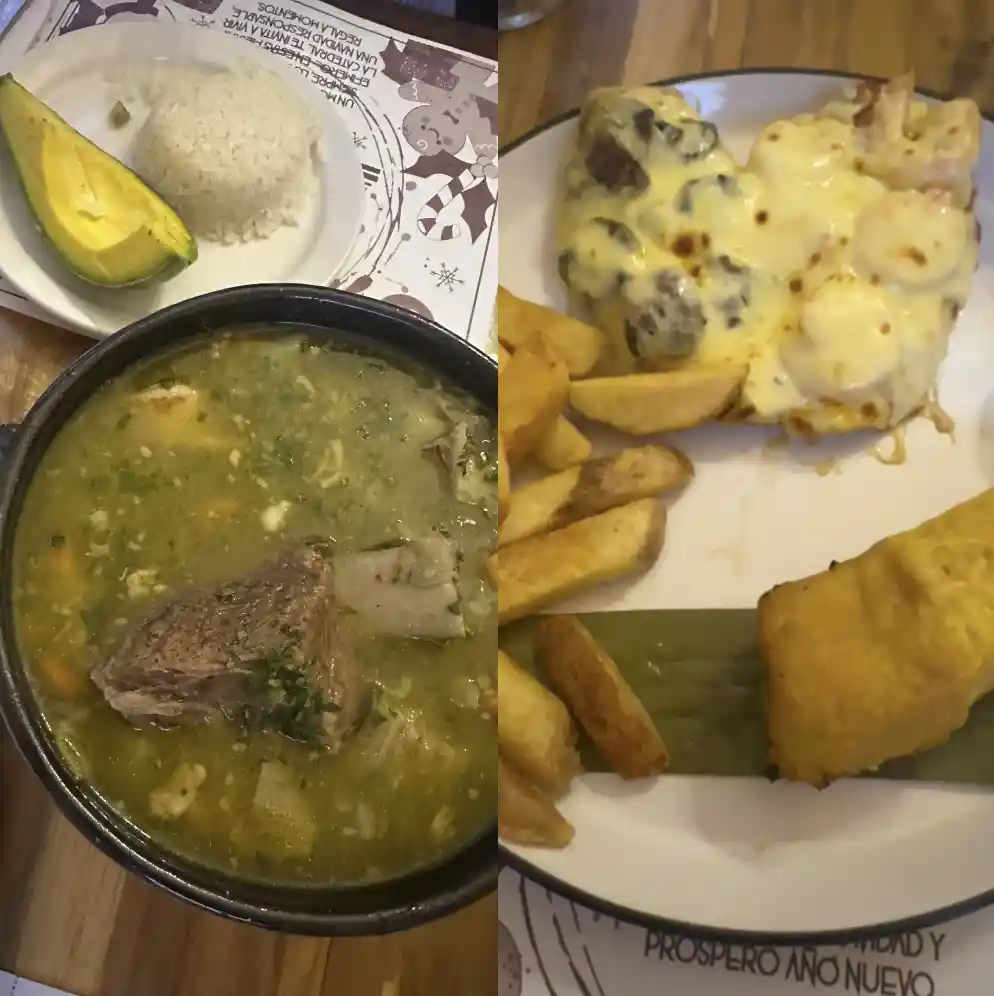
1. 牛肋骨牛杂汤(Ajiaco Santafereño)
这道经典的哥伦比亚菜用土豆、牛肉和各种香料炖煮而成,汤底浓郁香滑。搭配的是米饭和超大块的牛油果(真的是超大,和手一样大)。温热的汤喝起来非常舒适,各种下水非常丰富,没有不好的脏器味。
2. 芝士焗鸡胸配虾(Pechuga de Pollo Gratinada con Camarón y Champiñón)
鸡胸肉非常嫩滑,配上融化的芝士、鲜虾和蘑菇,浓香四溢。鸡胸肉感觉像是低温慢煮的,非常滑嫩不老不柴。搭配的薯条非常香脆,完全不油腻,令人惊艳。而炸香蕉则保留了天然的甜味,与主菜形成了微妙的味觉对比。
菜品的分量很大,两个女生吃撑了也没有彻底吃完,价格也蛮实惠,两份菜加一杯酒人均也只有 10 几美金而已。
## 第四天:Monserrate 与博物馆
### Monserrate
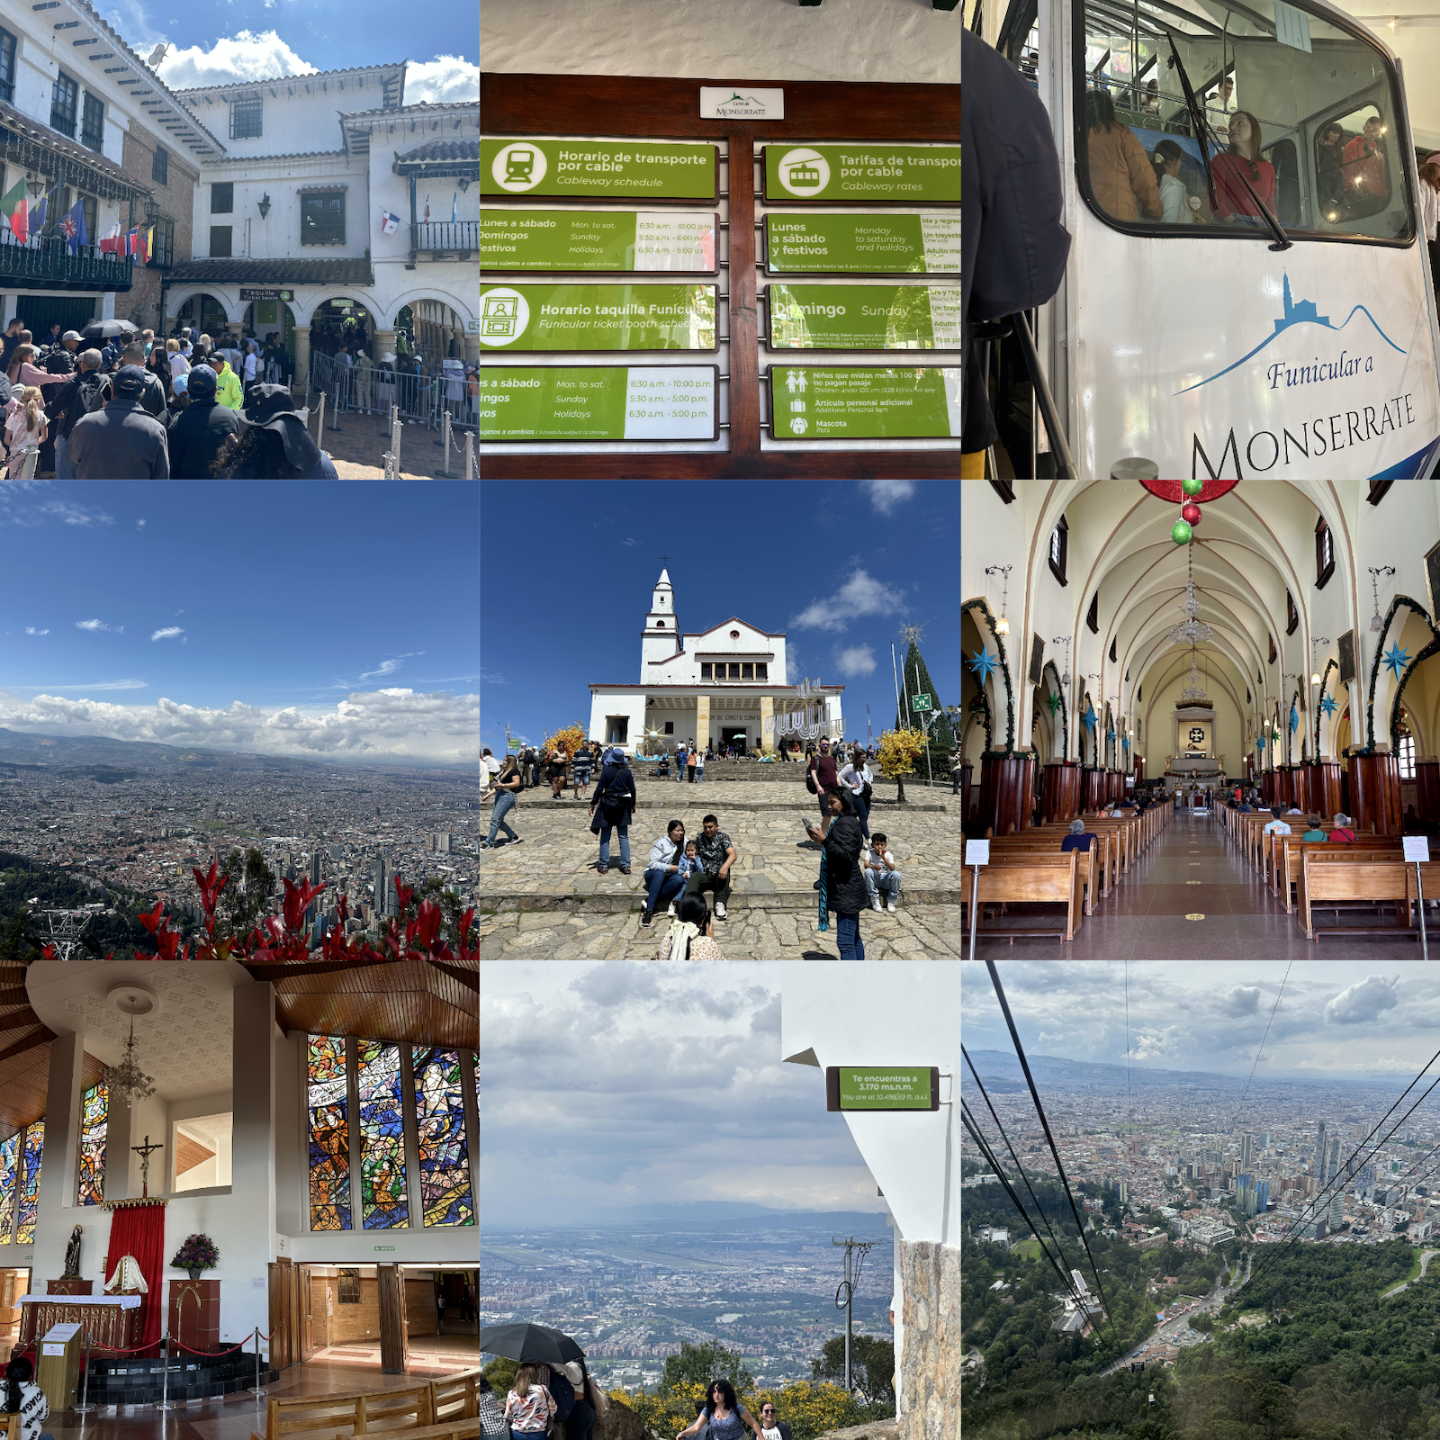
Monserrate 是波哥大的标志性观光点,位于市中心的高山上,海拔 3170 米,俯瞰整个城市风光。由于高海拔,这里容易引发高原反应。周天的门票价格会稍微便宜一些,但因为周天的天气非常差在阴天而且偶尔有小雨,我们便决定搁置一下,今天天气非常好,便决定先一早来山上看看。如果时间充足且体力允许的话是可以步行爬山的,但我有多次高反体验的人,还是选择了缆车和小火车的方式。缆车需要 12 点后才开,我们上山的时候选择的小火车,下山的时候选择缆车。
山顶有一座白色教堂——圣山教堂(Monserrate Sanctuary),是当地人进行宗教活动的圣地之一。碰巧今天是 12 月 16 日,正值圣诞弥撒季节,我们很幸运地赶上了一场弥撒,教堂内彩色的玻璃窗在阳光的照射下显得庄严而神圣,给人一种特别的安宁感。
下山的缆车角度非常大,而且中间没有支撑,有恐高的朋友推荐和我一样闭上眼或者往天上看,千万不要往下看(就我这样恐高不算严重的往下撇了一眼也非常晕而且手脚发软)。
### 午餐
今天的午餐我们没继续参考小某书推荐(其实这边的旅游相关帖子确实不多),于是决定从 Google Maps 上挑了一家评分不错的餐厅,距离我们下午想去的博特罗博物馆(Museo Botero)很近: [Restaurante Banquete tradicional Colombiano](https://g.co/kgs/55jbWGd)。
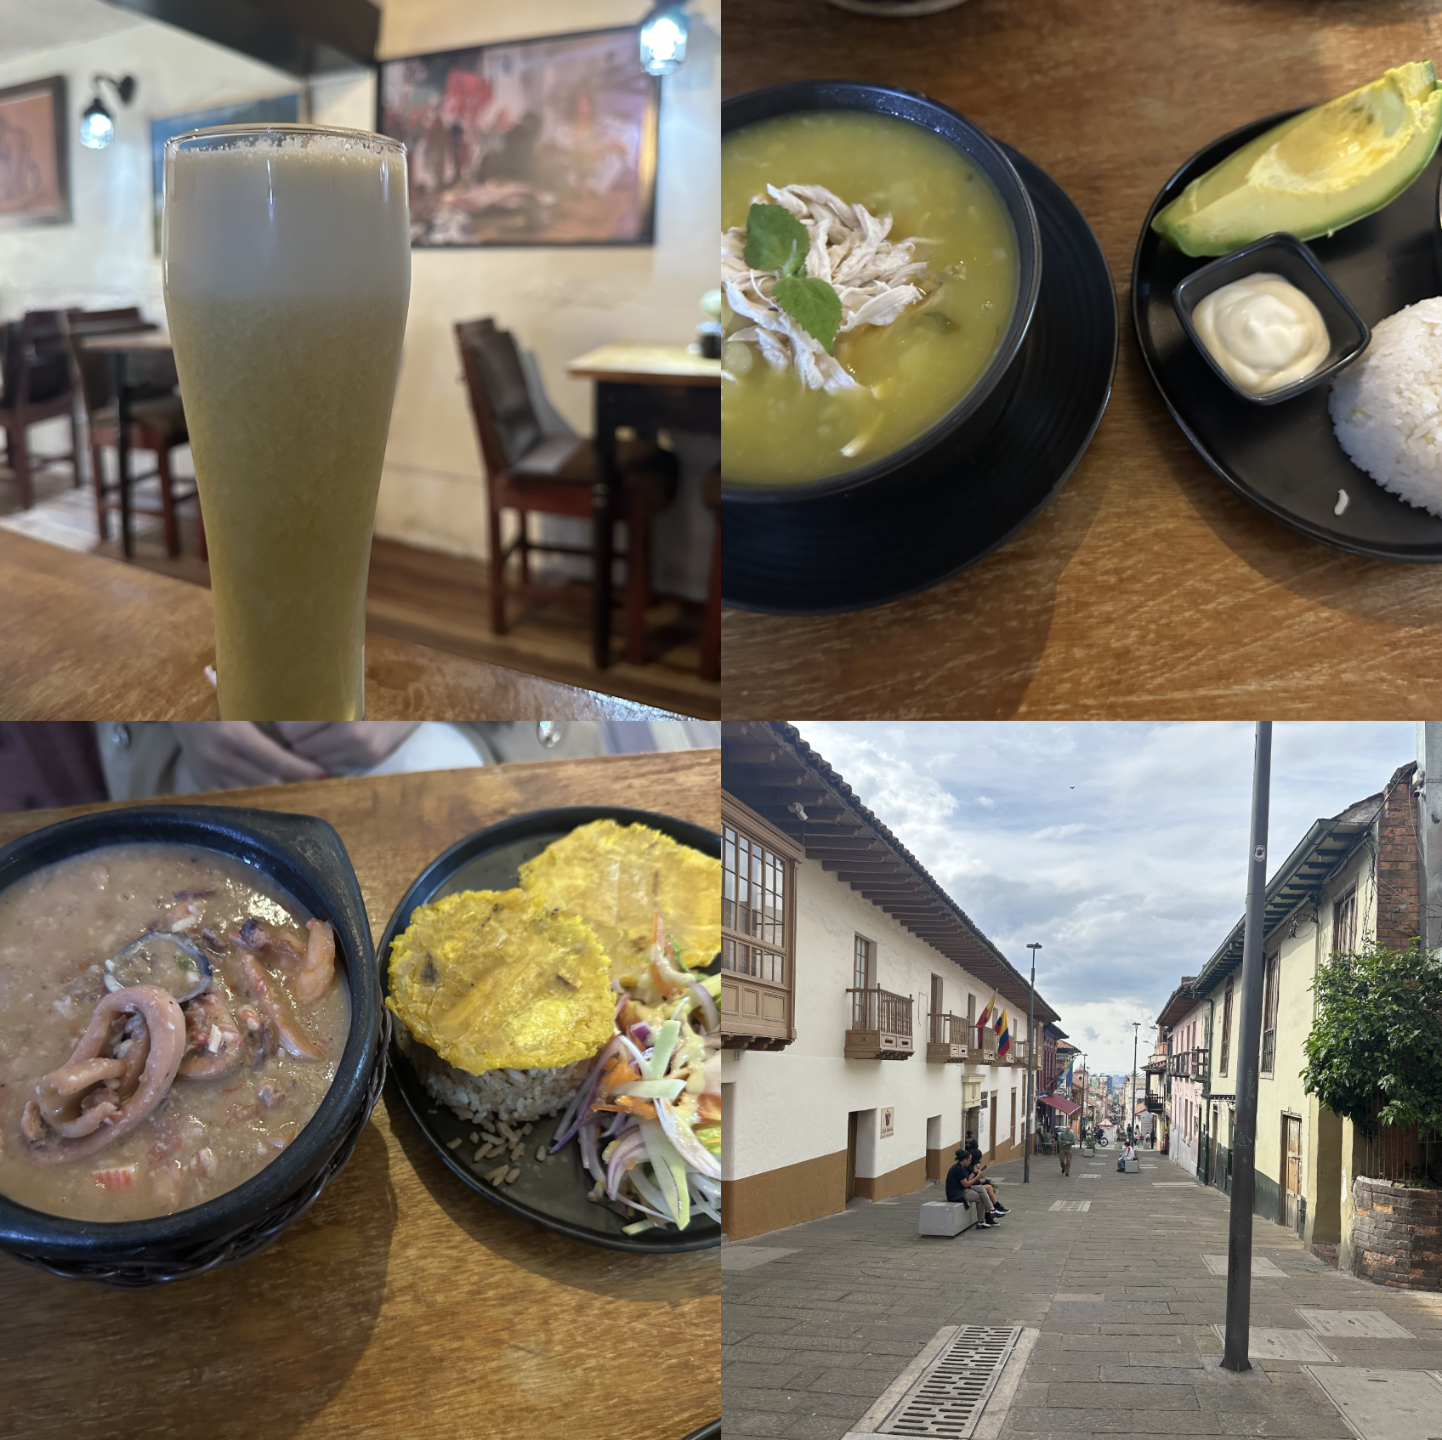
这家餐厅规模不大,但环境干净整洁,非常有当地特色。店员不会讲英语,但特别热情,甚至帮我们连上了店里的 Wi-Fi 方便我们使用翻译软件点餐。经过研究菜单和 ChatGPT 老师的辅助,我们点了两道当地特色菜和两杯传统饮品。
我们选择了 Cazuela de mariscos con leche de coco(椰奶海鲜砂锅),配椰香饭、炸大蕉片和沙拉。椰奶汤底浓郁香甜,海鲜包括鱿鱼、虾和贝类,味道非常鲜美。而搭配的绿蕉片外酥里软,蘸着汤吃特别香。一口就回到了青岛,家的味道。
另一道是经典的 Ajiaco boyacense(博亚卡风味土豆鸡汤),这是一道哥伦比亚传统美食,用三种土豆熬煮,搭配鸡丝、甜玉米和香料,奶油与刺山柑点缀的汤底更加顺滑浓郁,配上米饭和牛油果,满满的幸福感。
至于饮品,我们尝试了两种特色果汁:Aguapanela(甘蔗水),甘甜温暖,非常适合暖胃;以及一杯清爽的混合果汁 Lulo y Maracuyá,由百香果和刺果番茄(Lulo)调制而成,酸酸甜甜,果香浓郁,特别解腻!
### 博特罗博物馆
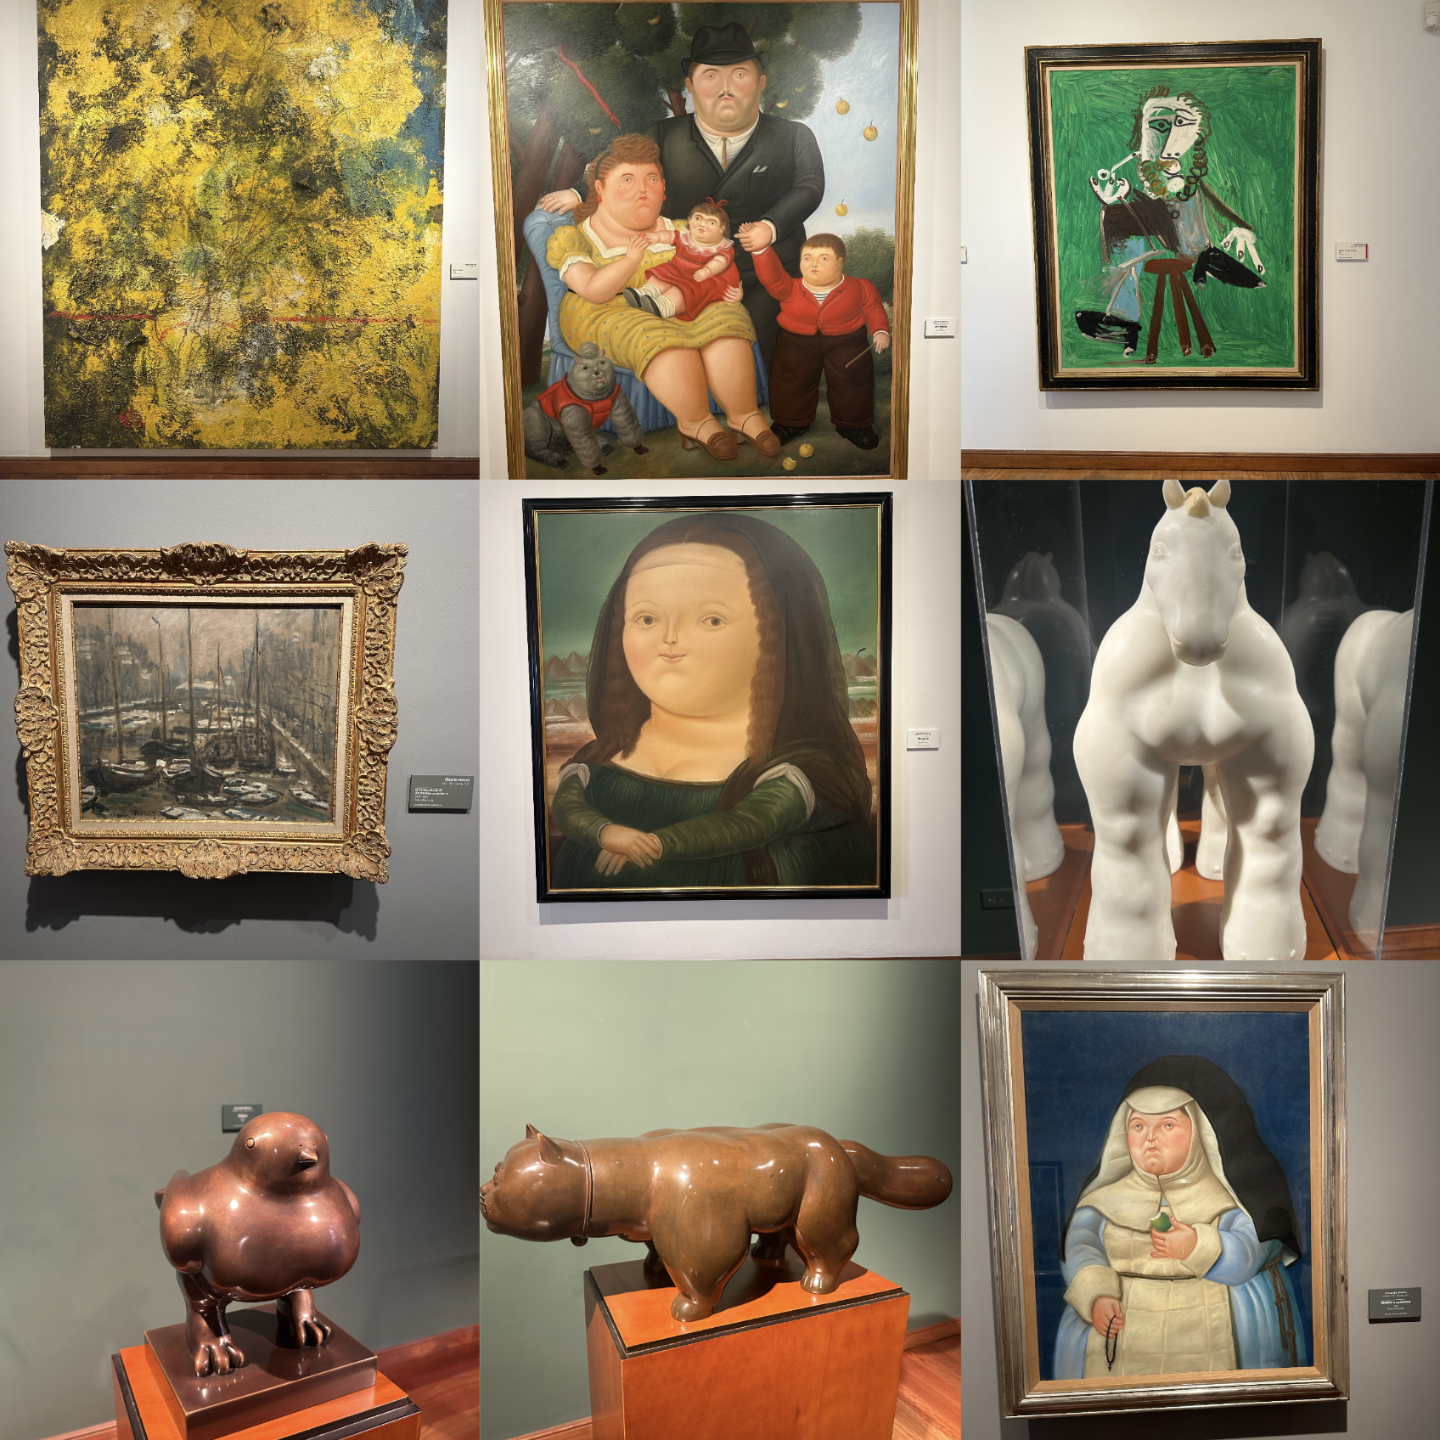
我们前面在麦德林去过一个了,但在首都波哥大同样也有一个,在这个博物馆里不仅有他的作品,同样也有比如毕加索、莫奈等大师的作品(都是博特罗自己的收藏),并且这里是免票的,免费进入参观。
关于博特罗的作品我在前面已经介绍过了,这里就不再赘述。但这里有一副非常重要的蒙娜丽莎,画中的蒙娜丽莎具有圆润饱满的脸颊和身体,细节上依旧保留了达芬奇原作中的温柔与神秘微笑,但博特罗赋予她了更接地气的质感。她的比例经过夸张处理,显得更加温暖、亲近,同时也增添了一种幽默的趣味性。
而左下角这个鸟雕塑,也是我个人在他所有雕塑作品中最喜欢的。这只胖乎乎的鸟体态圆润,双腿短小但神态悠然,仿佛带着几分憨态可掬的自信。它既不是写实主义的刻画,也不是传统审美中的优雅,而是一种通过夸张与变形唤起情感共鸣的表达。
博特罗的这些作品都充满了独特的视觉语言:既保留了对美的追求,又用圆润和夸张的形式挑战传统审美,营造出既亲近又发人深省的艺术效果。它们都以一种轻松幽默的方式,展现出艺术不必拘泥于刻板,而是可以充满生命力与想象力。
这个博物馆并不大,对比麦德林的会小一些。我们在逛完后便走到了后院的咖啡店坐下喝咖啡。喝完后发现后面居然就是艺术博物馆(但已经关门了)。从纪念品商店出来以后我们误入了钱币博物馆,便在这里逗留了一会儿。
波哥大的钱币博物馆虽然面积不大,但展品非常精致且内容丰富。在这里,我们能够了解从古代到现代世界范围内钱币的演变历史。展馆内不仅展示了拉美地区的货币,还有来自欧洲、亚洲和非洲的珍稀钱币,每一枚都承载着一段历史故事。
博物馆内有个房间内有多台古老的铸币机,图中这台是19世纪英国制造的,非常具有历史意义;还有一个金库内展示的精致黄金制品。
如果对这类历史感兴趣的话,这里是一个不错的选择,而且门票也是免费的(毕竟我们迷路走着走着就进来了)。
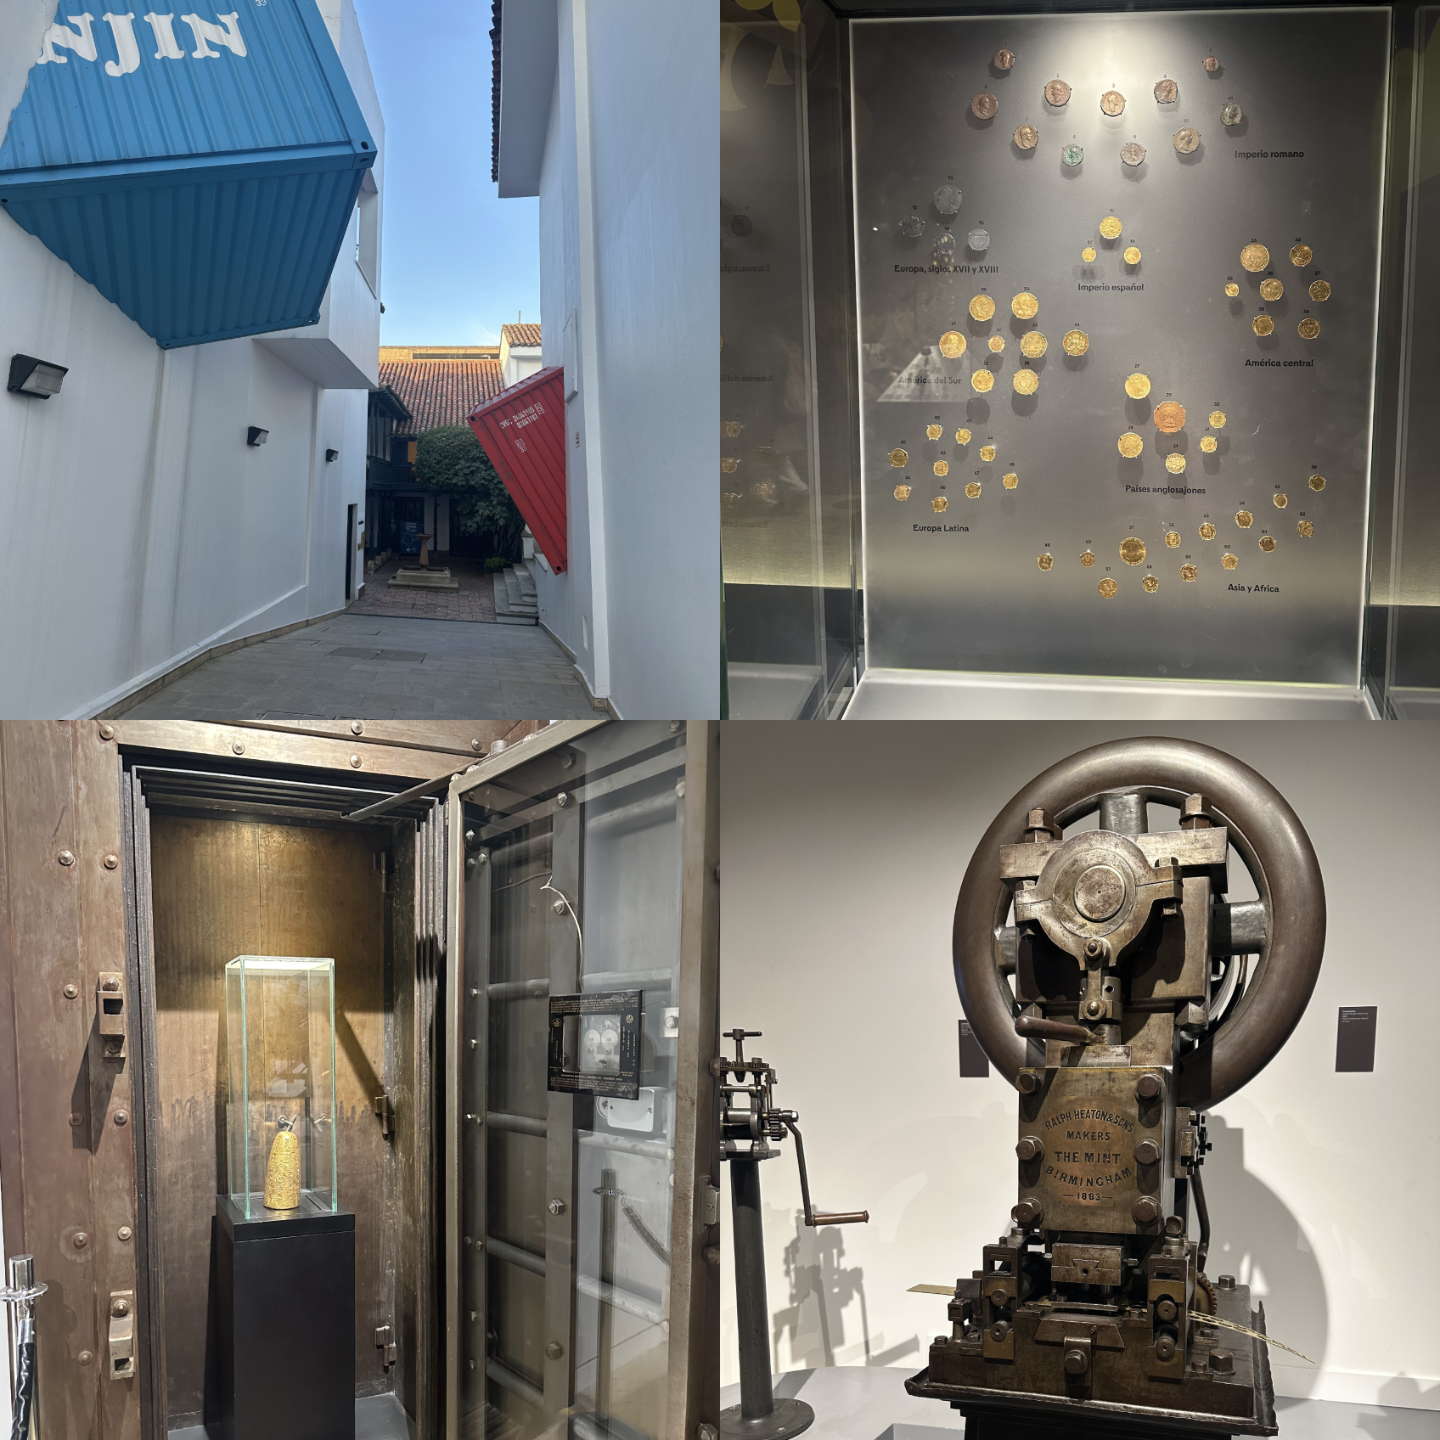
## 第五天:探索更多博物馆
### 早餐
今天我们因为起的实在是太晚,错过了酒店的早餐,便决定去我们上午行程的国家博物馆隔壁的咖啡店吃一点早餐。我们选择的是 [Marte Pizza Café Museo Nacional](https://g.co/kgs/PHfimtL),说实话就是因为这是离博物馆最近的一家店,而且评分在 Google Maps 上也蛮高的。这家店二楼看出去就直接是国家博物馆。
这是一个连锁品牌,但质量并不差。我点了一杯卡布奇诺(6800 COP)和一份 Cazuela De Huevos Mexicanos (14800 COP),朋友点了一份 3 Mini Waffles (19800 COP)。卡布的奶泡还算稍厚的,比较绵密,豆子香气比较醇厚,适合作为早餐的饮品。墨西哥煎蛋是两颗鸡蛋,搭配肉酱和一些墨西哥风味的洋葱调料,配了一个中空的超级香的小饼。华夫饼也是有番石榴和木瓜味道的,果香清新,很解腻。
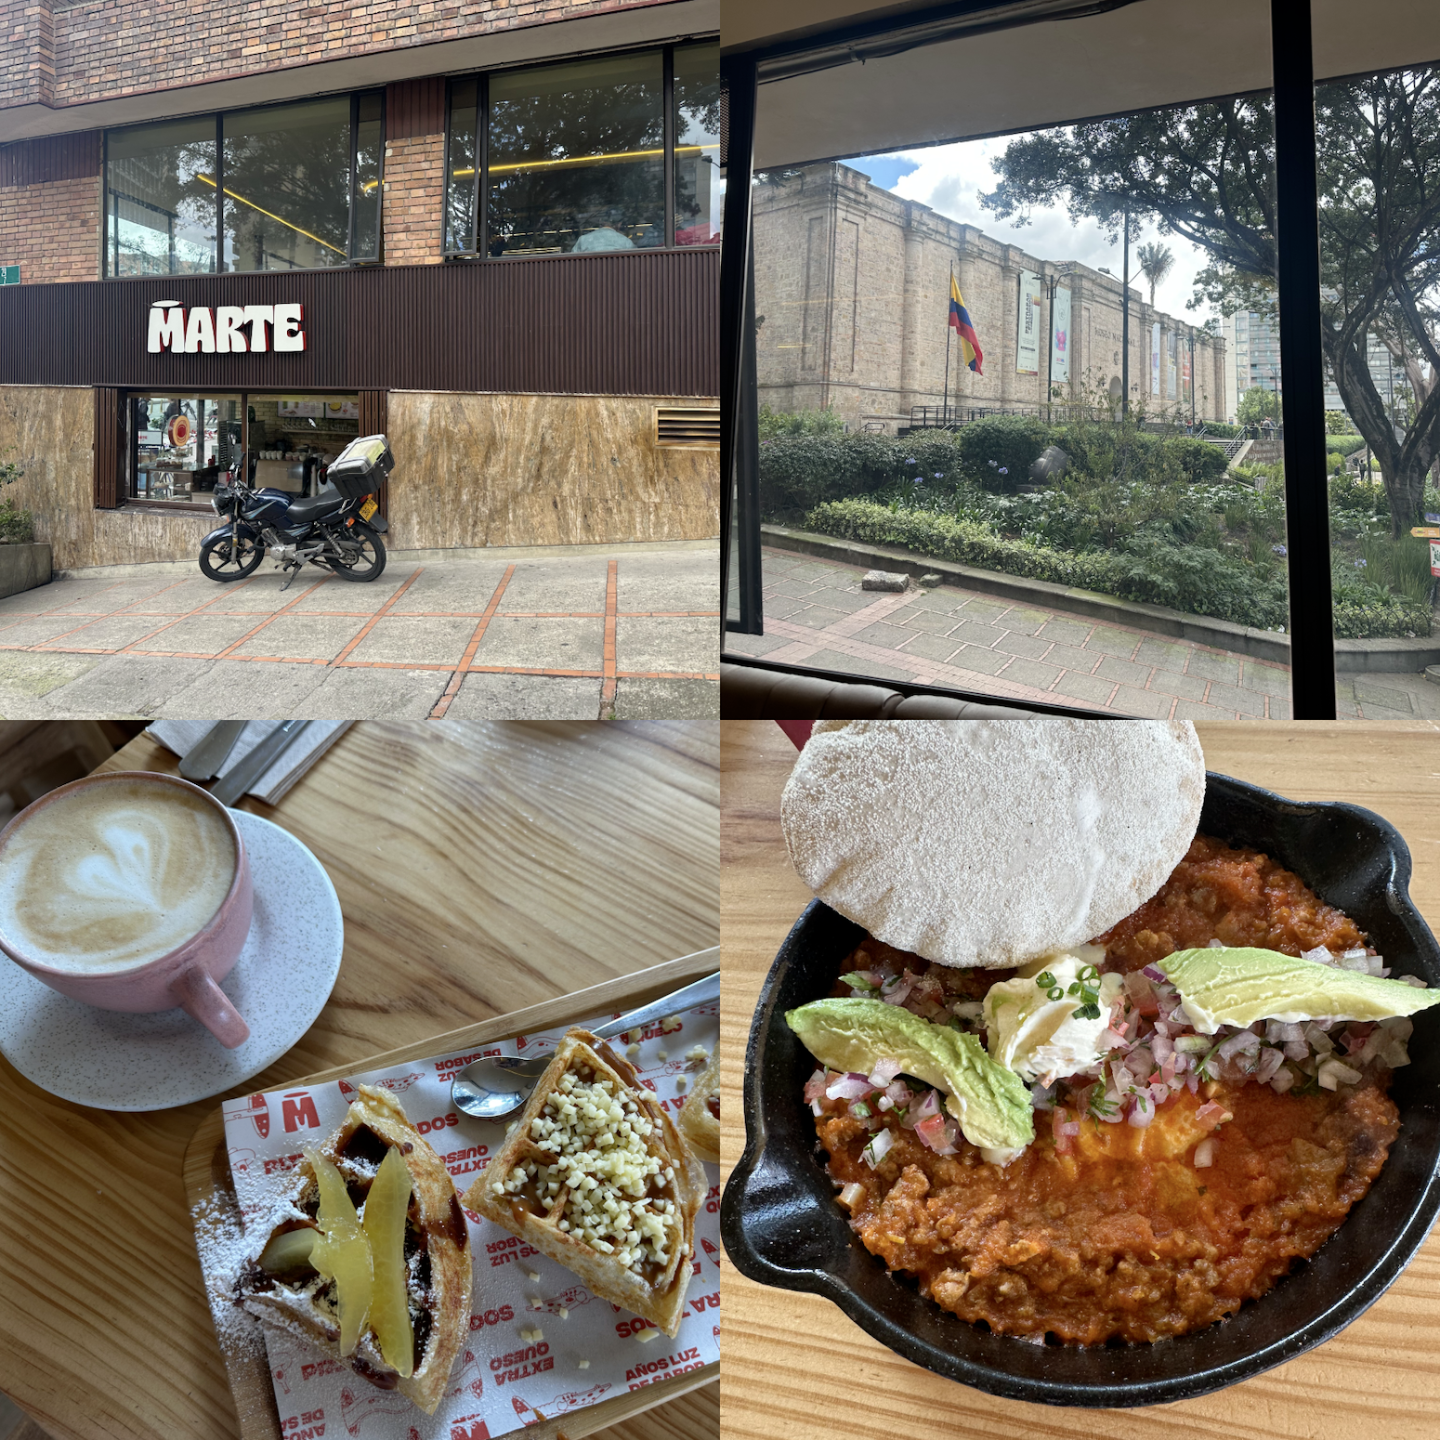
### 国家博物馆
想法是好的,吃完饭直接去逛博物馆,但没想到的是,因为厄尔尼诺现象导致的降水减少,今天波哥大首都圈一部分地方停水,博物馆因此不开门。我们决定前往玻利瓦尔故居,这个国家博物馆只能有缘再会了。
### 参观玻利瓦尔故居
玻利瓦尔故居(La Quinta de Bolívar)位于波哥大的东山脚下,是拉丁美洲解放者西蒙·玻利瓦尔的寓所。我们碰巧赶上了他的忌日(12月17日),看起来联合国及各国大使馆刚刚举行完纪念活动。军方仪仗队、UN和各国大使馆的车在我们到的时候正好在陆续离场。
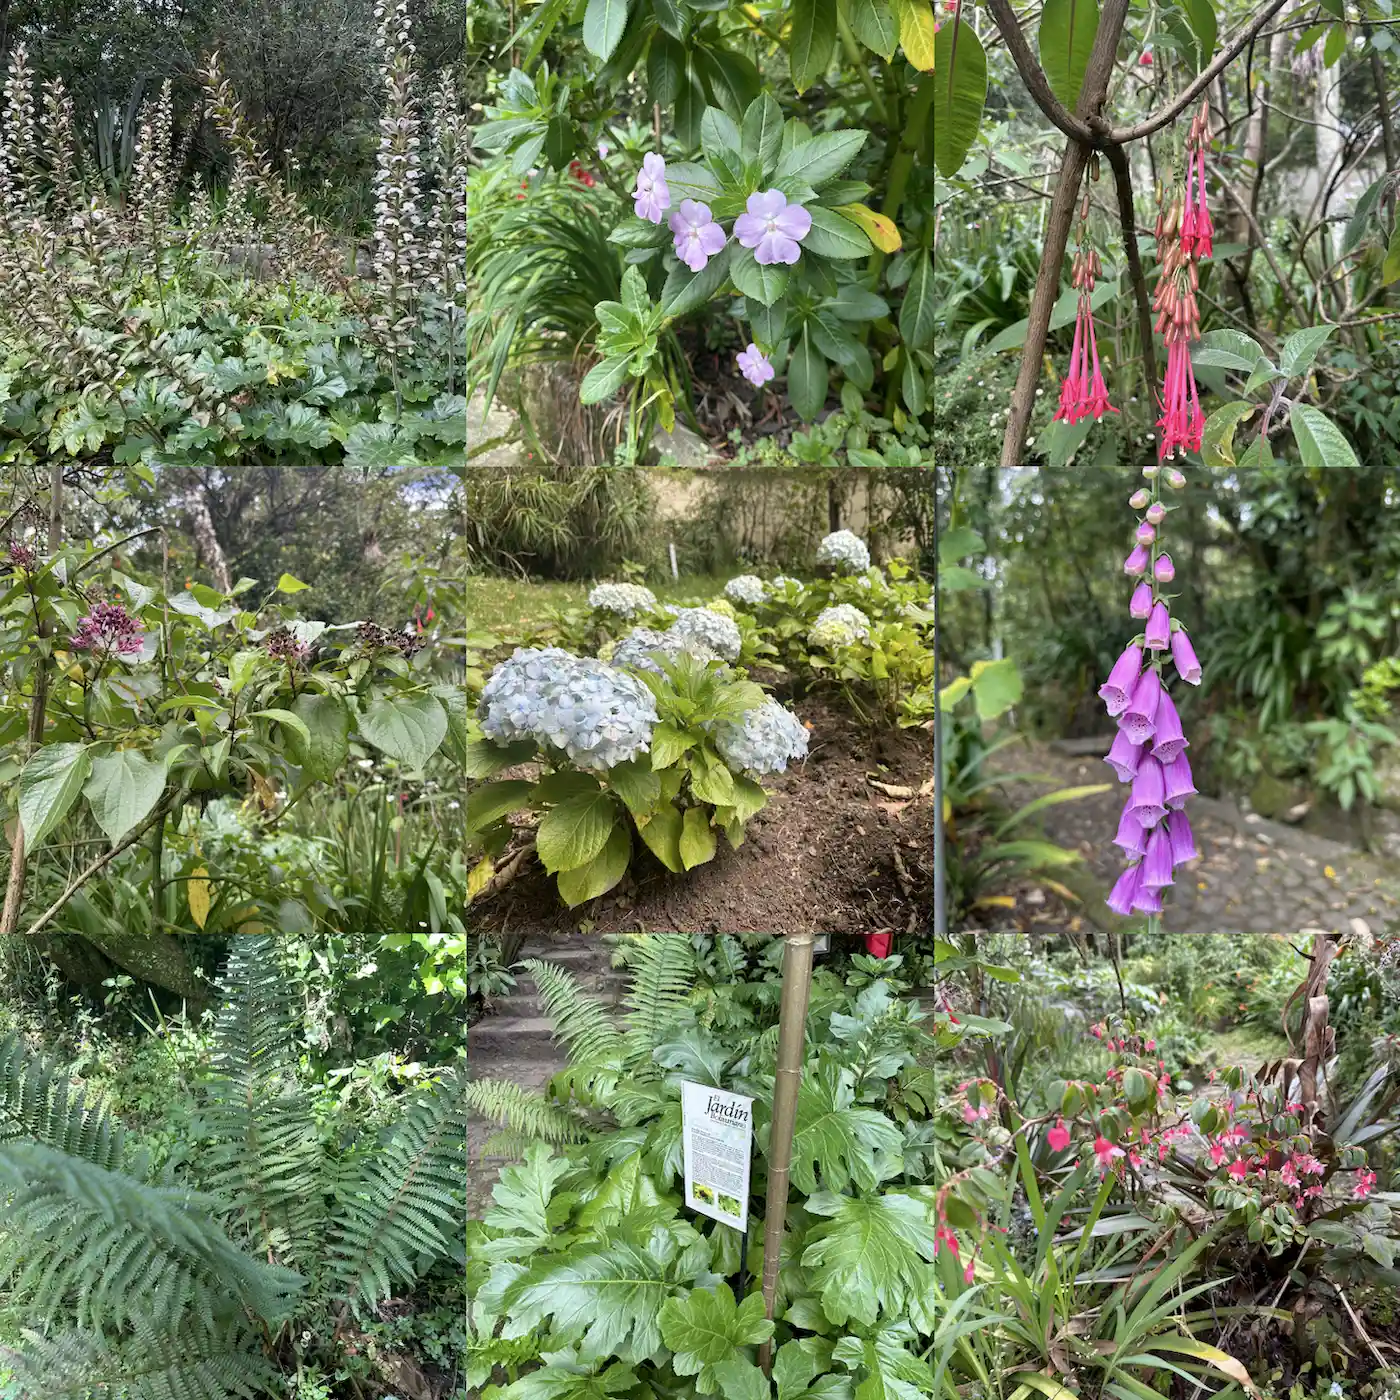
门票外国人相对比较贵,要 46000 COP (11刀) 一人。他家里花种类非常多,很好看。
玻利瓦尔故居内摆放着19世纪风格的床和家具,尽显历史的厚重感。装饰简朴,却充满贵族气息,展示了他生活中不为人知的另一面。
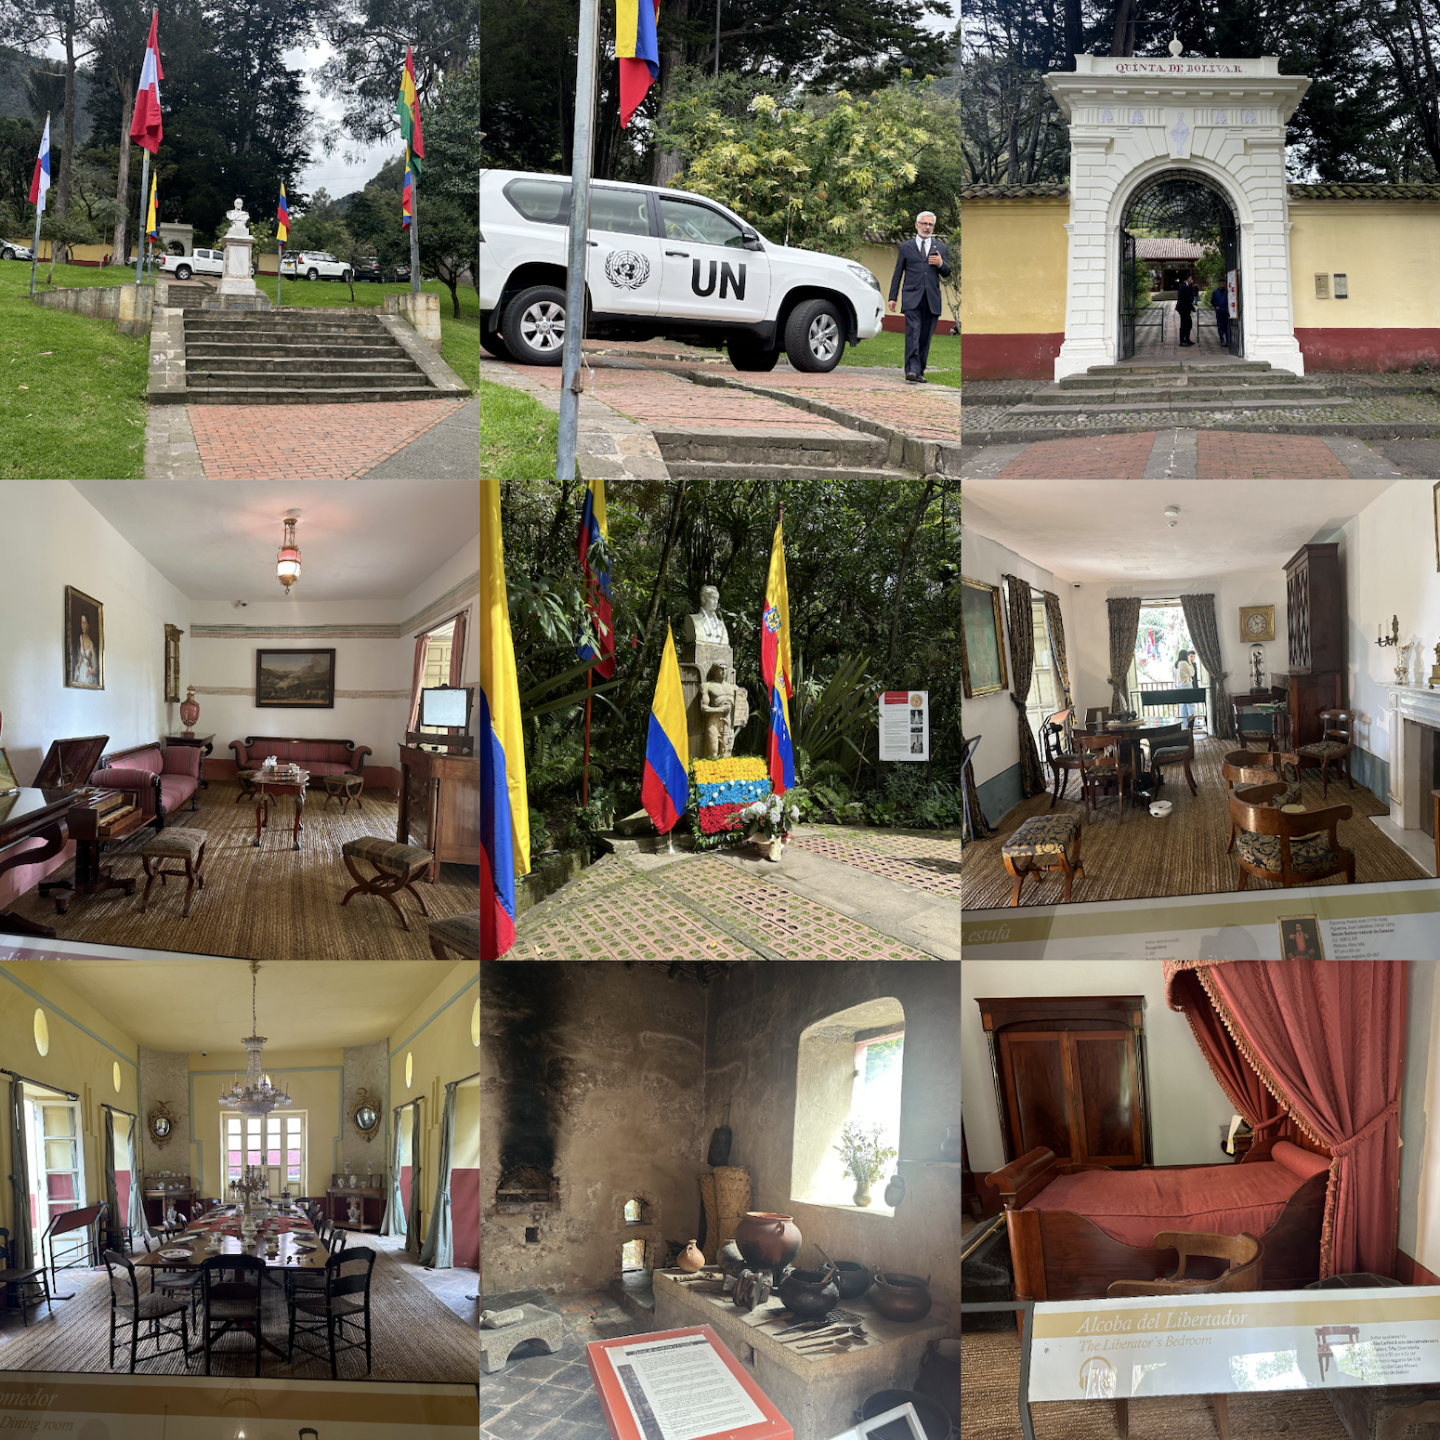
### 现代艺术博物馆
在参观完玻利瓦尔故居后时间并不晚,我们便前往了据此并不算远的现代艺术博物馆(Museo de Arte Moderno)。看到有学生票的价格于是我掏出了我的学生卡,没想到在大陆都不好使的学生卡在这里居然给我打了折,而且今天碰巧有 BOGO(买一送一)的活动,我们两人只花了 12000COP (3刀) 的门票钱。
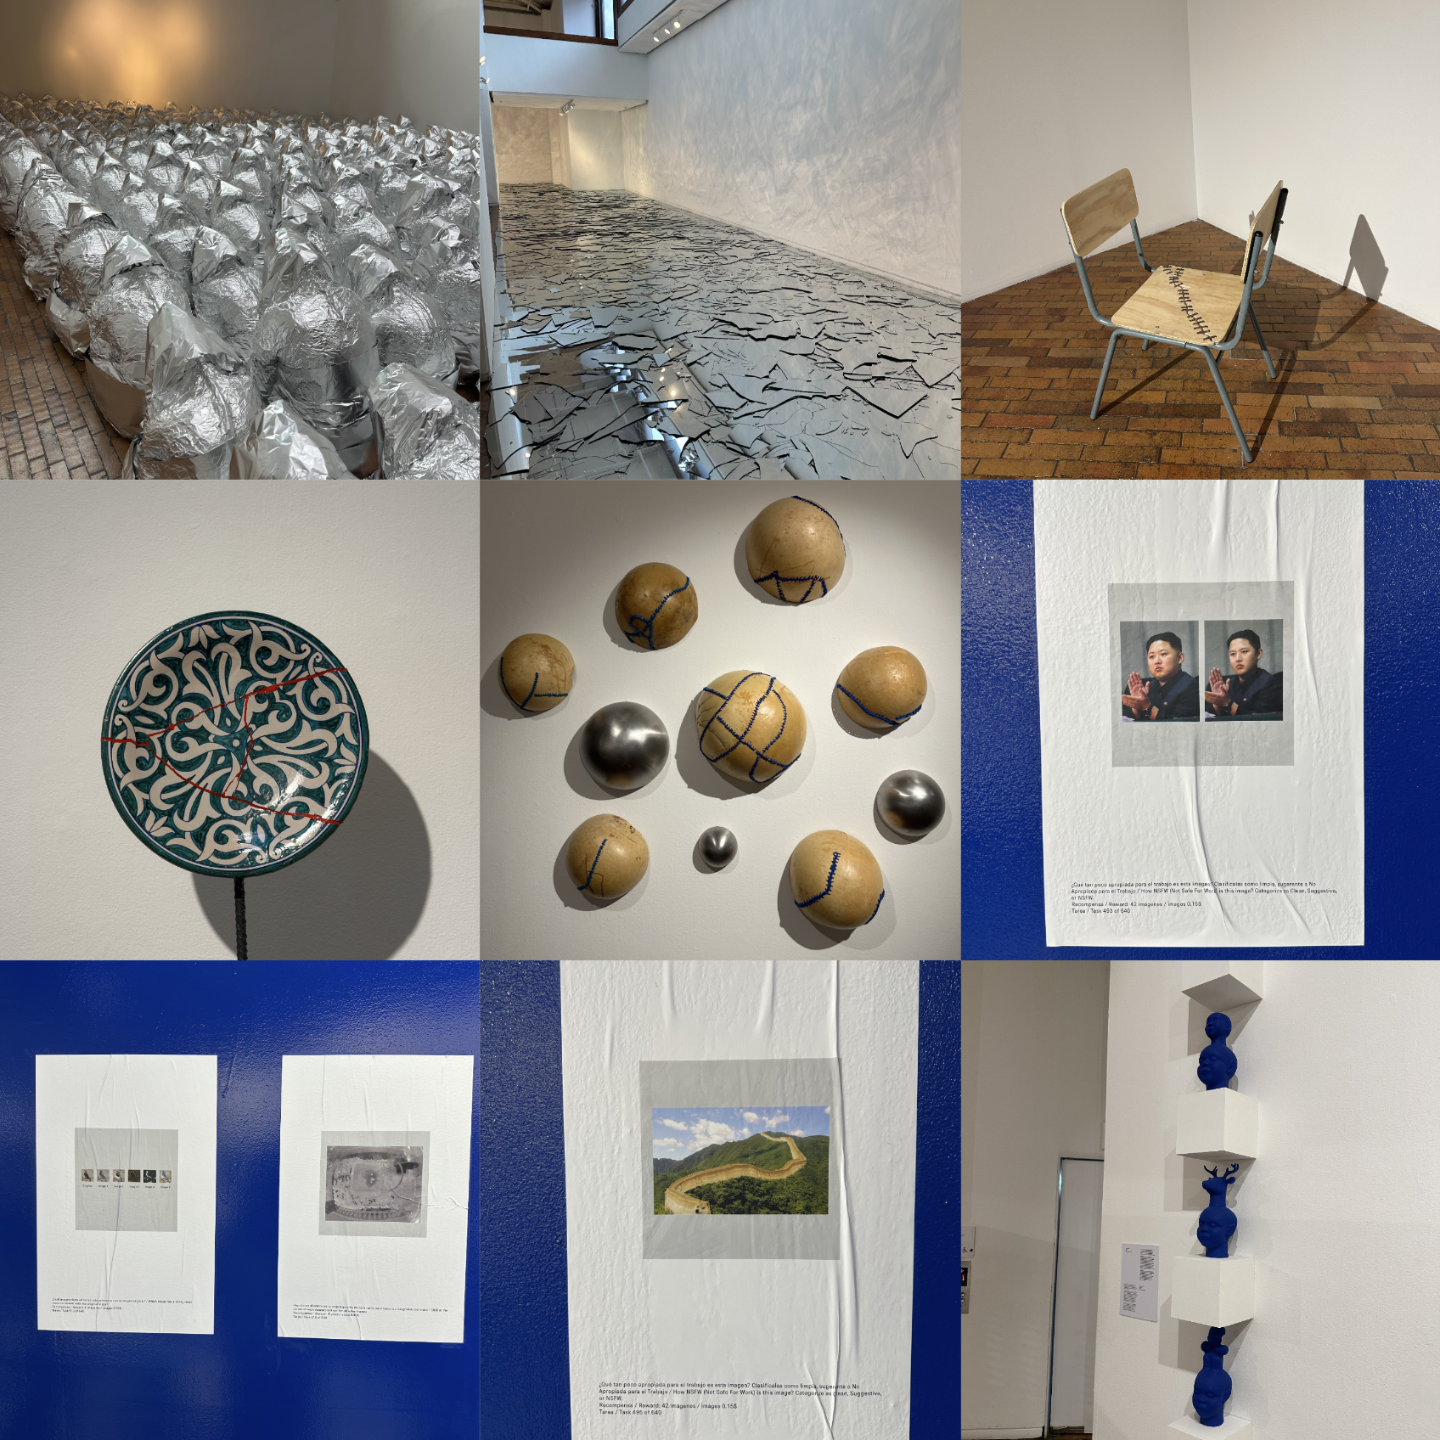
博物馆有地上3层底下1层,二楼是一个法国艺术家的个展,比如图中所展示的破碎的镜子在墙上的反射、被缝合起来的椅子、修复的盘子等。三楼当前在展出的是 Freelancer 对于目前 AI 与社会之间的一些思考,具体来说是 ML 的 data labeling 和 data cleaning 与社会、权利、人类生活之间的影响。地下一层是影视作品制作与审查尺度之间的关系。一楼的图放出来估计这篇文章会被和谐,就放了右下角这一张。
## 离开哥伦比亚
我们定的回程航班是早上 7 点起飞的 BOG-ORD 直飞,推荐至少提前 3 小时到机场预留足够的退税、托运行李、出境海关的时间。
### 退税
退税需要在购买时让商家开具具有你名字及护照号的电子收据发送到你的邮箱,付款时必须刷卡支付。在机场需要前往国际出发海关右侧的 DIAN 窗口办理退税手续,需要提供护照、电子购物小票、信用卡信息、登机牌。会现场要求你出示对应的退税物品,千万要在托运前先去办理退税。登机牌可以提前线上值机准备好电子的,工作人会要求你把登机牌和电子收据一起发送到他们的邮箱。
### 离境机票税
这个我不确定是如何操作,根据小某书上的教程需要在离境办理值机的时候让值机柜台的工作人员直接退现金。但我们的这个工作人员告知我们因为是 Round Trip 系统中没有显示税,没有办法退给我们,我还没研究明白这个事。如果可以成功退税大概是 30 美金(200 人民币)左右的 COP 现金。
### 离境海关排队
非常混乱,哥伦比亚护照、澳大利亚护照、中国护照(也就是我们)都在一起排队,但旁边还有自助机。我们是被工作人员引导排了这队,大概耗时 1 个多小时(当前为凌晨 4 点半左右)。在过了海关后安检也需要排队一会,但这里比较快大概需要 10-20 分钟左右。
尽管我们提前了 3 个小时到达机场,在办理完所有上述手续后,已经是开始登机了。只能匆忙买了一些当地的巧克力和咖啡豆,便匆匆登机了。
## 总结
这次哥伦比亚之行虽然在计划和执行中充满了各种意外和挑战,但也因此收获了许多惊喜与独特体验。从繁忙的城市到静谧的历史遗址,从现代艺术的前沿思考到哥伦比亚本土的热情风味,每一天都充满新鲜感。即使偶尔遇到误机、延误或是语言沟通的困难,但这种不可预期反而成就了更加丰富的旅行记忆。希望之后能继续前往更多国家,探索更多未知的风景与文化。
---
https://zla.pub/columbia-travel-info
---
#哥伦比亚旅游实用信息分享
今年从 Irvine 来到了 Chicago 读研,也第一次感受到零下十几二十几度的冬天,和一天只有不到 10 个小时的白天(就算是白天也看不见太阳啊喂)。就突发奇想决定去南美玩几天,看了一圈好像大多数国家安全系数不高(且中文社群旅游咨询可参考的较少),最后选择了哥伦比亚。说实话,这次旅游计划是从出发前 6 天才开始计划和预定机酒,总体结果还算满意。
本文主要是一些基础信息,游记会单独开一篇文章记录,本文适合想要前往哥伦比亚旅游的大家参考。
## 基础信息
### 语言
我必须要把这个拿到最前面来说,在美国待太久,之前除了美国和大陆也就在香港和日本玩过,香港可以普通话和英语,日本可以英语和我那点蹩脚日语,而且我也完全没有预料到一个国家首都的移民局和机场工作人员居然都基本不会英语。
哥伦比亚的主要语言为西班牙语(基本只有),英语不是很好用,如果是首都波哥大(Bogota)酒店前台应该是会的,但我们在麦德林(Medellin)的酒店前台就完全不会英语了。所以如果你不会西班牙语,建议提前准备好翻译软件(比如谷歌翻译)。我们实际使用体验还是可以沟通交流的,但我们主要是用是英语和西班牙语之间的翻译,不是很确定中文和西班牙语之间的翻译是否准确(考虑到语料库,推荐使用英语和西班牙语之间的翻译以保证准确率)。
### 网络
注意哥伦比亚全境都没有 5G 信号覆盖,在首都波哥大和麦德林的 4G 信号覆盖还是很好的,但在一些偏远地区可能会出现只有 3G 信号,甚至直接无服务的情况,推荐提前下载离线地图和离线翻译。
### 安全
哥伦比亚的安全性大家可能都有所耳闻,毕竟是美洲毒品源头。但目前经过治理后波哥大和麦德林的大多数地方还算安全(强烈不推荐女生一个人,我们这次是两人一起,推荐至少有个伴)。特别注意波哥大的 Zona T 和麦德林的 Plaza Rojas Pinilla 区域,我们在打车经过这两个地区的时候被司机提醒不安全,在麦德林的 Plaza Rojas Pinilla (就在 Plaza Botero 的北边)甚至看到了当街毒品交易,注意不要前往这两个地区,在经过时关好门窗。不要佩戴明显昂贵的饰品(手链、项链、耳钉、戒指等)。
### 紧急电话
报警电话为 123,大使馆电话看你到达后收到的短信就好。
## 支付
### 刷卡
绝大多数地方可以刷 Visa / Master,AMEX 稍差,但也基本没有问题,Discover 这次没有刷,但只要能刷 Discover 的地方都可以刷银联(因为他们之间有合作)。如果店员不懂的话让他们走 Discover 通道直接刷银联就行。Apply Pay 没有问题,绝大多数 POS 机都支持 Tap,也就可以刷 Apply Pay。
### 货币和小费
哥伦比亚的货币为 Columbia Peso(COP),简称 Peso,如果国内能换到可以换一些带着。从美国出发的大家推荐携带一张 Charles Schwab 或者 Fidelity 的借记卡,这两张都可以境外 ATM 直接提现,每天 1000 美元等值的限额足够(这国家你要带这么多现金绝对超过 99% 的人了),ATM fee 也会报销给你不用担心。
## 住宿与饮食
### 住宿
酒店基本没有免费一次性用品提供(包括牙刷牙膏浴帽都是要收费的),香皂、洗发水、沐浴露等是有提供的。一次性拖鞋在我们住的两家酒店你想要付钱都是没有的。
### 电源
美标,110V,这部分不用担心。
### 水
虽然波哥大的水理论上可以直饮,但不推荐,非常硬。瓶装水价格很便宜,市区价格在 2000 - 4000 COP (3 - 5 CNY) 左右,机场价格翻倍也还可以接受。
### 饮食
这边吃饭的口味我觉得比较好接受,主食大多是米饭,配上猪肉、鸡肉、牛肉、海鲜等,羊肉比较少见。价格和大陆吃饭价格差不多,比美国便宜非常多。
## 自然与气候
### 气候
首都波哥大属于高原,海拔大概在 2600m 左右,有高反经历的朋友们需要注意一下,不要跑、第一晚不要洗头,因为没过 3000,基本不需要担心。就是温度因为高原的影响即使是在海拔温度也不会太高,12月我们过去的温度大概在 10-15 度左右,但是阳光很强,所以建议带上太阳镜和防晒霜。
麦德林的机场虽然也是在山顶上(海拔和波哥大市区差不多),但是市区是在盆地中心的,海拔大概在 1500m 左右,温度大概在 25 度左右,中午还是偏热的。
### 蚊虫
有蚊子,如果要进山/雨林,记得打黄热病(Yellow Fever)疫苗,波哥大机场可以免费打。
## 入境
持有大陆护照的大家可以直接用美签/申根签证免签入境(加拿大签证不可以),需要在值机/入境的时候提供返程机票,入境时候提供酒店预订单(为了居住地址)即可。提前 72 小时线上填写 [Check-Mig](https://apps.migracioncolombia.gov.co/pre-registro/en)(但我们实际上没有被询问出示二维码,这个移民局官网的网站设计很糟糕)。
入境排队我们排了一个小时,出境的时候也差不多。
## 出行
### 打车
直接上 Uber 就行,绑信用卡直接线上支付防止出现使用现金看不懂和不好找的问题,而且 Uber 也可以保证安全性。也可以使用海外版的 DiDi,但我个人非常不推荐,我在使用 DiDi 的时候出现了到达后额外加价的情况,这是 Uber 所不存在的,实际价格两者差距也基本不大。大多数情况下打车大概在 10K - 20K COP 之间,也就是 2 - 5 美元(15 - 35 人民币)。等车大概需要 5 - 15 分钟。
### 飞机
我们在境内乘坐了波哥大飞往麦德林的往返航班,境内航班安检非常松,证件的话会在登机时核对,可以使用电子登机牌。
---
https://zla.pub/short-id-generator
---
#基于特定信息的短 ID 生成实现
在一些场景下,我们需要生成具有可读性的短 ID,并且这些 ID 基于用户的特定信息,例如用户 UID 和额外的上下文数据。这种方式的 ID 比 UUID 更加直观,可读性更强,特别适用于以下场景:
- 用户上传的资源(例如 CDN 链接或图床图片)。
- 客户端生成链接或标识符以便用户快速辨认。
- 简化的短 ID 能够提升用户体验和业务逻辑可维护性。
比如我目前在进行开发的 [MomoPix](https://github.com/ZL-Asica/MomoPix) 私家图床项目,就是使用了这里的这种算法,对用户的图片上传链接进行生成(实际上是我在生成链接的时候看到了 [sm.ms](https://sm.ms) 图床的链接都非常短,还能承受这么大的流量,所以我就想着自己也能不能实现一个这样的短网址生成算法)。
## 实现逻辑
### 目标
- **基于用户特定信息**:结合用户 UID 和额外的上下文数据生成短 ID(能够保证 ID 的唯一性,且包含用户信息)。
- **长度可控**:支持自定义生成 ID 的长度(因为可能这次 6 位够用,但下次 6 位能够承受的流量就不够了)。
- **高效**:适用于客户端高并发环境。
我一开始想到的是使用 `SHA-256` 进行哈希,然后再结合当前时间戳进行生成,这样可以保证 ID 的唯一性,同时也能够保证 ID 的可读性。于是,我就想到了使用 `Web Crypto API` 来进行实现。
### Web Crypto API 简介
`Web Crypto API` 是现代浏览器中内置的加密接口,支持高效、安全的加密操作,包括哈希、签名和密钥生成。它的主要特点包括:
1. **性能高效**:直接在底层硬件或操作系统中实现加密算法,速度远高于 JavaScript 实现。
2. **安全性强**:避免了 JavaScript 中可能导致安全问题的实现错误。
3. **跨平台支持**:几乎所有现代浏览器和 Node.js 环境均支持(IE 11 都支持呢!)。

在我实现的的这一个短 ID 生成中,我们使用了 `crypto.subtle.digest` 方法来计算输入数据的 SHA-256 哈希值。
### 为什么选择 SHA-256?
1. **抗碰撞性**:即使输入数据略有不同,生成的哈希值也会完全不同,极大减少冲突可能性。
2. **普遍支持**:SHA-256 是加密领域的标准算法,浏览器和服务器端均原生支持。
3. **效率高**:在短时间内可以处理大量数据,非常适合高并发场景。
## 具体实现
### 定义输入类型校验
通过 `Zod` 定义输入结构,确保输入数据合法。
```typescript
import { z } from 'zod'
// 输入数据的类型约束
const idSchema = z.object({
inputValues: z.array(z.string().min(1, 'Strings cannot be empty')),
randomBias: z.string().optional(),
length: z.number().int().min(1).default(6),
})
export type IdInput = z.infer
```
我们需要获取的是一个计算时所基于的数据,也就是 `inputValues`,这个数据可以是 `UID` 和当前要上传的文件名所组成的一个 `array` 数组,也可以是一些其他的有一定唯一性的数据。`randomBias` 是一个可选的随机偏置字符串,用于增加哈希的随机性,防止同一个用户在同一时间戳上传多个文件时生成相同的 ID(虽然一般不大可能这样,但是还是要考虑到这种情况)。`length` 是生成的 ID 的长度,这个长度可以根据实际情况进行调整。
### 核心逻辑实现
以下是核心算法,用于生成基于用户输入的短 ID,同时提供回退机制以适应不同环境。
```typescript
/**
* @param {string[]} inputValues - 用户提供的输入数组,例如 UID 或上下文数据。
* @param {string} [randomBias] - 可选的随机偏置字符串,默认使用随机数。
* @param {number} [length] - 生成的短 ID 长度。
* @returns {Promise} - 返回生成的短 ID。
*/
export const generateUniqueId = async (
inputValues: string[],
randomBias: string = Math.random().toString(36).substring(2),
length: number = 6,
): Promise => {
idSchema.parse({ inputValues, randomBias, length }) // 校验输入数据
const encoder = new TextEncoder() // 创建文本编码器
const uniqueId = encoder.encode(
inputValues.join('') + Date.now() + randomBias,
) // 合并输入数据,并添加当前时间戳和预定义的随机偏置
// 防止不支持(IE 11 都支持我想不到还有什么不支持的)
if (crypto?.subtle?.digest) {
// 进行 SHA-256 哈希计算,返回 ArrayBuffer
const hashBuffer = await crypto.subtle.digest('SHA-256', uniqueId)
// 将 ArrayBuffer 转换为 Uint8Array
const hashArray = [...new Uint8Array(hashBuffer)]
// 将每个字节转换为 2 位十六进制字符串,并拼接为最终的哈希值
const hash = hashArray.map(b => b.toString(16).padStart(2, '0')).join('')
return hash.slice(0, length)
}
// 基本不可用的一个回退方案,只能支持小并发的情况
const fallbackSimple = Math.random().toString(36) + Date.now().toString(36)
return fallbackSimple.slice(0, length)
}
```
### 使用示例
以下是如何在项目中调用该函数的示例:
```typescript
import { generateUniqueId } from './shortIdGenerator'
const inputs = ['user123', 'photo.png']
// 指定输出长度为 10
const id = await generateUniqueId(inputs, undefined, 10)
```
## 并发冲突分析
在高并发环境中,使用该算法生成短 ID 时,冲突的可能性取决于以下因素:
1. 输入数组 `inputValues` 的唯一性。
2. 随机偏置 `randomBias` 的随机性。
3. 生成的 ID 长度 `length`。
假设输入的 `inputValues` 是一样的,比如同一个用户同一文件名的图片,那么我们就计算一下在这种情况下我们如果选择 6 位长度,能够承受的并发。
以下是目标冲突概率为 $0.1\%$ 时,能够承受的最大并发数 $k$ 的证明过程:
### 问题定义
我们使用生日悖论公式计算冲突概率:
$$
P(\text{冲突}) = 1 - \exp\left(-\frac{k(k-1)}{2N}\right)
$$
其中:
- $N = 62^6 = 56800235584$:6位ID的总组合数。
- $k$:每天生成的ID数量。
- 我们希望 $P(\text{冲突}) \leq 0.001$(目标冲突概率为0.1\%)。
### 化简公式
设 $P(\text{冲突}) = 0.001$,则:
$$
0.001 = 1 - \exp\left(-\frac{k(k-1)}{2N}\right)
$$
化简为:
$$
\exp\left(-\frac{k(k-1)}{2N}\right) = 0.999
$$
两边取自然对数:
$$
-\frac{k(k-1)}{2N} = \ln(0.999)
$$
$$
\frac{k(k-1)}{2N} = -\ln(0.999)
$$
记 $-\ln(0.999)$ 为一个常数:
$$
C = -\ln(0.999) \approx 0.0010005003
$$
因此:
$$
k(k-1) = 2N \cdot C
$$
### 求解 k
将 $N = 56800235584$ 和 $C = 0.0010005003$ 代入:
$$
k(k-1) = 2 \cdot 56800235584 \cdot 0.0010005003
$$
$$
k(k-1) \approx 113744206.03
$$
设 $k \approx x$,近似解得:
$$
x^2 - x - 113744206.03 = 0
$$
利用二次方程求根公式:
$$
x = \frac{-b \pm \sqrt{b^2 - 4ac}}{2a}
$$
其中 $a = 1$,$b = -1$,$c = -113744206.03$:
$$
x = \frac{-(-1) \pm \sqrt{(-1)^2 - 4 \cdot 1 \cdot (-113744206.03)}}{2 \cdot 1}
$$
$$
x = \frac{1 \pm \sqrt{1 + 454976824.12}}{2}
$$
$$
x = \frac{1 \pm 21342.04}{2}
$$
取正值:
$$
x \approx \frac{1 + 21342.04}{2} \approx 10661.52
$$
### 结论
每天生成的最大ID数量 $k$ 为:
$$
k \approx 10661
$$
在这个条件下,冲突概率满足目标 $P(\text{冲突}) \leq 0.001$。
- 对于 6 个字符长度的短 ID,在 inputValues 固定的情况下,每天最多生成 10661 个 ID 时,冲突概率不超过 0.1\%。
- 如果需要更低的冲突风险,可以适当增加 ID 长度(例如 8 或 10 个字符)。
## 为什么这种方式更优?
### 相比 UUID 的优势
1. **语义化更强**:
- UUID 是随机字符串,无法直接反映与用户或上下文的关联。
- 我们生成的短 ID 包含用户的输入信息,能够在某些场景下提供更高的可读性。
2. **长度可控**:
- UUID 固定为 36 个字符,而短 ID 支持自定义长度,适应不同需求。
3. **轻量实现**:
- 无需额外依赖库,适合客户端环境。
### 适用场景
- **CDN 链接生成**:用户上传图片时,生成短 ID 并拼接成可读的文件链接,例如:`cdn.example.com/2024/12/11/x2j239a`。
- **临时标识符**:生成特定上下文的唯一标识,用于短期存储或快速检索。
- **增强用户体验**:通过语义化短 ID 提高业务数据的可解释性。
## 总结
这篇文章介绍了我在前端项目中实现的一种基于用户特定信息的短 ID 生成方法,结合 Web Crypto API,提供了高效、轻量的解决方案。通过支持上下文信息的组合和长度定制,这种短 ID 更加适应现代前端项目的需求。
---
https://zla.pub/suzublog
---
#SuzuBlog 介绍
## SuzuBlog 是什么?
可以发现我的 [ZLA小站](https://www.zla.pub) 从之前的 WordPress 改成了现在全新的样式,这个全新的样式/博客系统就是 SuzuBlog。
SuzuBlog 是一个由我自己个人从 0 开发的基于 Next.js 的博客系统,它的名字来源于日语中的铃铛 Suzu。代表着清脆的声音,也代表着我对这个博客系统的期望。
## 介绍
### 为什么要开发 SuzuBlog?
之前使用的 WordPress 是基于 PHP+MySQL 的,是在几年前基本上每个人都会选择的博客系统。但是随着时间的推移,我发现 WordPress 的一些问题:
1. **性能问题**:太慢,太慢,而且我也不是很擅长优化 WordPress 的性能。
2. **安全问题**:MySQL 数据库的安全问题,WordPress 的安全问题,插件的安全问题。
3. **不够灵活**:主题和插件虽然很多,但是我总是找不到一个满足我需求的主题。
4. **不够简洁**:后台管理界面太复杂,我只是想写一篇文章,为什么要让我看到那么多东西?
5. **不够现代**:前端界面虽然可以通过主题定制,但是总是感觉不够现代。(比如我之前所使用的 Sakura 主题,感觉有非常多人在用,但主题本身已经没有在继续更新和维护了)
还有一点,WordPress 并非为 Serverless 环境设计,也就意味着你需要一台自己的运行了 LNMP 环境的服务器,并且需要自己去维护这个服务器。我在 15 年的时候维护的 AIFans 站点,也是采用的 WordPress,数据库确实是被人攻破过,这并不是一个好的体验。
### SuzuBlog 的特点
我不是很想在这篇文章中长篇大论的介绍 SuzuBlog 的特点,如果你对此很感兴趣,可以查看我特地为 SuzuBlog 编写的文档站点 [SuzuBlog Docs](https://suzu.zla.app),或者直接查看 SuzuBlog 的 GitHub 仓库 [SuzuBlog](https://github.com/ZL-Asica/SuzuBlog)。我在文档站点中非常详细的介绍了如何上手和如何使用 SuzuBlog,同样的你若是对我的实现感兴趣,也可以直接查看源码。
简单来说,SuzuBlog 是基于 Next.js 的博客系统。文章可以使用纯 Markdown 编写(这也是为了我自己可以一篇文章同时在多个平台一起发布的原因),**当然更重要的是为了兼容 Hexo** 同样的 SEO 优化也是我进行了特定优化的一个部分,实现了完整的 robots.txt、sitemap.xml、manifest.json、LD-JSON 等等。会根据文章内容去动态生成对应的 SEO 信息。同样的,我也构建了自动的 RSS 生成器,可以让你的文章在发布的同时自动生成 RSS。
作为一个博客系统,而非一个主题/CMS,为了更好的用户体验和自定义,我借鉴了 Hexo 中的 `config.yml` 的方法,将个性化配置选项放置在了这里面,让用户可以轻松自定义去配置自己的博客系统。
### 选择 SuzuBlog 的原因
我觉得易上手是一个非常重要的特点
1. 点击 `Use this template` 按钮,就可以直接创建一个属于你自己的仓库。
2. 更改 `config.yml` 中的配置。
3. 然后将你的文章放置在 `posts` 文件夹中。
4. 最后只需要新建一个 `vercel` 账户,把 `GitHub` 仓库绑定上去,就可以直接自动部署了。
就是这么简单,仅需4步,全程可能用不了 10 分钟。无需配置服务器、无需配置数据库、无需安装 `nodejs`,只需要一个 `GitHub` 和一个 `Vercel` 账户,就可以实现一个现代化、高性能、高安全性的博客搭建。
### 技术栈
SuzuBlog 使用了以下技术栈:
1. **Next.js**:基于 React 的全栈框架,提供了 SSR、SSG、CSR 等多种渲染方式,可以轻松实现 SEO 优化。
2. **TypeScript**:我的所有源代码均使用 TS 编写,没有使用 JS 的地方(说实话我不是很喜欢用纯 JS 写项目)。
3. **TailwindCSS**:你所看到的所有样式都是使用纯 TailwindCSS 编写的,没有使用任何 CSS 预处理器/样式框架,没有 ShadCN、没有 MUI、没有 Antd。
4. **gray-matter**:一个用于解析 markdown front-matter 的库,用于解析文章的 front-matter,和处理 `` 标签。
5. **react-markdown**:封装了 `remark` 的专为 React 设计的 markdown 渲染器,用于个性化渲染 markdown。(因为你可以对其中每一种类型的标签直接进行样式定制)
6. **rss**:用于专门在 `node` 环境中生成 RSS,可以在这里查看文档 [node-rss](https://github.com/dylang/node-rss)。
同时还有下面这些我自己常用的工具库:
1. **@zl-asica/react**:我自己封装的一些 React Hooks 和工具函数等等。可以在此查看文档 [@zl-asica/react](https://react.zla.app/)。
2. **@zl-asica/prettier-config**: 我自己的 Prettier 配置,我有强迫症,代码不整齐我写不下去🥹,这里是 npm 包可以直接使用 [@zl-asica/prettier-config](https://www.npmjs.com/package/@zl-asica/prettier-config)。
3. **eslint-config-zl-asica**: 我自己的 ESLint 配置,和上面一样🥹,同样也在 npm [eslint-config-zl-asica](https://www.npmjs.com/package/eslint-config-zl-asica)。
### 样式设计
我设计的底层逻辑是遵循 `aria` 规范、`WCAG` 规范,同时需要对不同尺寸的设备友好(响应式设计)。但不对 IE 11 友好,抱歉我真做不到。遵循 `User Center Design` 设计理念,不仅让博主/站长们能够更加轻松的编写文章,专注于自己的内容创作本身,也需要让读者/用户能够更加舒适、轻松、愉快的阅读。
在设计过程中我借鉴了之前所使用的两个主题中的部分设计逻辑,分别是 [Sakura](https://github.com/mashirozx/sakura)(也就是我之前所使用的 WordPress 主题,相信很多人也听说过这个),和 [hexo-theme-nexmoe](https://github.com/theme-nexmoe/hexo-theme-nexmoe)(这个是我 Hexo 站点所使用的主题,我的 Hexo 站点并未关闭,但将会逐步迁移至此站点)。
## 迁移指南
### 从 WordPress 迁移
如果你之前在 WordPress 就是使用 markdown 进行的文章撰写,那你只需要把文章拿过来,并且加上对应的 frontmatter 即可,就这么简单。
### 从 Hexo 迁移
既然我说了`无损兼容` Hexo,那就是简单到,你只需要复制粘贴你的文章到 `posts` 文件夹内,就可以了。因为 SuzuBlog 的 frontmatter 格式设计和 Hexo 基本保持了一致。
### 从任何使用 Markdown 的博客系统迁移
如果你的博客系统使用的是 Markdown,那么你只需要把文章拿过来,并且加上对应的 frontmatter 即可,就这么简单。
## 结语
SuzuBlog 是我为了解决自己的问题而开发的一个博客系统,我希望它能够帮助到更多的人。如果你对 SuzuBlog 有任何问题或者建议,欢迎在 [GitHub Issues](https://github.com/ZL-Asica/SuzuBlog/issues) 中提出,我会尽快回复。
---
https://zla.pub/2023-annual-summary
---
#2023年度总结
> 本文概括了我在2023年的生活、学习和娱乐活动,以及我对2024年的期望和计划。在娱乐方面,我分享了自己观看的电影、番剧和纪录片,阅读的小说,以及在游戏和电子产品上的体验。在日常生活方面,我记录了自己的饮食习惯、住宿经历和各地的旅行体验。学术上,我分享了自己的成绩、参与的研究项目和开发的应用程序。此外,我还为新的一年制定了目标和计划,展望未来,期待在新的一年中取得更多成就。(ChatGPT 4.0生成)
## 娱乐
### 电影
本年度一共去电影院看过5部电影,在家看过的数目应该比这更多一些。因为美国院线上***流浪地球2***的时候没时间看,后来在家里自己补了一下,在五六月还补了部分宫崎骏的电影(**_龙猫_**、**_魔女宅急便_**)。
1. **流浪地球2 (The Wandering Earth II)** - 4.5/5.0
**_xxxx - 03/2023 - 0美元_**

这电影我是真的喜欢,不管从剧情还是特效,我个人都很满意。唯一的问题就是你不要考虑太多科学角度的问题,比如什么太空电梯这种明显花费多余可回收火箭方案的方案为什么会被使用之类的。只要不考虑过多科学角度问题就非常好看。
2. **铃芽之旅 (Suzume)** - 4.0/5.0
**_AMC - IMAX - 04/13/2023 - 20.29美元(约145人民币)_**

铃芽之旅在北美上线时间较晚,所以是4月份才看到,这已经是首映当天了。新海诚新作大家评价还是有些差别的,我个人感觉还是蛮不错的,比天气之子稍弱一些(天气之子4.5/5.0)。看的是IMAX版日语+英文字幕,这个英文字幕稍微有点影响体验,翻译风格和中国翻译风格不大一样。尤其是关门那段英文直接直译,远远不及国内的诗词翻译。
3. **超级玛利欧兄弟电影版 (The Super Mario Bros. Movie)** - 3.5/5.0
**_AMC - Dolby Vision - 04/25/2023 - 12.25美元(约86人民币)_**

因为我个人并不是玛利欧的资深老玩家,主机/掌机游戏玩的比较少也是这两年才开始接触Switch的。玩过的相关作品只有***超级马力欧:奥德赛***和***路易基鬼屋3***这两部,而且也都没有通关。我个人看的还是比较开心的,并没有什么观看门槛。
4. **变形金刚:万兽崛起 (Transformers: Rise of the Beasts)** - 2.5/5.0
**_AMC - Dolby Vision - 06/13/2023 - 13美元(约92人民币)_**

我的评级很简单,这啥玩意?说实话我能给这个评分也是全看在特效和情怀了,剧情方面我不是很好评价。太老套了这剧情。人物里也就Mirage给我的感觉会比较深刻,蛮可爱的角色。
5. **奥本海默 (Oppenheimer)** - 4.0/5.0
**_中国大陆 - 星铁IMAX - IMAX - 09/16/2023 - 约6.48美元(45.9人民币)_**

造原子弹,怎么说呢,愿世界和平。诺兰拍的电影,整体观感肯定没得说,我只说一下剧情感受。剧情方面充满了美国的人情世故的感觉,给我一种窒息的感觉,不管自己的技术水平多么强大,在政治面前只是一个小丑,非常无力。科研过程中就是会出现自我肯定和否定的交织,而这种交织在政治家看来就是可以利用的点。而且如果真的创造出一个可能毁灭全人类也有可能帮助全人类的东西,到底应该怎么选择,是继续还是停下?对于我这样平平无奇的人来说思考这些当然过多,但是对于顶尖的科学家来说他们不就是需要去面临这种困境。
6. **旺卡 (Wonka)** - 4.0/5.0
**_AMC - IMAX - 12/26/2023 - 12美元(约85人民币)_**

在年底看了这部旺卡,这绝对是全年龄都可以找到自己观看点的电影。我小时候非常喜欢看罗达尔的书,他写的基本所有书我都看过好几遍,我个人是非常喜欢的。这部电影更多是巧克力工厂的前传,讲得更多的是巧克力工厂是怎么来的,非常梦幻。注意看的时候不要考虑科不科学的问题,要不然就会很容易出戏。
### 番剧
来到番剧部分,我本年度看过的番剧和往年一样数目过多。说实话我自己都数不清楚我看了多少(统计出来103部),我会主要挑几部影响深刻的来分享和推荐一下。而且因为B站目前的看番环境,我绝大部分看的番剧都是在其他网站看的,这里特别感谢一下各位专注于番剧的日语字幕组,我自己也有字幕组所以很清楚大家所付出的努力和辛勤劳动,感谢大家!我会按照四个季度和补番5个部分来解析,只会列举部分我能够予以评价印象比较深刻的番剧,没有提到的可能是因为我没有追完或者不是很符合我的类型我没办法作出评价。
#### 2023年1月新番
本季度我看过的番剧有16部(共62部定档,观看25.8\%):久保同学不放过我、网购技能开启异世界美食之旅、转生公主与天才千金的魔法革命、冰属性男子与酷酷女同事、因为太怕痛就全点防御力了 第2期、间谍教室、别当哥哥了、变成狗后被喜欢的人捡走了、冰剑的魔术师将要统一世界、傲娇反派千金莉洁洛特与实况主远藤同学及解说员小林同学、进化之实踏上胜利的人生 第2期、关于邻家的天使大人不知不觉把我惯成了废人这件事、尼尔自动人形 Ver1.1a、为了养老金去异界存八万金、虚构推理 第2期、JOJO的奇妙冒险 石之海 Part.3、极主夫道 第2期。
- **神作**
1. 别当哥哥了! (お兄ちゃんはおしまい!) - 5.0/5.0

从第一集到最后一集,每一帧画面都透露着“我有钱”仨字,这已经溢出屏幕的经费。制作质量很高,作画与演出非常精致,节奏也舒服,是本季度我很喜欢的一部日常喜剧。
- **推荐**
1. 久保同学不放过我 - 4.0/5.0
纯爱,类似高木同学。
2. 变成狗后被喜欢的人捡走了 (?) - 4.0/5.0
这玩意我没法予以评价。
3. 虚构推理 第2期 - 4.0/5.0
推荐看完第一季再看,纯爱,非常喜欢
4. JOJO的奇妙冒险 石之海 Part.3 - 3.5/5.0
这个无需解释。
5. 极主夫道 第2期 - 3.5/5.0
很有趣,看过就明白了,黑道大佬洗白变成家庭主夫。
- **还不错**
1. 网购技能开启异世界美食之旅 - 3.5/5.0
主要是做的饭太香了我无法抵抗,而且这个丝滑小连招也太丝滑了。
2. 冰属性男子与酷酷女同事 - 3.5/5.0
剧情风格我很喜欢,办公室纯爱叠加异能。
- **答辩**
1. 间谍教室 - 1.0/5.0
这纯纯答辩,我强忍着看的,这都啥玩意呀。剧情完全没法看,作画还是蛮不错的。
2. 为了养老金去异界存八万金 - 1.0/5.0
逻辑何在?整体的逻辑就离谱,属于是把观众的智商按在地上摩擦。同样作画时蛮不错的
#### 2023年4月新番
本季度我看过的番剧有30部(共54部定档,观看55.6\%):熊熊勇闯异世界 第2期、异世界里得到了开挂般能力的我现实世界中也举世无双、绊之Allele、带着智能手机闯荡异世界 第2期、公爵的契约未婚妻、放学后失眠的你、亡骸游戏、跃动青春、THE MARGINAL SERVICE、为美好的世界献上爆焰、无神世界中的神明活动、我推的孩子、石纪元 第3期、百合是我的工作、勇者死了、国王排名 勇气的宝箱、可爱过头大危机、总之就是非常可爱 第2期、小鸟之翼 高尔夫少女 第2期、女神的露天咖啡厅、江户前的废柴精灵、天国大魔境、地狱乐、和山田进行Lv999的恋爱、我心里危险的东西、异世界一击无双姐姐、邻人似银河、第二次被异世界召唤、转生贵族的异世界冒险录、我家的英雄、进击的巨人 最终季 完结篇 前篇。
- **神作**
1. 跃动青春 (スキップとローファー) - 4.5/5.0

这个标题的翻译微偏向于意译,直译的话是跳跃和乐福鞋(Skip and Loafer),英文就是这样翻译的。整体的剧情也是高中生活交织着青春恋爱,虽然和国内普高的生活有些不同,但是高一的部分时光和初中还是可以做到类似的情况的,是比较容易产生共鸣的类别和剧情了已经算。这部番剧的内容展现的非常全面,并不是展现主角最完美的一面给你,也会给你展现他们真实的所有方面。这就是我们在高中阶段所经历的真正的经历,从青涩的青春期和直来直去向成年人的人情世故转变,变得更加柔和。这部番剧中的生活和节奏正就是我们所期望的真正高中生活的写照,除了学习和考试,我们也希望有自己的课后生活,不管是和同学一起出去看电影还是吃饭唱K,这都是我们心目中最理想里的生活。学生生活带给我们的深刻记忆不仅仅是紧张的学习生活和考试,生活中的点点滴滴、和朋友的相处更是我们生活中的重要部分。
2. 我推的孩子 (推しの子) - 4.5/5.0

首先,OP已经血洗TikTok了,也屠了日语歌的榜,确实非常好听。其次,本片又名,爸爸去哪了。整体经费爆炸,尤其第一集非常炸裂,内容和制作都非常完美。动画工坊牛逼!虽然后面有几集比较平淡,但是整体内容并没有什么问题。在这部番中也探讨到了非常重大的网络暴力问题,这已经是非常多我认为的神作里不断提到的点了(比如青春猪头少年不会遇到兔女郎学姐),这是一个非常严重的问题。主要的内容聚集在日本的偶像圈/娱乐圈的一些问题,揭露了很多的问题,可能会让一些人不是很满意。
3. 天国大魔境 (天国大魔境) - 5.0/5.0

首先是末世生存番和类似于梦幻岛的机构剧情,在开头就把吸引拉满了让人能够持续看下去。中途有一个关键设定反转(避免剧透),后半段世界观展开很猛。内容含部分猎奇元素,介意慎看。
4. 我心里危险的东西 - 4.0/5.0

纯爱恋爱番,对比放学后失眠的你受众面更大,大太多了。开头不是非常吸引人但是慢慢看下去节奏感非常好,作画也非常好。
- **推荐**
1. 放学后失眠的你 - 4.0/5.0
其实我是想给它神作的,不管从作画角度还是剧情角度我都非常喜欢。只是因为这个季度的神作有点多,一对比这个反而没那么高了。我想给神作完全是因为我个人比较喜欢这个类别,客观来看确实在推荐这个级别。主要为摄影和天文交叉的纯爱番。男女主的失眠相遇开始走到一个同好会,再到之后的一起拍照和露营,整体的风格非常好,这才是青春恋爱该有的样子,或者说理想的样子。主线的天文和摄影相对小众一些,节奏较为缓慢不适合所有人,所以可能有些人不是很喜欢这个风格。
2. 为美好的世界献上爆焰 - 3.5/5.0
阿克西斯教团万岁!慧慧的角度的番。就算没有看过为美好的世界献上祝福的朋友们也可以直接看,阿库娅只在最后才出现。作画方面有一些小问题所以扣了0.5。
3. 石纪元 第3期 - 4.0/5.0
主要是我一直都在追这个,我个人是非常喜欢这个风格的科普番的,内容和制作都非常好,不是单纯的儿童科普,也有对抗与打斗。
4. 地狱乐 - 4.0/5.0
我很纠结这个番要不要推荐说实话。我可以用这个标题来总结这部番的剧情方面内容,主打一个又地狱又乐。部分内容稍微有点猎奇,害怕的朋友不要看,确实会引发不适。MAPPA的作画真的是非常不错,非常好,剧情拖后腿。
5. 和山田进行Lv999的恋爱 - 4.0/5.0
虽然女主一开始很恋爱脑被渣男渣了,但是女主还是情商很高。比较常规的发糖番,网游只是一个媒介而已。
6. 我家的英雄 - 3.5/5.0
被作画和经费拖累的剧情,叛逆期女儿要被黑道大哥迫害之前,老爸把黑道大哥直接杀掉然后抹清证据逃亡的故事。剧情非常不错,作画非常拉跨和崩坏。
- **还不错**
1. 无神世界中的神明活动 - 3.0/5.0

这个我必须放个图,我真崩不住,这番的经费是10块钱吗。就,从剧情和内容来说我是推荐的,但是这个作画简直就是依托答辩,内容非常的炸裂,你永远想不到下一秒它能整出来什么花活,这也是为啥我给了这么高的评分还放在还不错里(说实话我甚至想放到推荐但是这个作画确实有点emmmm,总体来说和其他的推荐没法比)。
2. 总之就是非常可爱 第2期 - 3.5/5.0
续作,看的时候躺在床上当蛆就可以了,注意看完第一季再看这个观感会好一些。
3. 小鸟之翼 高尔夫少女 第2期 - 3.5/5.0
轻百,但我觉得更多的是棋逢对手的友情。角色之间的关系处理我个人觉得还是非常不错的。可以当作一个正常经费充足,剧情不错的番来看。
4. 江户前的废柴精灵 - 3.5/5.0
非常慢节奏的日常番,后期内容稍尬。
- **单纯想谈谈**
1. 熊熊勇闯异世界 第2期 - 3.0/5.0
续作,因为第一季对我来说就属于平平无奇的异世界类,所以这续作我也没法推荐,属于你要是喜欢女主和整体画风的话可以一看的水平。
2. 亡骸游戏 - 2.0/5.0
别看我给了这么低的评分,但是我还追完了就离谱,看的还蛮仔细的。但一样的问题龙傲天穿越,不知道在干啥,逻辑也很奇怪。想放到答辩里,但是感觉本季度答辩也有点多,这个还没那么答辩就放到这里了。
3. 边缘服务 (THE MARGINAL SERVICE) - 2.5/5.0
首先,剧情有点奇怪,制作和画风还可以,但是总体非常尬。这是为数不多所有字幕组都弃坑第一时间更新的番。说实话我一开始看的还可以,但是越看越感觉奇怪,非常无力吐槽了可以说。
4. 百合是我的工作 - 3.0/5.0
本身是轻百,关系方面处理的并不好。尤其是双女主的这个关系处理,感觉有点用力过猛。画风非常不错。
5. 国王排名 勇气的宝箱 - 3.0/5.0
另外一个角度,主要我比较喜欢波吉这个角色,还是感觉总体不错的。
6. 女神的露天咖啡厅 - 3.0/5.0
福利番,不要在意其他的方面了。
7. 邻人似银河 - 3.5/5.0
我个人非常喜欢这部番带来的感觉,纯爱番非常的慢节奏。把男女主之间的关系逻辑及两个家庭之间的关系梳理得非常好。慢慢看是非常好的番,很多发糖和磕点。
8. 进击的巨人 最终季 完结篇 前篇 - 3.5/5.0
我个人不是很好评价这个名字贼长贼难记的最终季。巨人十年,代表的是我们这代追番人的十年,剧情比较奇怪,所有人都在忏悔感觉,更多的是给我们自己的一个纪念,代表我们的十年。
- **答辩**
1. 异世界里得到了开挂般能力的我现实世界中也举世无双 - 2.0/5.0
经费拉满,MAPPA作画顶级。但是这个剧情真的我无力吐槽,死肥宅变帅哥,女神投怀送抱。2023年来还有这样的厕纸。如果喜欢龙傲天的可以看。
2. 绊之Allele - 0.5/5.0
???这就是我的评价。你在开玩笑吗爱酱都休眠了,还在这消费呢?
3. 带着智能手机闯荡异世界 第2期 - 2.0/5.0
从第一季开始就是厕纸,这第二季当然还是。说实话我都不能理解这是怎么出的第二季。
4. 勇者死了 - 2.0/5.0
?上来我就没绷住,就离谱这啥剧情,根本看不下去。
5. 第二次被异世界召唤 - 2.0/5.0
第二次?so what?习惯了?图啥?异世界厕纸。
6. 转生贵族的异世界冒险录 - 2.5/5.0
异世界厕纸,龙傲天,制作还可以,愿意看的可以看。
#### 2023年7月新番
本季度我看过的番剧有24部(共53部定档,观看44.4\%):甜点转生、满怀美梦的少年是现实主义者、喜欢的人忘记戴眼镜了、转生成自动贩卖机的我今天也在迷宫徘徊、我的幸福婚姻、不死少女 杀人笑剧、咒术回战 第2季、BanG Dream! It's MyGO!!!!!、圣者无双、间谍教室 第2季、租借女友 第3季、AI电子基因、能干的猫今天也忧郁、莱莎的炼金工房、AYAKA、公司里的小小前辈、其实我乃最强?、虽然等级只有1级但固有技能是最强的、庙不可言、黑暗集会、僵尸100:在成为僵尸前要做的100件事、无职转生 第2季、死神少爷与黑女仆 第2季、英雄教室。
- **神作**
1. BanG Dream! It's MyGO!!!!! - 4.0/5.0

邦邦人,邦邦魂!单纯因为这个季度实在有点拉,能把邦邦推上来,本来是我们小众人的快乐。
- **推荐**
1. 我的幸福婚姻 - 4.0/5.0
我个人很喜欢,比较霸总宠妻的感觉,纯爱,蛮女性向的一个番。男主情商很高,女主因为被原生家庭PUA的心理已经有问题了不能像正常人思考。
2. 不死少女 杀人笑剧 - 3.5/5.0
很无厘头的开局,但是之后的剧情还可以,除了部分地方比较奇怪,比如吸血鬼爸爸知道自己的儿子是杀人犯直接把儿子给活活打死。剧情节奏把控不错,不快不慢。作画优良。
3. 租借女友 第3季 - 3.5/5.0
一直追的可以继续看,主打一个舔狗男主。
4. 能干的猫今天也忧郁 - 3.5/4.0
一开始的运镜太奇怪了,和无人机拍摄一样的感觉,非常奇怪。主题很好家里又一支不用花钱还给当保姆的猫。很日常的日常番。画风和K类似。
5. 僵尸100:在成为僵尸前要做的100件事 - 4.0/5.0
开头有丑化女性的问题。稍微有点爽番感觉,适合社畜看。高分是因为作画非常强。
6. 死神少爷与黑女仆 第2季 - 4.0/5.0
直接开始在床上像蛆一样扭就好了,发糖,甜。
- **还不错**
1. 转生成自动贩卖机的我今天也在迷宫徘徊 - 3.0/5.0
日本人的XP终于向奇怪的方向发展了,剧情方面还是蛮不错的,很新颖蛮有意思。
2. 莱莎的炼金工房 - 3.0/5.0
游戏宣传类的番,剧情比较一般,主要是福利吧,更多是看腿。
3. 公司里的小小前辈 - 3.0/5.0
P9的画风不错,剧情比较套路。
4. 黑暗集会 - 3.0/5.0
恐怖动漫领域,稍微有点小恐怖。
5. 无职转生 第2季 - 3.0/5.0
抖M男主,节奏有点慢这一季。
- **单纯想谈谈**
1. 甜点转生 - 2.5/5.0
不是很好评价这个东西,本来想看甜点师和制作的,好家伙这基本上没有呀。又是龙傲天异世界转生。
2. 满怀美梦的少年是现实主义者 - 2.5/5.0
一开始男主是舔狗,女主不理人,突然某天不舔了,女主反而来了。emmmm就酱。
3. 圣者无双 - 2.5/5.0
还不错的异世界厕纸,男主人设艰苦奋斗。
4. AI电子基因 - 3.0/5.0
没法推荐的原因是这个剧情比较奇怪,想要谈论AI/机器人与人类之间的关系,但是用力很奇怪,剧情也很奇怪。关注点是好的。
5. AYAKA - 3.0/5.0
剧情还可以,就是逻辑稍微奇怪点,画风不错,真是AYAKA呀。
6. 庙不可言 - 3.0/5.0
福利番。画风还可以。
- **答辩**
1. 间谍教室 第2期 - 2.5/5.0
没想到能出第二季,虽然比第一季好,但是第一季实在是不行,影响到我对第二季的评价了。
2. 其实我乃最强?-2.5/5.0
异世界厕纸,男主数值太高测不出来被国王王后抛弃,被边境贵族收养,之后各种英藏实力和“无意”暴露实力。
3. 英雄教室 - 2.5/5.0
这玩意,有点脑溢血,男主情商过低,不停在收后宫感觉。
#### 2023年10月新番
本季度我看过的番剧有26部(共76部定档,观看35.5\%):米奇与达利、鸭乃桥论的禁忌推理、我推是反派大小姐、亡骸游戏Part.2、星灵感应、圣女魔力无所不能 第2季、BULLBUSTER、捡到被退婚大小姐的我教会她做坏坏的事、16bit的感动、想当冒险者前往都市的女儿升到了S级、大小姐和看门犬、石纪元 第3季 Part.2、葬送的芙莉莲、经验丰富的你和经验为零的我交往的故事、不死不幸、女友成堆 第2季、家里蹲吸血姬的苦闷、间谍过家家 第2季、猪肝倒是热热再吃啊、我们的雨色协议、药屋少女的呢喃、香格里拉·开拓异境~粪作猎手挑战神作~、OVERTAKE、MF Ghost极速车魂、暴食的巴萨卡、超超超超超喜欢你的100个女朋友、进击的巨人 最终季 完结篇 后篇。
- **神作**
1. 葬送的芙莉莲 (葬送のフリーレン) - 5.0/5.0

真的需要解释吗,大家看番是为了什么,不就是为了它吗。除了op有点不大匹配,内容完全挑不出来瑕疵。剧情顶级、制作顶级、配乐顶级。主线芙莉莲在漫长的岁月中看到了人类生命虽短暂但是有自己的意义。人类奋斗一生即使在当时全世界都知道但是随着时间的推移还是会被人类忘却的事实。寿命和生存的意义带给了我们深刻的思考。芙莉莲最喜欢的花的魔法,也同时是老师最喜欢的魔法,也是辛美尔最喜欢的魔法。
2. 间谍过家家 第2季 (SPY×FAMILY Season 2) - 4.5/5.0

哇库哇库,可爱是无敌的。
- **推荐**
1. 米奇与达利 - 3.5/5.0
双男主和领养的父母的故事。揭露了孤儿的一些问题,原生家庭的缺失给孩子从小造成无法磨灭的心理问题非常严重。我个人看的稍微有点窒息感和无比的心疼,所以评分给不到太高。
2. 鸭乃桥论的禁忌推理 - 3.5/5.0
侦探推理番,从这个角度来说非常好看。但是有一个问题就是异能比较难理解逻辑上的联系和定位。
3. 我推是反派大小姐 - 3.5/5.0
转生乙女游戏,题材挺常见,轻百,女主抖M,攻略抖S。剧情非常好的地方就是打直球,没那么多乱七八糟的套路,看着很舒服。
4. 16bit的感动 - 3.5/5.0
实际上有点纠结是推荐还是还不错,女主有些时候不理智,而且外星人的加入有点奇怪。说实话就是在融合各种元素到一起这部番。
5. 石纪元 第3季 Part.2 - 4.0/5.0
依旧推荐,理由和Part 1一样。
6. 不死不幸 - 4.0/5.0
打斗场面非常好,剧情也非常不错,不拖沓不龙傲天。有点你的英雄学院的感觉。
7. 药屋少女的呢喃 - 3.5/5.0
日本人眼中的中国后宫。细节和中文方面有一种给意大利人吃菠萝披萨的感觉,就,这是中国后宫吗,你家中文是这么发音的。抛开这部分不谈,剧情安排比较有趣(当然也有漏洞,感觉女主来后宫断案来了),没有什么后宫的勾心斗角。网飞做的,画风制作都很棒。
8. 香格里拉·开拓异境~粪作猎手挑战神作~ - 3.5/5.0
MMORPG类型的番,内容剧情制作都很不错。题材没什么新意但是无过。
9. 超超超超超喜欢你的100个女朋友 - 3.5/5.0
虽然是后宫,但是这个设定过于逆天,这玩意100个后宫还不党争的可还行。
- **还不错**
1. 星灵感应 - 3.0/5.0
芳文社轻百日长题材,因为开头有点小尬我没大看下去,之后有机会补一下应该会好不少。芳文社不会让大家在萌豚失望的。
2. 捡到被退婚大小姐的我教会她做坏坏的事 - 3.0/5.0
稍微有点无厘头。画风很不错,设定很有意思。男主属于霸道总裁,非常不错。有发糖。
3. 经验丰富的你和经验为零的我交往的故事 - 3.0/5.0
女主的行为稍微有点不是很好评价说实话,也没乱搞,在交往期间也很专一,但还是交往很多人而且没有什么度可言。
- **单纯想谈谈**
1. 亡骸游戏Part.2 - 2.0/5.0
续作,但是这次我看不大下去了,所以这个甚至不如上半段。
2. 圣女魔力无所不能 第2季 - 2.5/5.0
续作,第一季的时候女主被召唤过来因为被认为不是圣女就被晾在一边,幸亏有好心人接受让女主有了待的地方。第二季节奏更慢,有点emmm。
3. 进击的巨人 最终季 完结篇 后篇 - 1.0/5.0
为啥不是答辩呢,因为再怎么样也是给10年的情怀画上了句号,虽然看完感觉被喂了一口答辩但是还得吃下去的感觉。
- **答辩**
1. 想当冒险者前往都市的女儿升到了S级 - 2.0/5.0
厕纸,随便看看可以。没什么实际性内容。
2. 大小姐和看门犬 - 1.0/5.0
?啥玩意这是?
3. 猪肝倒是热热再吃啊 - 2.0/5.0
母猪的产后护理。
4. 我们的雨色协议 - 0.0/5.0
我看番这么多年,第一次对一部番没有一滴好感。
5. 暴食的巴萨卡 - 2.0/5.0
开头还有点意思,越往后越没意思。
#### 其他补番
这里只谈一下我能想得起来的7部,莉可丽丝、孤独摇滚!、灵能百分百I、灵能百分百II、灵能百分百III、摇曳露营 第一季、摇曳露营 第二季。虽然但是,这七部都是神作。
1. 莉可丽丝 (リコリス・リコイル) - 4.5/5.0
07/2023 (2022)

双女主轻百。召集孤儿训练成杀手,暗杀犯罪的人,让整个社会表面上犯罪率为0。有人想要恢复正常的社会而把Lycoris捅出来,让大家攻击他们。后期的槽点有点大,尤其是女主心脏不行了给它换心脏那段,女主死活不用实弹不管是自己要死还是其他人要死都不用实弹,我不理解。
2. 孤独摇滚! (ぼっち・ざ・ろっく!) - 4.5/5.0
05/2023 (2022)

社恐小孤独,非常戳中社恐人的内心。
3. 灵能百分百 (モブサイコ100) 第I/II/III季- 4.5/5.0
06/2023 (2016/2019/2022)

灵幻师傅太善良了,专职中二病20年,一个凡人能在能力者面前侃侃而谈毫不畏惧。路人作为地表最强在灵幻师傅的帮助下保住了自己的青春。
4. 摇曳露营 ( ゆるキャン) 第1/2季 - 4.5/5.0
08/2023 (2018/2021)

芳文社yyds。
### 纪录片及剧
纪录片和剧我看的不多,很少,今年主要看过俩,一个是孤独的美食家,一个是中国救护。中国救护更多的是拓展我对于国内医疗现状及常见紧急疾病的认知。
### 小说
有一说一今年实际上就看过一本小说,会说话的肘子的《第一序列》,同时它的番我也看完了。第一序列这本小说主要讲的是末世背景下实验体和主角的大逃亡,虽然是很常见的题材但是意外的好看。大概在后段30\%的地方开始就稍显无趣了,属于主要地图刷完了没得刷开辟一块新地图跑到欧洲搞巫师去了。但是肘子说的这段话还是比较不错的。
> 废土之上,人类文明得以苟延残喘。
> 一座座壁垒拔地而起,秩序却不断崩坏。
> 有人说,当灾难降临时,精神意志才是人类面对危险的第一序列武器。
> 有人说,不要让时代的悲哀,成为你的悲哀。
> 有人说,我要让我的悲哀,成为这个时代的悲哀。
> 这次是一个新的故事。
> 浩劫余生,终见光明。
这本书我综合评分能够给到4.0/5.0,因为结尾处理不好而扣1分。

### 游戏
今年主要玩的游戏也不多,今年确实稍微忙一些娱乐的时间也减少了,我这里就把我今年玩过的所有游戏都简单说一下吧。
1. 群星 (Stellaris) - 4.0/5.0

一个让自己成为第四天灾、宇宙甲级战犯的游戏。我开始玩的版本是3.6,现在最新版本应该是3.10。群星属于RTS类游戏,和我从小玩的红警2属于一个类别。发展经济、科研、政策,然后点科技树、造战舰、占地盘,到宣称、开战、附庸、灭国。属于长线的游戏,也非常的吞噬时间,玩这个游戏要小心时间会消失(P社游戏特点)。
2. 守望先锋 2 (Overwatch 2) - 4.0/5.0

暴雪这个样子我们玩家也没办法,守望还是依旧好玩的,5人对战给到了T和主奶更大的压力,也要求C做更多的击杀而非单纯输出。现在的版本只要T或者主奶掉了就得赶紧往回拉,要不然就要团灭。
3. 城市:天际线2 (Cities Skylines II) - 4.5/5.0

这游戏,属于把城市天际线1和simcity5结合起来了一部分,再改进了一部分。有了更大更灵活的地图,更简易的平地和修路,建筑物扩展等等。也全面改进了经济系统。虽然目前来说优化是答辩我3070Ti玩4K中画质都稍微有点卡,但画质和整体游玩效果是确实没得说。希望后期能够改进建筑物扩展以后建筑物的部分不能移动或拆除的这种问题,包括80m的桥墩太窄了现在高架都没法拉。
4. 节奏大师 - 4.0/5.0

这个东西,属于情怀加分了,11月7日回归。我目前侥幸玩到了宗师段位,闯关打到了400出头。属于音游里比较入门难度的游戏(10级歌除外)。
### 电子产品
今年在电子产品方面的消费确实非常少(往年除了更新换代也确实不多),这里我就提四样我今年买的电子产品来简单聊聊。
1. 盯盯拍Z50行车记录仪 (DDPAI Z50 Dashcam) - 3.0/5.0
02/14/2023 - 145.44美元(约1030人民币)

为啥突然买个行车记录仪呢?原因很简单,我在美国农历大年初一开车出门的路上被一个皮卡恶意追尾,当时他说的比唱的都好听一口一个抱歉、一口一个对不起。我回去报了保险以后他跟保险公司说是我故意倒车撞到他?我在那等红绿灯停的好好的,看他停的离我太近往前挪,他也跟着我往前就直接撞上来了。所以买了这个行车记录仪。
说实话安装难度稍微有点,要开机用辅助线校准贴到辅助贴上,走线也要自己弄,最后我用的是点烟器取电稳定性目前来看还可以。后置摄像头画质有一些拉,前置在白天还可以,晚上噪点有一些多。
APP非常脑溢血,海外版是单独的APP和国内不一样,连接上相机以后会在手机相册里创建居多DDPAI相簿,就很脑溢血。综合下来考虑价格给了3.0。
2. AirTag - 4.0/5.0
05/11/2023 - 4个91.96美元(约650人民币) - 单价23美元(约163人民币)

其实这个东西不用我多做什么介绍大家都清楚,这次买主要是因为要出去旅游和去香港带两个月,为了保证行李的安全性。在行李箱和包里都放了一个,准确度还是可以的,目前用了半年没有低电量警告,考虑到价格也就给了一个4分。
3. NOCO Genius 1汽车蓄电池维持器 - 4.5/5.0
06/06/2023 - 27.4美元(约194人民币)

这个东西可能大家不是很清楚,因为我需要把车停在美国三个月一动不动,长时间不动车蓄电池会跑空电。这个东西可以直接接到车的蓄电池上,检测蓄电池的剩余电量,在电量过低的时候充电,满电的时候就停下来。保护电池让电池不会没电,也不会过冲。剩下了叫Jumpstart的功夫(虽然保险公司保险但是很麻烦)。
4. 小米米家血压计BPX1 - 4.0/5.0
07/05/2023 - 约30.76美元(217.73人民币)

这个东西我买的原因很简单,就是它的这个创新设计的绑带。传统的绑带需要把手从中间穿过去套到上臂,它这种设计可以直接夹在上臂然后粘上,省了一个步骤。准确度也是非常不错的,属于居家必备的小家电。唯一的问题就是虽然能够连接米家APP,但是不能自动同步到Apple Health,如果能同步的话将是绝杀。如果家里有米家网关给老人用很好,每次老人测完血压会自动通过网关上传并且给你发推送。
### 应用
今年我想要提到的应用只有一个,虽然它接近年底才出来,但我觉得还是非常有意思和方便的一个应用,那就是iOS内置的《手记》。这个APP和其他日记不一样的点就是安全和自动化,它会在你出去旅游一天回到酒店里给你推送你今天旅游的景点和也许你想要记录的内容的照片,结合地点为你带来一些思路。它也会在你没出去玩没点子写日记的时候给你提供一些好的点子方便你写日记。

### 二次元周边
今年没买什么新的手办。但是去日本的时候买了蛮多的小摆件、立牌和啪唧,都放在国内家里了。
## 生活
### 衣
说实话今年主要是体重掉了接近20公斤,之前的衣服基本上都穿不上了,趁着去日本和回国的时候买了一些优衣库和GU家的衣服(便宜)。

### 食
美国是美食荒漠的事实大家都知道,虽然比英国肯定是好不少,但问题在于有吃的我吃不起呀...所以问题在我,不是他们贵,是我穷。下面就是我本年在美国、日本、香港、深圳等地方吃到的我觉得还能拿上台面给大家分享一下的美食,包含粤菜、美式快餐、日料、意大利菜、甜品、和CUHK的食堂。当然最后也有我自己今年部分自己做的菜,在美国大多数时候自己做正经菜还是煎牛排或者烤东西这种比较快和简单的菜。
- 首先是甜品和快餐们,把他们放到一起单纯为了节省空间。左边一列是甜品,右侧两列最上面两个是香港的麦当劳早餐、美国KFC的限定炸鸡汉堡、美国Dominos的披萨(脆底)、狗蛋的汉堡店、In-N-Out(我的食堂)我最常吃的Protein Double Double、拉斯维加斯吃到的龙虾卷、拉斯维加斯喝到的16种全球可乐。

- 然后是港中文CUHK的食堂,我主要吃的就是和声书院楼下的(因为不出门,太麻烦了)。一顿饭价格在40-60港币不等,在学校两个月已经把所有能点的都点过一遍了。

- 接下来是我在美国、香港、深圳吃到的粤菜们。最上面是早茶(最爱糯米鸡、虾饺、豉汁排骨)、接下来是烧腊们(最爱烧鹅)、然后是云吞面、牛肚面、肉骨茶。

- 然后是我们的意大利菜,披萨、肉丸、意面、risotto(意大利烩饭)、和一个奇怪的可可加咖啡腌制过的煎牛排

- 接下来是日料们,上面两排是寿司、接下来是寿喜烧、烤肉、鳗鱼饭、日式早餐、拉面、沾面。

- 最后是泰餐,最多的还是泰式咖喱了。

- 最后就是我自己做的一部分饭了。今年做了两次肘子、一次龙虾、无数次牛排、鸡翅、鱼等。

### 住
今年一共离境美国大概3个半月,除了那段时间其他时间和去拉斯维加斯玩的几天,其他时候我都在自己租的房子里面待着。房租一个月是1200美金,2b2b condo中的1b1b,已经住了一年多了。暑假的时候恰好有隔壁实验室的好姐妹需要就转租给她了两个半月多。
6月初放假后在去香港的路上顺路去了东京玩。住了银座名铁穆瑟酒店4晚,一个人约150美元(1078人民币)。说实话这家是稍微有点小,大概能打开3个28寸的行李箱房间就没有落脚的地方了,但这么小的房间居然一应俱全,佩服。最后一晚是用AMEX Hilton Aspire送的Free Night换的Conrad Tokyo,一分钱没花,钻卡运气不错去的早给升到了海景套,当晚现金价格是大概870美元(约6150人民币)。这家虽然设施比较老,但总体住的还是蛮舒服的,外加上钻卡的行政酒廊也还可以。下面是东京康莱德海景套房的内饰和行政酒廊的情况。


来到香港以后住了两个月港中文的和声书院宿舍,8000港币两个月,双人间单独的床、桌子、柜子,有空调,不计电费。每层共用浴室和卫生间。
去拉斯维加斯期间住的是Hilton旗下挂Double Tree牌子的Tropicana,主要为了用掉Aspire送的250刀resort credit。定的普通房三晚一个人141.3,钻卡在美国不好使,就给升到了高级房,好在给了个最边上的房间还大一些有一些风景。早餐不用想一个人就给13刀credit没有免费早餐。总体体验还可以,给小费home keeper也没拿。
### 行
今年我自己的车一共开了6547 miles(10,520 km),消耗燃油232 gallon(879 L),平均油耗27.66 MPG(8.54 L/100KM)。一共油费大概是1300美元(约9200人民币),约每加仑5.6美元(10.5人民币/升)。

在日本玩的时候都靠地铁和电车,没打过车(要命地贵),大概一共花了35美元(248人民币)6天的地铁和电车。在香港除了从机场到宿舍和宿舍到机场行李太多只能打车(单程340港币-红色出租车),其他时候都靠地铁(也贼贵),坐地铁可能花了四百多港币吧(八达通充值比较复杂不好记账)。在深圳玩的时候基本上靠打车和地铁,国内打车太便宜了。
今年一共飞了6段,全都是现金票买的(积分换不是很划算)。洛杉矶到东京羽田坐的delta,北美航司没什么期待,LAX也没有PPS的休息室。东京羽田到香港坐的香港快运,廉航能到地方就行,一直在购物,羽田我去的时候没有PPS的休息室。香港回到青岛坐东航买的留学生票,上海虹桥转机,行李过多。香港机场chase的休息室吃的还不错,有炖牛肉和云吞面,还有一些常规冷盘。这个迪士尼联名飞机还不算难看,挺好。到上海因为香港雷暴雨晚点,给免费改签了最近的一班飞机,给了第一排的位置,一个人占仨座还是蛮宽敞的。上海的休息室吃的就很常规了,一些中式炒菜和面条。东航从上海到青岛这么短还给了个搭配蛮不错的简餐,挺好。自从胶东机场建好我就从这飞到美国,两年了终于第一次在这里落。
从青岛回洛杉矶的时候买的新航学生票。青岛国际出发的休息室餐食蛮不错,早餐有面、炒菜、面包、各种饮料和零食。前段青岛到新加坡是酷航,给免费饮料和餐食(没提前定就只有vegan),新加坡这个饮料分级蛮好玩,常温的可乐不好喝(就算可口也不好使)。在新加坡停留一晚第二天飞洛杉矶,樟宜的休息室也非常不错,我们亚洲机场的休息室是真的蛮好吃的种类还多。飞洛杉矶中途在成田经停一个小时,提前网上订好了免税商品赶紧去付钱拿着东西走人,休息室顺道看了一眼感觉蛮小但是吃的挺全。新航的餐食还是蛮好吃的,餐后甜点是梦龙。

### 信用卡
今年毕竟进了524本来想安分守己一些,但实在是忍不住,一共开了4张卡,如果想要refer link的可以在下面评论区问我要或者直接给我发邮件,我就不直接放在这里了。2月开了AMEX Hilton Aspire秒批CL 8K、4月CSP说可以破524直接来了一张秒批CL10K、5月看到Bilt有开卡5X正好有大额消费就开了也是秒批CL 2K、最后一张是10月份AMEX Hilton系列改版第一天开的无年费(pending打电话秒批CL 240K)。
### 其他
从20年开始3年了,我终于阳了一次,被人传染的,上课的时候后面有人一直咳嗽。正好有一整个周末加上周五周一。前两天高烧39度以上外加心率一直在120+,退烧药都退不下来,人直接废了,第三天开始嗓子微痛开始退烧,四五天彻底转阴。

## 生产
### 收入
今年的收入组成仍然主要为学校兼职收入,部分杂工,额外的就是信用卡薅的羊毛(积分不折现),以及前不久 Capital One 的 refer 薅了不少。
大概的信用卡点数进帐(萌新玩卡):UR-100K,MR-60K,Hilton-270K
### 债务
今年还了一大部分车贷,目前还剩最后一些,目标还是本科毕业前还完全部车贷,目前看来是可以完成的。
### 学业
今年的所有学校课程成绩总体来说非常不错,稳住了GPA的稳定增长。今年同时面临研究生申请,目前已经提交了UCLA、USC、UCSD、Purdue、NU五所学校的申请,接下来还有一堆学校等着提交。
### 科研
今年参与了一些 Research。未来的发展和研究方向也基本确定了,目前来看我会专注于 Health Care 和 Public Health 方面的 research,着重于可以运用到消费领域和临床。
### 项目
今年做的项目不算少,有前端也有后端,甚至还做了个iOS的app。同时也重构了我的 zl-saica.com 和 zla.pub 的博客后端及服务器续费。zla.icu 也是今年更新的新域名,老的 bmmw.net 作为短网址的功能也全都迁移到了icu站。app 站也用于了项目展示,下一步会做为我的个人在线简历使用。
## 2024
### 愿景
最大的愿望当然就是被最好的MS项目录取,开始我的MS生活。肯定会换一个新的城市生活,希望新的城市和新家能够符合我的期待吧。如果能在毕业后的暑假有一个比较好的衔接research项目就会更好了。另外的愿望,开启我期待的新城市生活节奏!
### OKR
**O1: 健康管理**
KR1: 早睡早起23:30-7:30。
KR2: 维持现有饮食结构,抗炎饮食。
KR3: 增加运动,至少每周1-2次(最好2次吧...),每次15min以上。
**O2: 内容创作**
KR1: 博客每月至少更新1篇新文章,全年至少20篇文章。
KR2: 手记每周至少2-3篇,旅游至少1天一篇。
**O3: 学术目标**
KR1: 至少发1篇文章。
KR2: 完成Honor Program毕业要求。
KR3: MS第一个学期维持GPA在3.7以上。
KR4: 在MS第一个学期找到做research的组。
**O4: 财务管理**
KR1: 继续维持记账的习惯。
KR2: 阅读3本关于财务规划和投资的书籍。
KR3: 每月花销按照预算,在6月还完车贷。
KR4: 还完车贷后每月存款 + 定投指数。
**O5: 个人成长**
KR1: 继续完成至少10个Coursera或者类似的在线课程。
KR2: 学习日语,完成50音图和duolingo的课程。
KR3: 阅读至少3本和专业领域不相关的专业书籍。
**🥳2024新年快乐!**
---
https://zla.pub/deep-learning-notes
---
#Deep Learning深度学习-学习笔记
> This notes' content are all based on https://www.coursera.org/specializations/deep-learning
## I. Neural Networks and Deep Learning
### 1.1 Introduction to Deep Learning
#### 1.1.1 Supervised Learning with Deep Learning
- Structured Data: Charts.
- Unstructured Data: Audio, Image, Text.
#### 1.1.2 Scale drives deep learning progress
- The larger the amount of data, the better the performance of the larger neural network compare to smaller one or supervised learning.
- Sigmoid change to ReLU will make gradient descent much more faster. Since the gradient will not go to 0 really fast.
### 1.2 Basics of Neural Network Programming
#### 1.2.1 Binary Classification
- Input: $X \in R^{nx} $
- Output: 0, 1
#### 1.2.2 Logistic Regression
- Given $x$, want $\hat{y} = P(y=1|x)$
- Input: $x \in R^{n_x} $
- Parameters: $w \in R^{n_x}, b \in R $
- Output $\hat{y} = \sigma(w^Tx + b)$
- $\sigma(z)=\dfrac{1}{1+e^{-z}}$
- If $z $ large, $\sigma(z)\approx\dfrac{1}{1+0}\approx1$
- If $z $ large negative number, $\sigma(z)\approx\dfrac{1}{1+Bignum}\approx0$
- Loss (error) function:
- $\hat{y} = \sigma(w^Tx + b)$, where $\sigma(z)=\dfrac{1}{1+e^{-z}}$
- $z^{(i)}=w^Tx^{(i)}+b$
- Want $y^{(i)} \approx \hat{y}^{(i)} $
- $L(y, \hat{y}) = -[y \log(\hat{y}) + (1 - y) \log(1 - \hat{y})]$
- If $y=1: L(\hat{y}, y)=-\log{\hat{y}} $ <- want $\log{\hat{y}}$ as large as possible, want $\hat{y}$ large
- If $y=0: L(\hat{y}, y)=-\log{(1-\hat{y})} $ <- want $\log{(1-\hat{y})}$ as large as possible, want $\hat{y}$ small
- Cost function
- $J(w, b)=\dfrac{1}{m}\sum\limits_{i=1}^{m}L(\hat{y}^{(i)},y^{(i)})=-\dfrac{1}{m}\sum\limits_{i=1}^{m}L[y^{(i)} \log(\hat{y}^{(i)}) + (1 - y^{(i)}) \log(1 - \hat{y}^{(i)})]$
#### 1.2.3 Gradient Descent
- Repeat $w:=w-\alpha\dfrac{dJ(w)}{dw}$; $b:=b-\alpha\dfrac{\partial J(w,b)}{\partial b}$
- $\alpha$: Learning rate
- Right side of minimum, $\dfrac{dJ(w)}{dw} > 0$; Left side of minimum, $\dfrac{dJ(w)}{dw} < 0$
- Logistic Regression Gradient Descent
- $x_1,x_2,w_1,w_2,b$
- $z=w_1x_1+w_2x_2+b$ -->$a=\sigma(z)$ -->$L=(a,y)$
- $da=\dfrac{dL(a,y)}{da}=-\dfrac{y}{a}+\dfrac{1-y}{1-a}$
- $\dfrac{dL(y,a)}{da} = \dfrac{d}{da}(-y\log(a) - (1-y)\log(1-a))$
- $\dfrac{d}{da} (-y\log(a)) = -\dfrac{y}{a}$
- $\dfrac{d}{da} (-(1-y)\log(1-a)) = -\dfrac{1-y}{1-a} \times (-1) = \dfrac{1-y}{1-a} $
- $=-\dfrac{y}{a} + \dfrac{1-y}{1-a} = -\dfrac{y}{a} - \dfrac{y-1}{1-a}$
- $dz=\dfrac{dL}{dz}=\dfrac{dL(a,y)}{dz}=a-y$
- $=\dfrac{dL}{da}\cdot\dfrac{da}{dz}$ ($\dfrac{da}{dz}=a(1-a)$)
- $\dfrac{dL}{dw_1}="dw_1"=x_1\cdot dz$
- $\dfrac{dL}{dw_2}="dw_2"=x_2\cdot dz$
- $db=dz$
- Gradient Descent on $m$ examples
- $J(w, b)=\dfrac{1}{m}\sum\limits_{i=1}^{m}L(a^{(i)},y^{(i)})$
- $\dfrac{\partial}{\partial w_1}J(w,b)=\dfrac{1}{m}\sum\limits_{i=1}^{m}\dfrac{\partial}{\partial w_1}L(a^{(i)},y^{(i)})$
- $J=0;dw_1=0;dw_2=0;db=0$
- for $i=1$ to $m$
- $z^{(i)}=w^Tx^{(i)}+b$
- $a^{(i)}=\sigma (z^{(i)})$
- $J+=-[y^{(i)}loga^{(i)}+(1-y^{(i)})log(1-a^{(i)})]$
- $dz^{(i)}=a^{(i)}-y^{(i)}$
- $dw_1+=x_1^{(i)}dz^{(i)}$ (for n = 2)
- $dw_2+=x_2^{(i)}dz^{(i)}$ (for n = 2)
- $db+=dz^{(i)}$
- $J/=m;dw_1/=m;dw_2/=m;db/=m$
- $dw_1=\dfrac{\partial J}{\partial w_1}; dw_2=\dfrac{\partial J}{\partial w_2}$
- $w_1:=w_1-\alpha dw_1$
- $w_2:=w_2-\alpha dw_2$
- $b:=b-\alpha db$
#### 1.2.4 Computational Graph
- $J(a,b,c)=3(a+bc)$
- $u=bc$
- $v=a+u$
- $J=3v$
- Left to right computation
- Derivatives with a Computation Graph
- $\dfrac{dJ}{dv}=3$
- $\dfrac{dJ}{da}=3$
- $\dfrac{dv}{da}=1$
- Chain Rule: $\dfrac{dJ}{da}=\dfrac{dJ}{dv}\cdot\dfrac{dv}{da}$
- $\dfrac{dJ}{du}=3; \dfrac{du}{db}=2; \dfrac{dJ}{db}=6$
- $\dfrac{du}{dc}=3; \dfrac{dJ}{dc}=9$
#### 1.2.5 Vectorization
- avoid explicit for-loops.
- $J=0;dw=np.zeros((n_x,1));db=0$
- for $i=1$ to $m$
- $z^{(i)}=w^Tx^{(i)}+b$
- $a^{(i)}=\sigma (z^{(i)})$
- $J+=-[y^{(i)}loga^{(i)}+(1-y^{(i)})log(1-a^{(i)})]$
- $dz^{(i)}=a^{(i)}-y^{(i)}$
- $dw+=x^{(i)}dz^{(i)}$
- $db+=dz^{(i)}$
- $J/=m;dw/=m;db/=m$
- $Z=np.dot(w.T,x)+b$ ; b(1,1)-->Broodcasting
- Vectorization Logistic Regression
- $dz^{(1)}=a^{(1)}-y^{(1)}; dz^{(2)}=a^{(2)}-y^{(2)}...$
- $dz=[dz^{(1)}, dz^{(2)},...,dz^{(m)}]$ $1\times m$
- $A=[a^{(1)}, a^{(2)}, ..., a^{(m)}]$ $Y=[y^{(1)}, y^{(2)}, ..., y^{(m)}]$
- $dz=A-Y=[a^{(1)}-y^{(1)}, a^{(2)}-y^{(2)}, ...]$
- Get rid of $db$ and $dw$ in for loop
- $db=\dfrac{1}{m}\sum\limits_{i=1}^{m}dz^{(i)}=\dfrac{1}{m} np.sum(dz)$
- $dw=\dfrac{1}{m}\cdot X\cdot dz^T=\dfrac{1}{m}[x^{(1)}...][dz^{(1)}...]=\dfrac{1}{m}\cdot[x^{(1)}dz^{(1)}+...+x^{(m)}dz^{(m)}]$ $n\times 1$
- New Form of Logistic Regression
- $Z=w^tX+b=np.dot(w.T, X)+b$
- $A=\sigma (Z)$
- $dz=A-Y$
- $dw=\dfrac{1}{m}\cdot X \cdot dZ^T$
- $db=\dfrac{1}{m}np.sum(dz)$
- $w:=w-\alpha dw$
- $b:=b-\alpha db$
- Broadcasting(same as bsxfun in Matlab/Octave)
- $(m,n)$+-\*/$(1,n)$->$(m,n)$ 1->m will be all the same number.
- $(m,n)$+-\*/$(m,1)$->$(m,n)$ 1->n will be all the same number
- Don't use $a = np.random.randn(5)$ $a.shape = (5,)$ "rank 1 array"
- Use $a = np.random.randn(5,1)$ or $a = np.random.randn(1,5)$
- Check by $assert(a.shape == (5,1))$
- Fix rank 1 array by $a = a.reshape((5,1))$
- Logistic Regression Cost Function
- Lost
- $p(y|x)=\hat{y}^y(1-\hat{y})^{(1-y)}$
- If $y=1$: $p(y|x)=\hat{y}$
- If $y=0$: $p(y|x)=(1-\hat{y})$
- $\log p(y|x)=\log \hat{y}^y(1-\hat{y})^{(1-y)}=y\log \hat{y}+(1-y)\log(1-\hat{y})=-L(\hat{y},y)$
- Cost
- $\log p(labels\space in\space training\space set)=\log \Pi_{i=1}^{m}p(y^{(i)},x^{(i)})$
- $\log p(labels\space in\space training\space set)=\sum\limits_{i=1}^m\log p(y^{(i)},x^{(i)})=-\sum\limits_{i=1}^mL(\hat{y}^{(i)},y^{(i)})$
- Use maximum likelihood estimation(MLE)
- Cost(minmize): $J(w,b)=\dfrac{1}{m}\sum\limits_{i=1}^mL(\hat{y}^{(i)},y^{(i)})$
### 1.3 Shallow Neural Networks
#### 1.3.1 Neural Network Representation
- 
- Input layer, hidden layer, output layer
- $a^{[0]}=x$ -> $a^{[1]}=[[a^{[1]}_1,a^{[1]}_2,a^{[1]}_3,a^{[1]}_4]]$ -> $a^{[2]}$
- Layers count by # of hidden layer+# of output layer.
- $x_1,x_2,x_3$ -> $4\space hidden\space nodes$ -> $Output\space layer$
- First hidden node: $z^{[1]}_1=w^{[1]T}_1+b^{[1]}_1, a^{[1]}_1=\sigma(z^{[1]}_1)$
- Seconde hidden node: $z^{[1]}_2=w^{[1]T}_2+b^{[1]}_2, a^{[1]}_2=\sigma(z^{[1]}_2)$
- Third hidden node: $z^{[1]}_3=w^{[1]T}_3+b^{[1]}_3, a^{[1]}_3=\sigma(z^{[1]}_3)$
- Forth hidden node: $z^{[1]}_4=w^{[1]T}_4+b^{[1]}_4, a^{[1]}_4=\sigma(z^{[1]}_4)$
- Vectorization
- $w^{[1]}=\begin{gathered}\begin{bmatrix}-w^{[1]T}_1- \\ -w^{[1]T}_2- \\ -w^{[1]T}_3- \\ -w^{[1]T}_4- \end{bmatrix}\end{gathered} (4,3)matrix$
- $z^{[1]}=\begin{gathered}\begin{bmatrix}-w^{[1]T}_1- \\ -w^{[1]T}_2- \\ -w^{[1]T}_3- \\ -w^{[1]T}_4- \end{bmatrix}\end{gathered}\cdot \begin{gathered}\begin{bmatrix}x_1 \\ x_2 \\ x_3 \end{bmatrix}\end{gathered} + \begin{gathered}\begin{bmatrix}b^{[1]}_1 \\ b^{[1]}_2 \\b^{[1]}_3 \\ b^{[1]}_4 \end{bmatrix}\end{gathered} =\begin{gathered}\begin{bmatrix}w^{[1]T}_1\cdot x+b^{[1]}_1 \\ w^{[1]T}_2\cdot x+b^{[1]}_2 \\ w^{[1]T}_3\cdot x++b^{[1]}_3 \\ w^{[1]T}_4\cdot x+b^{[1]}_4 \end{bmatrix}\end{gathered}=\begin{gathered}\begin{bmatrix}z^{[1]}_1 \\ z^{[1]}_2 \\z^{[1]}_3 \\ z^{[1]}_4 \end{bmatrix}\end{gathered}$
- $a^{[1]}=\begin{gathered}\begin{bmatrix}a^{[1]}_1 \\ a^{[1]}_2 \\a^{[1]}_3 \\ a^{[1]}_4 \end{bmatrix}\end{gathered}=\sigma(z^{[1]})$
- $z^{[2]}=W^{[2]}\cdot a^{[1]}+b^{[2]}$ $(1, 1),(1, 4),(4, 1),(1, 1)$
- $a^{[2]}=\sigma(z^{[2]})$ $(1,1),(1,1)$
- $a^{[2](i)}$: layer $2$; example $i$
- for i=1 to m:
- $z^{[1](i)}=W^{[1]}\cdot x(i)+b^{[1]}$
- $a^{[1](i)}=\sigma(z^{[1](i)})$
- $z^{[2](i)}=W^{[2]}\cdot a^{[1](i)}+b^{[2]}$
- $a^{[2](i)}=\sigma(z^{[2](i)})$
- Vectorizing of the above for loop
- $X=\begin{gathered}\begin{bmatrix}| & | & | & | \\ x^{(1)}, & x^{(2)}, & ..., & x^{(m)} \\ | & | & | & |\end{bmatrix}\end{gathered} (n_x,m)matrix$ n is different hidden units
- $Z^{[1]}=W^{[1]}\cdot X+b^{[1]}$
- $A^{[1]}=\sigma(Z^{[1]})$
- $Z^{[2]}=W^{[2]}\cdot A^{[1]}+b^{[2]}$
- $A^{[2]}=\sigma(Z^{[2]})$
- hrizontally: training examples; vertically: hidden units
#### 1.3.2 Activation Functions
- $g^{[i]}$: activation function of layer $i$
- Sigmoid: $a=\dfrac{1}{1+e^{[-z]}}$
- Tanh: $a=\dfrac{e^z-e^{[-z]}}{e^z+e^{[-z]}}$
- ReLU: $a=max(0,z)$
- Leaky ReLu: $a=max(0.01z, z)$
- Rules to choose activation function
1. Output is between {0, 1}, choose sigmoid.
2. Default choose ReLu.
- Why need non-liner activation function
- Use linear hidden layer will be useless to have multiple hidden layers. It will become $a=w'x+b'$.
- Linear may sometime use at output layer but with non-linear at hidden layers.
#### 1.3.3 Forward and Backward Propagation
- Derivative of activation function
- Sigmoid: $g'(z)=\dfrac{d}{dz}g(z)=\dfrac{1}{1+e^{[-z]}}(1-\dfrac{1}{1+e^{[-z]}})=g(z)(1-g(z))=a(1-a)$
- Tanh: $g'(z)=\dfrac{d}{dz}g(z)=1-(tanh(z))^2$
- ReLU: $g'(z)=\left\{\begin{array}{lr}0&if \space z<0 \\1&if \space z\geq0\\\usepackage{undefined}&\usepackage{if \space z=0}\end{array}\right.$
- Leaky ReLU: $g'(z)=\left\{\begin{array}{lr}0.01&if \space z<0 \\1&if \space z\geq0\end{array}\right.$
- Gradient descent for neural networks
- Parameters: $w^{[1]}(n^{[1]},n^{[2]}), b^{[1]}(n^{[2]},1),w^{[2]}(n^{[2]},n^{[1]}), b^{[2]}(n^{[2]},1)$
- $n_x=n^{[0]},n^{[1]},n^{[2]}=1$
- Cost function: $J(w^{[1]}, b^{[1]},w^{[2]}, b^{[2]})=\dfrac{1}{m}\sum\limits_{i=1}^nL(\hat{y},y)$
- Forward propagation:
- $Z^{[1]}=W^{[1]}\cdot X+b^{[1]}$
- $A^{[1]}=g^{[1]}(Z^{[1]})$
- $Z^{[2]}=W^{[2]}\cdot A^{[1]}+b^{[2]}$
- $A^{[2]}=g^{[2]}(Z^{[2]})=\sigma(Z^{[2]})$
- Back Propagation:
- $dZ^{[2]}=A^{[2]}-Y$ $Y=[y^{(1)},y^{(2)},...,y^{(m)}]$
- $dW^{[2]}=\dfrac{1}{m}dZ^{[2]}A^{[1]T}$
- $db^{[2]}=\dfrac{1}{m}np.sum(dZ^{[2]},axis=1,keepdims=True)$
- $dZ^{[1]}=W^{[2]T}dZ^{[2]}*g'^{[1]}(Z^{1})$
- $(n^{[1]},m)->element-wise\space product->(n^{[1]},m)$
- $dW^{[1]}=\dfrac{1}{m}dZ^{[1]}X^{T}$
- $db^{[1]}=\dfrac{1}{m}np.sum(dZ^{[1]},axis=1,keepdims=True)$
- Random Initialization
- $x_1,x_2->a_1^{[1]},a_2^{[1]}->a_1^{[2]}->\hat{y}$
- $w^{[1]}=np.random.randn((2,2))*0.01$
- $b^{[1]}=np.zeros((2,1))$
- $w^{[2]}=np.random.randn((1,2))*0.01$
- $b^{[2]}=0$
### 1.4 Deep Neural Networks
#### 1.4.1 Deep L-Layer Neural Network
- Deep neural network notation
- 
- $L=4$ (#layers)
- $n^{[l]}= \#\space units\space in\space layer\space l $
- $n^{[1]}=5,n^{[2]}=5,n^{[3]}=3,n^{[4]}=n^{[l]}=1$
- $n^{[0]}=n_x=3$
- $a^{[l]}=activations\space in\space layer\space l$
- $a^{[l]}=g^{[l]}(z^{[l]}),\space w^{[l]}=weights\space for\space z^{[l]},\space b^{[l]}=bias\space for\space z^{[l]}$
- $x=a^{[0]},\space \hat{y}=a^{l}$
#### 1.4.2 Forward Propagation in a Deep Network
- General: $Z^{[l]}=w^{[l]}A^{[l-1]}+b^{[l]}, A^{[l]}=g^{[l]}(Z^{[l]})$
- $x: z^{[1]}=w^{[1]}a^{[0]}+b^{[1]}, a^{[1]}=g^{[1]}(z^{[1]})$ $a^{[0]}=X$
- $z^{[2]}=w^{[2]}a^{[1]}+b^{[2]}, a^{[1]}=g^{[2]}(z^{[2]})$
- ...
- $z^{[4]}=w^{[4]}a^{[3]}+b^{[4]}, a^{[4]}=g^{[4]}(z^{[4]})=\hat{y}$
- Vectorizing:
- $Z^{[1]}=w^{[1]}A^{[0]}+b^{[1]}, A^{[1]}=g^{[1]}(Z^{[1]})$ $A^{[0]}=X$
- $Z^{[2]}=w^{[2]}A^{[1]}+b^{[2]}, A^{[2]}=g^{[2]}(Z^{[2]})$
- $\hat{Y}=g(Z^{[4]})=A^{[4]}$
- Matrix dimensions
- 
- $z^{[1]}=w^{[1]}\cdot x+b^{[1]}$
- $z^{[1]}=(3,1),w^{[1]}=(3,2),x=(2,1),b^{[1]}=(3,1)$
- $z^{[1]}=(n^{[1]},1),w^{[1]}=(n^{[1]},n^{[0]}),x=(n^{[0]},1),b^{[1]}=(n^{[1]},1)$
- $w^{[l]}/dw^{[l]}=(n^{[l]},n^{[l-1]}),b^{[l]}/db^{[l]}=(n^{[l]},1)$
- $z^{[l]},a^{[l]}=(n^{[l]},1),Z^{[l]}/dZ^{[l]},A^{[l]}/dA^{[l]}=(n^{[l]},1)$ $l=0, A^{[0]}=X=(n^{[0]},m)$
- Why deep representation?
- Earier layers learn simple features; later deeper layers put together to detect more complex things.
- Circuit theory and deep learning: Informally: There are functions you can compute with a "small" L-layer deep neural network that shallower networks require exponentially more hidden units to compute.
#### 1.4.3 Building Blocks of Deep Neural Networks
- Forward and backward functions
- 
- Layer $l:w^{[l]},b^{[l]}$
- Forward: Input $a^{[l-1]}$, output $a^{[l]}$
- $z^{[l]}:w^{[l]}a^{[l-1]}+b^{[l]}$ $cache\space z^{[l]}$
- $a^{[l]}:g^{[l]}(z^{[l]})$
- Backward: Input $da^{[l]}, cache(z^{[l]})$, output $da^{[l-1]},dw^{[l]},db^{[l]}$
- One iteration of gradient descent of neural network
- 
- How to implement?
- Forward propagation for layer $l$
- Input $a^{[l-1]}$, output $a^{[l]},cache\space (z^{[l]})$
- $z^{[l]}=w^{[l]}a^{[l-1]}+b^{[l]}$
- $a^{[l]}=g^{[l]}(z^{[l]})$
- Vectoried
- $Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]}$
- $A^{[l]}=g^{[l]}(Z^{[l]})$
- Backward propagation for layer $l$
- Input $da^{[l]}, cache(z^{[l]})$, output $da^{[l-1]},dw^{[l]},db^{[l]}$
- $dz^{[l]}=da^{[l]}*g'^{[l]}(z^{[l]})$
- $dw^{[l]}=dz^{[l]}\cdot a^{[l-1]}$
- $db^{[l]}=dz^{[l]}$
- $da^{[l-1]}=w^{[l]T}\cdot dz^{[l]}$
- Vectorized:
- $dZ^{[l]}=dA^{[l]}*g'^{[l]}(Z^{[l]})$
- $dW^{[l]}=\dfrac{1}{m}dZ^{[l]}A^{[l-1]T}$
- $db^{[l]}=\dfrac{1}{m}np.sum(dZ^{[l]},axis=1,keepdims=True)$
- $dA^{[l-1]}=W^{[l]T}\cdot dZ^{[l]}$
#### 1.4.4 Parameters vs. Hyperparameters
- Parameters: $W^{[1]}, b^{[1]}, W^{[2]}, b^{[2]},...$
- Hyperparameters (will affect/control/determine parameters):
- learning rate $\alpha$
- \# iterations
- \# of hidden units $n^{[1]},n^{[2]},...$
- \# of hidden layers
- Choice of activation function
- Later: momentum, minibatch size, regularization parameters,...
## II. Improving Deep Neural Networks: Hyperparameter Tuning, Regularization and Optimization
### 2.1 Practical Aspects of Deep Learning
#### 2.1.1 Train / Dev / Test sets
- Big data may need only 1\% or even less dev/test sets.
- Mismatched: Make sure dev/test come from same distribution
- Not having a test set might be okay. (Only dev set.)
#### 2.1.2 Bias / Variance
- Assume optimal (Bayes) error: $\approx0\%$
- High bias (underfitting): The prediction cannot classify different elemets as we want.
- Training set error $15\%$, Dev set error $16\%$.
- Training set error $15\%$, Dev set error $30\%$.
- "just right": The prediction perfectly classify different elemets as we want.
- Training set error $0.5\%$, Dev set error $1\%$.
- High variance (overfitting): The prediction 100% classify different elemets.
- Training set error $1\%$, Dev set error $11\%$.
- Training set error $15\%$, Dev set error $30\%$.
#### 2.1.3 Basic Recipe for Machine Learning
##### 2.1.3.1 Basic Recipe
- High bias(training data performance)
- Bigger network
- Train longer
- (NN architecture search)
- High variance (dev set performance)
- More data
- Regularization
- (NN architecture search)
##### 2.1.3.2 Regularization
- Logistic regression. $\min\limits_{w,b}J(w,b)$
- $w\in\mathbb{R}^{n_x}, b\in\mathbb{R}$
- $\lambda=regularization\space parameter$
- $J(w,b)=\dfrac{1}{m}\sum\limits_{i=1}^mL(\hat{y}^{(i)},y^{(i)})+\dfrac{\lambda}{2m}||w^2||_2$
- L2 regularization $||w^2||_2=\sum\limits_{j=1}^{n_x}w_j^2=w^Tw$
- L1 regularization $\dfrac{\lambda}{2m}\sum\limits_{j=1}^{n_x}|w_j|=\dfrac{\lambda}{2m}||w||_1$
- $w$ will be spouse(for L1) (will have lots of 0 in it, only help a little bit)
- Neural network
- $J(w^{[1]},b^{[1]},...,w^{[l]},b^{[l]})=\dfrac{1}{m}\sum\limits_{i=1}^{m}L(\hat{y}^{(i)},y^{(i)})+\dfrac{\lambda}{2m}\sum\limits_{l=1}^{l}||w^2||_F$
- $||w^{[l]}||_F^2=\sum\limits_{i=1}^{n^{[l-1]}}\sum\limits_{j=1}^{n^{[l]}}(w_{ij}^{[l]})^2$ $w: (w^{[l]},w^{[l-1]})$
- Frobenius norm: Square root of square sum of all elements in a matrix.
- $dw^{[l]}=(from\space backprop)+\dfrac{\lambda}{m}w^{[l]}$
- $w^{[l]}:=w^{[l]}-\alpha dw^{[l]}$ (keep the same)
- Weight decay
- $w^{[l]}:=w^{[l]}-\alpha[(from\space backprop)+\dfrac{\lambda}{m}w^{[l]}]$
- $=w^{[l]}-\dfrac{\alpha\lambda}{m}w^{[l]}-\alpha(from\space backprop)$
- $=(1-\dfrac{\alpha\lambda}{m})w^{[l]}-\alpha(from\space backprop)$
- How does regularization prevent overfitting: $\lambda$ bigger $w^{[l]}$ smaller $z^{[l]}$ smaller, which will make the activation function nearly linear(take tanh as an example). This will cause the network really hard to draw boundary with curve.
- Dropout regularization
- 
- Implementing dropout("Inverted dropout")
- Illustrate with layer $l=3$ $keep-prob=0.8$ (means 0.2 chance get dropout/be 0 out)
- $d3 = np.random.rand(a3.shape[0],a3.shape[1]) < keep-prob$ #This will set d3 to be a same shape matrix as a3 with True (1), False (0) value.
- $a3 = np.multiply(a3, d3)$ #a3\*=d3; This will let some neruons been dropout
- $a3/=keep-prob$ #inverted dropout, keep the total avtivation the same before and after dropout.
- Why work: Can't rely on any one feature, so have to spread out weights.(shrink weights)
- First make sure the J is decreasing during iteration, then turn on dropout.
- Data augmentation
- Image: crop, flop, twist...
- Early stopping
- Mid-size $||w||_F^2$
- May caused optimize cost function and not overfir at the same time.
- Orthogonalization
- Only consider optimize cost function or consider not overfit at one time.
##### 2.1.3.3 Setting up your optimization problem
- Normalizing training sets
- 
- $x=\begin{gathered}\begin{bmatrix}x_1 \\ x_2\end{bmatrix}\end{gathered}$
- Subtract mean:
- $\mu=\dfrac{1}{m}\sum\limits_{i=1}^{m}x^{(i)}$
- $x:=x-\mu$
- Normalize variance:
- $\sigma^2=\dfrac{1}{m}\sum\limits_{i=1}^{m}x^{(i)}**2$ "\*\*" element-wise
- $x/=\sigma^2$
- Use same $\mu,\sigma^2$ to normalize test set.
- Why normalize inputs?
- When inputs in very different scales will help a lot for performance and gradient descent/learning rate.
- 
- Vanishing/exploding gradients
- $w^{[l]}>I$ Just slightly, will make the gradient increase really fast (exploding).
- $w^{[l]} smaller $w_i$
- $Variance(w:)=\dfrac{1}{n}$ (sigmoid/tanh) ReLU: $\dfrac{2}{n}$ (variance can be a hyperparameter, DO NOT DO THAT)
- $w^{[l]}=np.random.randn(shapeOfMatrix)*np.sqrt(\dfrac{1}{n^{[l-1]}})$ ReLU: $\dfrac{2}{n^{[l-1]}}$
- Xavier initialization: $\sqrt{\dfrac{1}{n^{[l-1]}})}$ Sometime $\sqrt{\dfrac{2}{n^{[l-1]}+n^{[l]}})}$
- Numerical approximation of gradients
- $\dfrac{f(\theta+\epsilon)-f(\theta-\epsilon)}{2\epsilon}$
- Gradient checking (Grad check)
- Take $W^{[1]},b^{[1]},...,W^{[L]},b^{[L]}$ and reshape into a big vector $\theta$.
- Take $dW^{[1]},db^{[1]},...,dW^{[L]},db^{[L]}$ and reshape into a big vector $d\theta$.
- for each i:
- $d\theta_{approx}[i]=\dfrac{J(\theta_1,\theta_2,...,\theta_i+\epsilon,...)-J(\theta_1,\theta_2,...,\theta_i-\epsilon,...)}{2\epsilon}\approx d\theta[i]=\dfrac{\partial J}{\partial \theta_i}$
- Check Euclidean distance $\dfrac{||d\theta_{approx}-d\theta||_2}{||d\theta_{approx}||_2+||d\theta||_2}$ ($||.||_2$ is Euclidean norm, sqare root of the sum of all elements' power of 2)
- take $\epsilon=10^{-7}$, if above Euclidean distance is $\approx10^{-7}$ or smaller, is great.
- If is $10^{-5}$ or bigger may need to check.
- If is $10^{-3}$ or bigger may need to worry, maybe a bug. Check which i approx is difference between the real value.
- notes:
- Don't use in training - only to debug.
- If algorithm fails grad check, look at components to try to identify bug.
- Remember regularization. (include the $\dfrac{\lambda}{2m}$)
- Doesn't work with dropout. (since is random, implement without dropout)
- Run at random initialization; perhaps again after some training. (not work when $w,b\approx0$)
### 2.2 Optimization Algorithms
#### 2.2.1 Mini-batch gradient descent
- Batch vs. mini-batch gradient descent
- Normal batch may have large amount of data like millions of elements.
- set $m=5,000,000$
- $X=[x^{(1)},x^{(2)},x^{(3)},...,x^{(1000)},x^{(1001)},...,x^{(2000)},...,x^{(m)}] (n_x,m)$
- $Y=[y^{(1)},y^{(2)},y^{(3)},...,y^{(m)}] (1,m)$
- Mini-batches make 1,000 $x$ each.
- Mini-batch number $t:X^{\{t\}},Y^{\{t\}}$
- $x^{(i)}$ ith in trainning set, $z^{[l]}$ layer in network $X^{\{t\}}$ batch in mini-batch
- $X = [X^{\{1\}},X^{\{2\}},...,X^{\{5000\}}]$
- $Y=[Y^{\{1\}},Y^{\{2\}},Y^{\{3\}},...,Y^{(5,000)}]$
- Mini-batch gradient descent
- 1 step of gradient descent using $X^{\{t\}},Y^{\{t\}}$ (1000)
- 1 epoch: single pass through training set.
- $for\space t=1,...,5000$
- Forward prop on $X^{\{t\}}$
- $Z^{[1]}=W^{[1]}X^{\{t\}}+b^{[1]}$
- $A^{[1]}=g^{[1]}(Z^{[1]})$
- ...
- $A^{[l]}=g^{[l]}(Z^{[l]})$
- Compute cost $J^{\{t\}}=\dfrac{1}{1000}\sum\limits_{i=1}^{l}L(\hat{y}^{(i)},y^{(i)})+\dfrac{\lambda}{2\cdot1000}\sum\limits_{l=1}^{l}||w^{[l]}||_F^2$
- $\hat{y}^{(i)},y^{(i)}$ --> from $X^{\{t\}},Y^{\{t\}}$
- Backprop to compute gradient cost $J^{\{t\}}\space (using\space (X^{\{t\}},Y^{\{t\}}))$
- $w^{[l]}:=w^{[l]}-\alpha dw^{[l]}, b^{[l]}:=b^{[l]}-\alpha db^{[l]}$
- Understanding mini-batch gradient descent
- 
- If mini-batch size=m: batch gradient descent (Too long per iteration).--$(X^{\{t\}},Y^{\{t\}})=(X,Y)$
- If mini-batch size=1: Stochastic gradient descent (noisy, not converge, loos speedup from vectorization).-- Every example is it own mini-batch.
- In practice: select in-between 1 and m.
- Get lots of vectorization
- Make progress without needing to wait entire training set.
- Choosing mini-batch size
- No need for small training set ($m<2000$)
- Typical mini-batch size: 64, 128, 256, 512. (Use power of 2)
- Make sure minibatch fir in CPU/GPU memory.
#### 2.2.2 Exponentially weighted averages
- $V_t = \beta V_{t-1} + (1 - \beta) \theta_t$
- $V_t$ is the weighted average at time $t$.
- $\theta_t$ is the actual observed value at time $t$.
- $\beta$ is the decay rate (usually between 0 and 1).
- $V_{t-1}$ is the weighted average at the previous time step.
- Impact of Decay Rate $\beta$: The value of $\beta$ significantly affects the smoothness of the weighted average curve:
- A larger $\beta$ makes the curve smoother, as it gives more weight to past observations, thereby reducing the impact of recent changes on the weighted average.
- A smaller $\beta$ makes the curve more responsive to recent changes, as it gives more weight to recent observations.
- Interpretation of $\dfrac{(1-\epsilon)^{\frac{1}{\epsilon}}}{\text{some constant}} = \dfrac{1}{e}$
- Defining $\epsilon$ as $1 - \beta$ provides insight into how the influence of past data gradually diminishes as $\beta$ approaches 1 (i.e., $\epsilon$ approaches 0).
- As $\epsilon$ approaches 0, $(1-\epsilon)^{\frac{1}{\epsilon}}$ approaches $ \dfrac{1}{e}$, indicating that even though past data is given more weight (high $ \beta$), its actual impact on the current value is decreasing.
- Implementation
- $v_{\theta}:=0$
- Repear for each day:
- Get the next $\theta_t$
- $v_\theta:=\beta v_\theta+(1-\beta)\theta_t$
- Bias correction in exponentially weighted averages
- Bias correction is applied to counteract the initial bias in exponentially weighted averages, especially when the number of data points is small or at the start of the calculation.
- $\dfrac{v_t}{1-\beta^t}$ Here, $v_t $ is the uncorrected exponentially weighted average at time $t$, and $\beta$ is the decay rate.
- It ensures that the moving averages are not underestimated, particularly when $\beta$ is high and in the early stages of the iteration. With iteration goes on, the affect of this correction will become smaller since $\beta^t$ is closer to 1.
- Gradient descent with momentum
- On iteration t:
- Compute $dw, db$ on current mini-batch (whole batch if not using mini-batch)
- $v_{dw}=\beta v_{dw}+(1-\beta)dw$
- $v_{db}=\beta v_{db}+(1-\beta)db$
- $w:=w-\alpha v_{dw}, b:=b-\alpha v_{db}$
- initiate $v_{dw}\space and\space v_{db} = 0$
- Smooth out gradient descent
- The momentum term $v$ effectively provides a smoothing effect since it is an average of past gradients. This means that extreme gradient changes in a single iteration are averaged out, reducing the volatility of the update steps.
- This smoothing effect is particularly useful on loss function surfaces that are not flat or have many local minima.
- Consider set $\beta$ as $0.9$ (common, about the average last 10 gradients), it gives more weight to $v_{dw}$, consider $dw$ as the acceleration. With $beta$ decreasing, velocity increasing slower and acceleration increasing faster.
#### 2.2.3 RMSprop and Adam optimization
- RMSprop (Root Mean Square Propagation)
- On iteration t:
- Compute $dw, db$ on current mini-batch
- $s_{dw}=\beta_2 s_{dw}+(1-\beta_2)dw^2$ Hope to be relative small.
- $s_{db}=\beta_2 s_{db}+(1-\beta_2)db^2$ Hope to be relative large.
- $w:=w-\alpha\dfrac{dw}{\sqrt{s_{dw}}+\epsilon}, b:=b-\alpha\dfrac{db}{\sqrt{s_{db}}+\epsilon}$ $\epsilon$ is a relative small number($10^{-8}$) ot prevent nominator being 0.
- Slow down in vertical direction, fast in horizontal direction.
- Adam (Adaptive moment estimation) optimization algorithm
- $v_{dw}=0, s_{dw}=0. v_{db}=0, s_{dw}=0$
- On iteration t:
- Compute $dw, bd$ using current mini-batch
- $v_{dw}=\beta_1v_{dw}+(1-\beta_1)dw,v_{db}=\beta_1v_{db}+(1-\beta_1)db$
- $s_{dw}=\beta_2s_{dw}+(1-\beta_2)dw^2,s_{db}=\beta_2s_{db}+(1-\beta_2)db$
- $v_{dw}^{corrected}=\dfrac{v_{dw}}{1-\beta_1^t}, v_{db}^{corrected}=\dfrac{v_{db}}{1-\beta_1^t}$
- $s_{dw}^{corrected}=\dfrac{s_{dw}}{1-\beta_2^t}, s_{db}^{corrected}=\dfrac{s_{db}}{1-\beta_s^t}$
- $w:=w-\alpha\dfrac{v_{dw}^{corrected}}{\sqrt{s_{dw}^{corrected}}+\epsilon}, b:=b-\alpha\dfrac{v_{db}^{corrected}}{\sqrt{s_{db}^{corrected}}+\epsilon}$
- Hyperparameters choice:
- $\alpha$: needs to be tune
- $\beta_1$: 0.9 ($dw$) First moment
- $\beta_2$: 0.999 ($dw^2$) Second moment
- $\epsilon: 10^{-8}$ Not affect performance
- Learning rate decay
- 1 epoch = 1 pass through the data
- $\alpha=\dfrac{1}{1+decay-rate*epoch-num}\alpha_0$
- Other methods
- $\alpha=0.95^{epoch-num}\cdot \alpha_0$ ---- exponentially decay
- $\alpha=\dfrac{k}{\sqrt{epoch-num}}\cdot\alpha_0$ or $\dfrac{k}{\sqrt{t}}\cdot\alpha_0$ ---- discrete staircase
- Manual decay (small number of model)
- The problem of local optima
- Unlikely to stuck in a bad local optima, since there are too many dimensions and all algorithms in deep learning.
- saddle point ---- gradient = 0
- Problem of plateaus: Make learning slow
### 2.3 Hyperparameter Tuning, Batch Normalization, and Programming Frameworks
#### 2.3.1 Tuning process
- Hyperparameters
- $\alpha$: learning rate (1st)
- $\beta$: momentum (2nd)
- $\beta_1, \beta_2, \epsilon$
- \# of layers (3rd)
- \# of hidden units (2nd)
- learning rate decay (3rd)
- mini-batch size (2nd)
- Try random values: Don't use a grid
- Coarse to fine: Trying coarse random first, then fine in working well range.
#### 2.3.2 Using an appropriate scale to pick hyperparameters
- Learning rate: $\alpha = 0.0001,...,1$
- $r=-4*np.random.rand()$ ---- $r\in[-4,0]$
- $r\in[a,b]$
- $a=log_{10}0.0001 = -4, b=log_{10}1 = 0$
- $\alpha=10^r$ ----- $\alpha\in[10^{-4}...10^0]$
- Exponentially Weighted Averages Decay Rate: $\beta=0.9(last\space 10),...,0.999(last\space1000)$
- $1-\beta=0.1,...,0.001\space r\in[-3,-1]$
- Reason for focusing on this instead of single $\beta$: $\beta$ is too close to 1, small changes may have big affects.
- $1-\beta=10^r$
- $\beta=1-10^r$
- In practice:
- Re-test/Re-evaluate occasionally.
- Babysitting one model (don't have enough training capacity) (Panda): One model at one time.
- Training many models in parallel (Caviar): Can try many at same time.
#### 2.3.3 Batch Normalization
- Implementing Batch Norm
- Batch Norm: make sure hidden units have standardized mean and variance.
- Given some intermediate value in NN $z^{(1)},...,z^{(m)}-z^{[l](i)}$ ($l$ for some hidden layers, $i$ for 1 through $m$)
- $\mu=\dfrac{1}{m}\sum\limits_{i}z^{(i)}$ (Mean)
- $\sigma^2=\dfrac{1}{m}\sum\limits_i(z_i-\mu)^2$ (Variance)
- $z_{norm}^{(i)}=\dfrac{z^{(i)}-\mu}{\sqrt{\sigma^2+\epsilon}}$ (Make sure mean=0, variance=1. $\epsilon$ prevent denominator=0)
- $\widetilde{z}^{(i)}=\gamma z_{norm}^{(i)}+\beta$ ($\gamma, \beta$ are learnable parameters of model)
- If
- $\gamma=\sqrt{\sigma^2+\epsilon}$
- $\beta=\mu$
- Then $\widetilde{z}^{(i)}=z_{norm}^{(i)}$
- Use $\widetilde{z}^{[l](i)}$ instead of $z^{[l](i)}$
- Adding Batch Norm to a network
- 
- Parameters: $w^{[1]},b^{[1]},\beta^{[1]},\gamma^{[1]},...,w^{[l]},b^{[l]},\beta^{[l]},\gamma^{[l]}$
- May use gradient/Adam/momentum to tune $d\beta^{[l]}$ $\beta^{[l]}=\beta^{[l]}-\alpha d\beta^{[l]}$
- Working with mini-batches: Work the same but on single batches. No need for $b^{[l]}$, since variance are all 1. $\beta\space\space\gamma$ have same dimension with $b$.
- Implementing gradient descent (works with momentum, RMSprop, Adam)
- for $t=1$...numMiniBatches
- Compute forwardProp on $X^{{t}}$.
- In each hidden layer use BN to replace $z^{[l]}$ with $\widetilde{z}^{[l]}$
- Use backprop to compute $dw^{[l]},db^{[l]},d\beta^{[l]},d\gamma^{[l]}$ (no $db$)
- Update parameters
- $w^{[l]}:=w^{[l]}-\alpha dw^{[l]}$
- $\beta^{[l]}:=\beta^{[l]}-\alpha d\beta^{[l]}$
- $\gamma^{[l]}:=\gamma^{[l]}-\alpha d\gamma^{[l]}$
- Why does Batch Norm work
- Covariate Shift: Different test and training data (training on black cats but try to test on other color of cats).
- Internal Covariate Shift: Between different layers of the network, the distribution of inputs to each layer changes. Recursively it changes the input of the latter layer. May lead to instability and reduced efficiency.
- Batch norm reduces the problem of input values changes. Make input stable. Let the network learn more independent.
- Batch norm as regularization
- In mini-batch, each batch is scaled by the mean/variance computed on just that mini-batch. May adds some noise to each hidden layer's (since is not consider the whole training set) (similar to dropout).
- This has a slight regularization effect. (Use larger mini-batch size could reduce regularization)
- Batch Norm at test time
- $\mu, \sigma^2$: estimate using exponentially weighted average (across mini-batch).
- $ \mu*{\text{global}} = \beta \mu*{\text{global}} + (1 - \beta) \mu $
- $ \sigma^2*{\text{global}} = \beta \sigma^2*{\text{global}} + (1 - \beta) \sigma^2 $
- During testing, use the global mean and variance estimates for normalization, instead of the statistics from the current test sample or mini-batch.
#### 2.3.4 Multi-class classification
- Softmax regression
- $C$ = # classes = 4 (0,...,3)
- Output layer: 4 nodes for each class. $\hat{y}$ is (4,1) matrix, sum should be 1.
- $z^{[L]}=w^{[L]}a^{[L-1]}+b^{L}$ (4,1) vector (L represents the output layer)
- Activation function:
- $t=e^{(z^{[L]})}$ (4,1) vector
- $a^{[L]}=\dfrac{e^{z^{[L]}}}{\sum\limits_{j=1}^4t_i}\space\space(4,1), a^{[L]}_i=\dfrac{t_i}{\sum\limits_{j=1}^4t_i}$
- Hardmax: Change beigest to 1, rest all set to 0.
- Training a softmax classifier
- If $C=2$, softmax reduces to logistic regression.
- Loss function:
- $z^{[L]}$->$a^{[L]}=\hat{y}$->$L(\hat{y},y)$ (4,1)
- Backprop: $dz^{[L]}=\hat{y}-y$ (4,1) $dz^{[L]}=\dfrac{\partial{J}}{\partial{Z^{[L]}}}$
- Deep Learning frameworks
- TensorFlow
## III. Structuring Machine Learning Projects
### 3.1 ML Strategy (1)
#### 3.1.1 Setting up your goal
- Orthogonalization
- Chain of assumptions in ML
- Fir training set well on cost function: bigger network; Adam
- Fit dev set well on cost function: Regularization; Bigger training set
- Fit test set well on cost function: Bigger dev set
- Perorms well in real world: Change dev set or cost function
- Single number evaluation metric
- Precision: In examples recognized, what percentage are actually true.
- Recall: What percentage of target are correctly recognized in whole test set.
- F1 Score: Average of precision and recall. $\dfrac{1}{\dfrac{1}{P}+\dfrac{1}{R}}$ (harmonic mean)
- Dev set + Single number evaluation matrix: Speed up iteration
- Use average error rate instead of single error rate for each classes in estimate many classes at same time.
- Satisfying and optimizing matrics
- Consider classifiers with accuracy and running time.
- maximize accuracy and subject to running time <= 100ms
- Accuracy: optimizing
- Running time: satisfying
- N metic: 1 optimizing, n-1 satisfying
- Train/dev/test distributions
- Come from same distribution. (Use randomly shuffle)
- Choose a dev set and test set to reflect data you expect to get in the future and consider important to do well on.
- Size of dev/test set
- For large data set, use 98\% training, 1\% dev, 1\% test
- Size of test set: Set your test set to be big enough to give high confidence in the overall performance of your system.
- Sometime use only train+dev, without test set.
- When to change dev/test sets and metrics
- Filter pornographic images out of error rate:
- 
- Two Steps
1. How to define a metric to evaluate classifiers.
2. How to do well on this metric.
- If doing well on your metric + dev/test set does not correspond to doing well on your application, change your metric and/or dev/test set.
#### 3.1.2 Comparing to human-level performance
- Why human-level performance:
- Bayes (optimal) error: best possible error. Can never surpass.
- Humans are quite good at a lot of tasks. So long as ML is worse than humans, you can:
- Get labeled data from humans.
- Gain insight from manual error analysis: Why did a person get this right?
- Better analysis of bias/variance.
#### 3.1.3 Analyzing bias and variance
- Avoidable bias
- If training error is far from human error (bayes error), focus on bias (avoidable bias). If training error is close to human error but far from dev error, focus on variance.
- Consider human-level error as a proxy for Bayes error (since is not too far from human-level error to Bayes error).
- Understanding human-level performance:
- Based on purpose defined which is the human-level error want to use.
- If human can perform really well, we can use human-level error as proxy for Bayes error.
- Surpassing human-level performance
- Not natural perception
- Lots of data
- Improving your model performance
- The two fundamental assumptions of supervised learning
- You can fit the training set pretty well. (Avoidable bias)
- The training set performance generalizes pretty well to the dev/test set. (Variance)
- Reducing (avoidable) bias and variance
- Avoidable bias:
- Train bigger model.
- Train longer/better optimization, algorithms (momentum, RMSprop, Adam).
- NN architecture/hyperparameters search (RNN, CNN).
- Variance:
- More data.
- Regularization (L2, dropout, data augmentation).
- NN architecture/hyperparameters search.
### 3.2 ML Strategy (2)
#### 3.2.1 Error analysis
- Carrying out error analysis
- Error analysis (count mislabel, minus from the error rate get the ceiling of error rate)
- Get ~100 mislabeled dev set examples.
- Count up how many are dogs.
- Evaluate multiple ideas in parallel (ideas for cat detection)
- Fix pictures of dogs being recognized as cats
- Fix great cats (lions, panthers, etc.) being mis-recognized
- Improve performance on blurry images
- Check the details of mislabeled images (only few minutes/hours)
- 
- Cleaning up incorrectly labeled data
- DL algorithms are quite robust to random errors in the training set. (random error will not affect the algorithm too much)
- DL algorithms are less robust to systematic errors.
- When a high fraction of mistake is due to incorrectly label, should spend time to fix it.
- Correcting incorrect dev/test set examples
- Apply same process to your dev and test sets to make sure they continue to come from the same distribution.
- Consider examining examples your algorithm got right as well as ones it got wrong.
- Train and dev/test data may now come from slightly different distributions.
- Build your first system quickly, then iterate
- Set up dev/test set and metric
- Build initial system quickly
- Use Bias/Variance analysis & Error analysis to prioritize next steps.
- Training and testing on different distributions
- 200,000 from high quality webpages, 10,000 from low quality mobile app (but we care about this).
- Shuffle before use those data. (not a good option, will cause the influence of what we care small.)
- Use mobile app as dev/test set, and just really small part of training set from app. (This we will make our target to what we want.) Maybe 50\% in training, 25\% in dev, and 25\% test.
#### 3.2.2 Mismatched training and dev/test set
- Training-dev set: Same distribution as training set, but not used for training.
- Training error - Training-dev error - Dev error
- Human level - traning set error: avoidable bias
- Traning error - Training-dev error: Variance
- Training-dev error - Dev error: Data mismatch
- Dev error - Test error: degree of overfitting to dev set.
- Addressing data mismatch
- Carry out manual error analysis to try to understand difference between training and dev/test sets.
- Make training data more similar; or collect more data similar to dev/test sets.
- Artificial data synthesis:
- Possible issue (overfitting): Original data is 10000, only have the noise of 1, maybe overfit to this 1.
- Transfer learning
- Pre-training/Fine-tune
- From relatively large data to relatively small data.
- But if the target data is too small may not be suitable for transfer learning. (Depend on the outcome we want, it would be valuable to have more data)
- When makes sense (transfer from A-> B):
- Task A and B have the same input x.
- You have a lot more data for Task A than Task B (want this one).
- Low level features from A could be helpful for learning B.
#### 3.2.3 Learning from multiple tasks
- Loss function for multiple tasks
- Loss: $\hat{y}_{(4,1)}^{(i)}=\dfrac{1}{m}\sum\limits_{i=1}^m\sum\limits_{j=1}^4L(\hat{y}_j^{(i)},y_j^{(i)})$
- Sum only over valid of j with 0/1 label. (some of them may only labeled some feature)
- Unlike softmax regression: One image can have multiple labels
- When multi-task learning makes sense
- Training on a set of tasks that could benefit from having shared lower-level features.
- Usually: Amount of data you have for each task is quite similar.
- Can train a big enough neural network to do well on all the tasks.
#### 3.2.4 End-to-end deep learning
- End-to-end needs lots of data to work well.
- Breaking small data scenario into different deep learning will be better results.
- Wether to use end-to-end learning
- Pros:
- Let the data speak.
- Less hand-designing of components needed.
- Cons:
- May need large amount of data
- Excludes potentially useful hand-designed components.
- Key question: Do you have sufficient data to learn a function of the complexity needed to map x to y?
- Use DL to learn individual components.
- Carefully choose X->Y mapping depending on what tasks you can got data for.
## IV. Convolutional Neural Networks
### 4.1 Foundations of Convolutional Neural Networks
#### 4.1.1 Convolutional operatin
- Vertical Edge Detection
- Used to identify vertical edges in images, which is a crucial step in image analysis and understanding.
- A small matrix, typically 3x3 or 5x5, is used as a convolution kernel to detect vertical edges.
- The kernel slides over the image, moving one pixel at a time.
- At each position, element-wise multiplication is performed between the kernel and the overlapping image area, followed by a sum to produce an output feature map.
- High values in the output feature map indicate the presence of a vertical edge at that location.
- $
\begin{bmatrix}
1 & 0 & -1 \\
1 & 0 & -1 \\
1 & 0 & -1
\end{bmatrix}
$
- Based on this matrix example below, it will detect lighter on the left and darker on the right.
- Horizontal Edge Detection
- Brighter on the top and darker on the bottom
- $
\begin{bmatrix}
1 & 1 & 1 \\
0 & 0 & 0 \\
-1 & -1 & -1
\end{bmatrix}
$
- TBC
- Other Common Filters
- Sobel filter
- $
\begin{bmatrix}
1 & 0 & -1 \\
2 & 0 & -2 \\
1 & 0 & -1
\end{bmatrix}
$
- Scharr filter
- $
\begin{bmatrix}
3 & 0 & -3 \\
10 & 0 & -10 \\
3 & 0 & -3
\end{bmatrix}
$
- Padding
- nxn \* fxf = n-f+1 x n-f+1
- Problems of convolution:
- Shrinking output
- Through away information from edge.
- Add a padding(p) of 0
- n+2pxn+2p \* fxf = n+2p-f+1 x n+2p-f+1
- Valid convolutions: No padding
- Same convolutions: Pad so that output size is the same as the input size. (padding is $\dfrac{f-1}{2}$)
- f is usually odd.
- Strided convolution
- Stepping s steps instead of 1.
- $\dfrac{n+2p-f}{s}+1$ x $\dfrac{n+2p-f}{s}+1$ (If not integer, bound down to the nearest integer.)
- cross-correlation is the real name of convolution in DL.
- Convolution over volume
- Set the filter into the same volume as the input matrix. (e.g. RGB image with 3x3x3 filter)
- If only look at an individual channel, just make other channel with all 0.
- If consider vertical and horizontal seperately, each output 4x4, the final could stack together get a 4x4x2 volume.
- $n\times n\times n_c * f\times f \times n_c$ -> $n-f+1 \times n-f+1 \times n_c^{'}$ (\# of filters)
- One layer of a CNN
- Each output add a bias and apply non-learner to it. ReLU(Output+b) --> Consider stack all outputs after this as volume as the a in a=g(z)
- Consider output as the same as the w in z=wa+b.
- Number of parameters in one layer: If you have 10 filters that are 3x3x 3 in one layer of a neural network, how many parameters does that layer have?(Consider 3x3x3 + bias, it will be 280 parameters)
- Summary of notation (If layer 1 is a convolution layer)
- $f^{[l]}=$ filter size (3x3 filter will be f=3)
- $p^{[l]}=$ padding
- $s^{[l]}=$ stride
- Input: $n_H^{[l-1]}\times n_W^{[l-1]}\times n_C^{[l-1]}$
- Output: $n_H^{[l]}\times n_W^{[l]}\times n_C^{[l]}$
- $n_{H/W}^{[l]}=\dfrac{n_{H/W}^{[l-1]}+2p^{[l]}-f^{[l]}}{x^{[l]}}+1$ Round down to nearest integer
- Each filter is: $f^{[l]}\times f^{[l]}\times n_C^{[l-1]}$
- Activations: $a^{[l]}$ -> $n_H^{[l]}\times n_W^{[l]}\times n_C^{[l]}$ Batch gradient descent $A^{[l]}$ -> $m\times n_H^{[l]}\times n_W^{[l]}\times n_C^{[l]}$
- Weights: $f^{[l]}\times f^{[l]}\times n_C^{[l-1]}\times n_C^{[l]}$ (The last quantity is \# filters in layer l)
- bias: $n_C^{[l]}$ - $(1,1,1,n_C^{[l]})$
- A simple example ConvNet
- 
- Get the final output(7x7x40) and take it as a 1960 vector pass through logistic/softmax to get out actual final value.
- Types of layer in a convolutional network
- Convolution (CONV)
- Pooling (POOL)
- Fully connected (FC)
#### 4.1.2 Pooling layers
- No parameters to learn.
- Max pooling
- Consider input is 4x4 matrix, output a 2x2 matrix. f(filter) = 2, s(stride) = 2. Just max each 2x2 in the input and put it into one cell in the output matrix.
- Hyperparameters: f(filter) and s(stride).
- 
- Average pooling
- Instead of take the maximum, take the average.
- 
- Input: $n_H\times n_W\times n_C$
- Output: $\dfrac{n_H-f}{s}+1\times \dfrac{n_W-f}{s}+1\times n_C$ Down to the nearest integer.
#### 4.1.3 CNN example
- Fully Connected layer
- After several convolutional and pooling layers, the high-level reasoning in the neural network is done via FC layers. The output of the last pooling or convolutional layer, which is typically a multi-dimensional array, is flattened into a single vector of values. This vector is then fed into one or more FC layers.
- Role:
- **Integration of Learned Features**: FC layers combine all the features learned by previous convolutional layers across the entire image. While convolutional layers are good at identifying features in local areas of the input image, FC layers help in learning global patterns in the data.
- **Dimensionality Reduction**: FC layers can be seen as a form of dimensionality reduction, where the high-level, spatially hierarchical features extracted by the convolutional layers are compacted into a form where predictions can be made.
- **Classification or Regression**: In classification tasks, the final FC layer typically has as many neurons as the number of classes, with a softmax activation function being applied to the output. For regression tasks, the final FC layer's output size and activation function are adjusted according to the specific requirements of the task.
- Operation is similar to neurons in a standard neural network.
- Example
- 
- 
- Why convolutions?
- **Parameter sharing:** A feature detector (such as a vertical edge detector) that's useful in one part of the image is probably useful in another part of the image.
- **Sparsity of connections:** In each layer, each output value depends only on a small number of inputs.
- Training set $(x^{(1)},y^{(1)})...(x^{(m)},y^{(m)})$
- Cost $J=\dfrac{1}{m}\sum\limits_{i=1}^{m}L(\hat{y}^{(i)},y^{(i)})$
### 4.2 Deep Convolutional Models: Case Studies
#### 4.2.1 Case studies (LeNet-5, AlexNet, VGG, ResNets)
- Red notations in the image below are what the network original designed but not suitable for nowadays.
##### 4.2.1.1 LeNet-5
- **Pioneer in CNNs**: One of the earliest Convolutional Neural Networks, primarily used for digit recognition tasks.
- **Architecture:**
- Consists of 7 layers (excluding input).
- Includes convolutional layers, average pooling layers, and fully connected layers.
- **Activation Functions**: Uses sigmoid and tanh activation functions in different layers. (Not using nowadays)
- **Local Receptive Fields**: Utilizes 5x5 convolution filters to capture spatial features.
- **Subsampling Layers**: Employs average pooling for subsampling. (Using max pool nowadays)
- 
##### 4.2.1.2 AlexNet
- Multiple GPUs in the paper is outdated for today. LRN is not useful after lots of other researches.
- **Deeper Architecture**: Contains 8 learned layers, 5 convolutional layers followed by 3 fully connected layers.
- **ReLU Activation**: One of the first CNNs to use ReLU (Rectified Linear Unit) activation function for faster training.
- **Overlapping Pooling**: Uses overlapping max pooling, reducing the network's size and overfitting.
- **Data Augmentation and Dropout**: Employs data augmentation and dropout techniques for better generalization.
- 
##### 4.2.1.3 VGG-16
- **Simplicity and Depth**: Known for its simplicity and depth, with 16 learned layers.
- **Uniform Architecture**: Features a very uniform architecture, using 3x3 convolution filters with stride and pad of 1, max pooling, and fully connected layers.
- **Convolutional Layers**: Stacks convolutional layers (2-4 layers) before each max pooling layer.
- **Large Number of Parameters**: Has a high number of parameters (around 138 million), making it computationally intensive.
- **Transfer Learning**: Proved to be an excellent model for transfer learning due to its performance and simplicity.
- 
##### 4.2.1.4 ResNets
- Residual block
- 
- Main Path: $a^{[l]}$ --> Linear --> ReLU --> $a^{[l+1]}$ --> Linear --> ReLU --> $a^{[l+2]}$
- $z^{[l+1]}=W^{[l+1]}a^{[l]}+b^{[l+1]}$ $a^{[l+1]}=g(z^{[l+1]})$ $z^{[l+2]}=W^{[l+2]}a^{[l+1]}+b^{[l+2]}$ $a^{[l+2]}=g(z^{[l+2]})$
- Short Cut / Skip Connection: $a^{[l]}$ --> ReLU --> $a^{[l+2]}$
- $a^{[l+2]}=g(z^{[l+2]}+a^{[l]})$
- In normal plain network, the training error with increasing number of layers in theory will continuesly decrease. But in reality it will decrease but increase after a sweet point. What ResNet performs is decreasing training error with numbers of layers increase and the training error not increasing again.
- Why do residual networks work?
- 
- Residual networks introduce a shortcut or skip connection that allows the network to learn identity functions effectively.
- This is crucial for training very deep networks by avoiding the vanishing gradient problem.
- In a residual block:
- $X$ -> BigNN -> $a^{[l]}$ -> Residual block -> $a^{[l+2]}$
- Input $X$ is passed through a standard neural network (BigNN) to obtain $a^{[l]}$, and then it goes through the residual block to produce $a^{[l+2]}$.
- The formulation of a residual block can be represented as:
$ a^{[l+2]} = g(z^{[l+2]} + a^{[l]}) = g(w^{[l+2]} a^{[l+1]} + b^{[l+2]} + a^{[l]}) $
- Here, $g$ is the activation function.
- $z^{[l+2]}$ is the output of the layer just before the activation function.
- $w^{[l+2]}$ and $b^{[l+2]}$ are the weight and bias of the layer, respectively.
- If $w^{[l+2]} = 0$ and $b^{[l+2]} = 0$, then $a^{[l+2]} = g(a^{[l]}) = a^{[l]}$, effectively allowing the network to learn the identity function.
- In cases where the dimensions of $a^{[l+2]}$ and $a^{[l]}$ differ (e.g., $a^{[l]} \in \mathbb{R}^{128}$ and $a^{[l+2]} \in \mathbb{R}^{256}$), a linear transformation $w_s$ (e.g., $w_s \in \mathbb{R}^{256 \times 128}$) is applied to $a^{[l]}$ to match the dimensions.
- This architecture enables training deeper models without performance degradation, which was a significant challenge in deep learning before the development of ResNet.
- Understand through backdrop(**personal notes not from the class content**)
- Consider input as x, the residual block calculation as F(x), identity mapping just drag the x and add it to the residual block's calculation which makes the final value $y=F(x)+x$
- Backprop for this will be as follow
- Gradient of the Residual Blokc's Output: $\dfrac{\partial y}{\partial w}$
- This represents the gradient of the output $y$ with respect to the weights $w$.
- By chain rule: $\dfrac{\partial y}{\partial w} = \dfrac{\partial y}{\partial F(x)}\dfrac{\partial F(x)}{\partial x}\dfrac{\partial x}{\partial w} + \dfrac{\partial y}{\partial x}\dfrac{\partial x}{\partial w}$
- Since $y=F(x)+x$, $\dfrac{\partial y}{\partial F(x)}$ and $\dfrac{\partial y}{\partial x}$ should be 1
- So the formula become $\dfrac{\partial y}{\partial w} = \dfrac{\partial F(x)}{\partial x}\dfrac{\partial x}{\partial w} + \dfrac{\partial x}{\partial w}$
- Compare to without the identity mapping $x$ added. $\dfrac{\partial y}{\partial w} = \dfrac{\partial F(x)}{\partial x}\dfrac{\partial x}{\partial w}$, there is a $\dfrac{\partial x}{\partial w}$ less. Add this $x$ to $F(x)$ makes the network will not get worse results compare to before.
#### 4.2.2 Network in Network and 1 X 1 convolutions
- 1x1 convolutions
- **Functionality of 1x1 Convolutions**: A 1x1 convolution, despite its simplicity, acts as a fully connected layer applied to each pixel separately across depth. It's effectively used for channel-wise interactions and dimensionality reduction.
- **Increasing Network Depth**: 1x1 convolutions can increase the depth of the network without a significant increase in computational complexity.
- **Dimensionality Reduction**: They are often used for reducing the number of channels (depth) before applying expensive 3x3 or 5x5 convolutions, thus reducing the computational cost.
- **Feature Re-calibration**: 1x1 convolutions can recalibrate the feature maps channel-wise, enhancing the representational power of the network.
- Using 1x1 convolutions:
- Reduce dimension: Consider a 28x28x192 input with CONV 1x1 with 32 filters, the output will be 28x28x32.
#### 4.2.3 Inception network
- Motivation for inception network
- Input 28x28x192
- Use 1x1x192 with 64 filters, output 28x28x64
- Use same dimension 3x3x192, output 28x28x128
- Use same dimension 5x5x192, output 28x28x32
- use same dimension and s=1 Max-Pool, output 28x28x32.
- Final output 28x28x256.
- The problem of computational cost (Consider 5x5x192)
- 5x5x192x28x28x32 is really big, 120M.
- Bottleneck layer (Using 1x1 convolution): shrink 28x28x192 --> CONV, 1x1, 16, 1x1x192 --> 28x28x16 (Bottleneck layer) --> CONV 5x5, 32, 5x5x16 --> 28x28x32
- In total only 28x28x16+28x28x32x5x5x16=12.4M
- Inception moule
- 
- 
- The softmax in the itermediate position is used for regularization which is used avoid overfitting.
#### 4.2.4 MobileNet
- Depthwise Separable Convolution
- Depthwise Convolution
- Computational cost = \#filter params x \#filter positions x \#of filters
- Pointwise Convolution
- Computational cost = \#filter params x \#filter positions x \# of filters
- $n_c *n_c* filters$
- Cost of depthwise separable convolution / normal convolution
- $\dfrac{1}{n_c} + \dfrac{1}{f^2}$
- MobileNet v2 Bottleneck
- Residual Connection
- 
- Expansion
- Depthwise
- Pointwise (Projection)
- Similar computational cost as v1
- MobileNet V2 improves upon V1 by introducing an inverted residual structure with linear bottlenecks, which enhances the efficiency of feature extraction and information flow through the network. This architectural advancement allows V2 to achieve better performance than V1, despite having similar computational costs. Essentially, V2 optimizes the way features are processed and combined, providing more effective and complex feature representation within the same computational budget as V1.
#### 4.2.5 EfficientNet
- EfficientNet is a series of deep learning models known for high efficiency and accuracy in image classification tasks.
- **Compound Scaling**:
- It introduces a novel compound scaling method, scaling network depth, width, and resolution uniformly with a set of fixed coefficients.
- **High Efficiency and Accuracy**:
- EfficientNets provide state-of-the-art accuracy for image classification while being more computationally efficient compared to other models.
#### 4.2.6 Inception network
- Transfer Learning
- Small training set: Freeze all hidden layers (save to disk), only train the softmax unit.
- Big training set: Freeze less hidden layers, train some of the hidden layers (or use new hidden units), and also own softmax unit.
- Lots of data: Use the already trained weights and bias as initialization, re-train based on it, as well as the softmax unit.
- Data augmentation
- Common augmentation method: Mirroring, Random Cropping, (Rotation, Shearing, Local warping, ...)
- Color shifting: add/minus from RGB. Advanced: PCA / PCA color augmentation.
- Implementing distortions during training: One CPU thread doing augmentation, and other threads or GPU doing the training at same time.
- State of CV
- Data needed (little data to lots of data): Object detection < Image recognition < Speech recognition
- Lots of data - Simpler algorithms (Less hand-engineering)
- Little data - more hand-engineering ("hacks") - Transfer learning
- Two sources of knowledge
- Labeled data
- Hand engineered features/network architecture/other components
- Tips for doing well on benchmarks/winning competitions
- Ensembling: Train several networks independently and average their outputs ($\hat{y}$) 1-2\% better. (3-15 networks)
- Multi-crop at test time: Run classifier on multiple versions of test images and average results. (10-crop: center, four corner, also on mirror image the same 5 crops)
- Use open source code
- Use architectures of networks published in the literature.
- Use open source implementations if possible.
- Use pretrained models and fine-tune on your dataset.
### 4.3 Object Detection
#### 4.3.1 Object localization
- Want to detect 4 class: 1-pedestrian, 2-car, 3-motorcycle, 4-background.
- Defining the target label y: Need to out put $b_x, b_y, b_h, b_w$, class label (1-4). (In total 9 elements in the output vector).
- $y=[p_c, b_x, b_y, b_h, b_w, c_1, c_2, c_3]$
- There is an object $y=[1, b_x, b_y, b_h, b_w, c_1, c_2, c_3]$
- No object $y=[0, ?, ?, ?, ?, ?, ?, ?]$ Don't care for all of other
- Lost function:
- $L(\hat{y}, y)=(\hat{y_1} - y_1)^2 + (\hat{y_2} - y_2)^2 + ... + (\hat{y_8} - y_8)^2$ if $y_1=1$
- $L(\hat{y}, y)=(\hat{y_1} - y_1)^2$ if $y_1=0$
#### 4.3.2 Landmark detection
- Annotate key positions (points-xy coordinate) as landmarks.
#### 4.3.3 Object detection
- Object detection
- Starts with closely crops images.
- A window sliding from the top left to bottom right, once and once. If not find increase the window's size and redo the sliding.
- Run each individual image to the convnet.
- Turning FC layer into convolutional layers
- Instead directly to FC, use conv filter.
- Convolution implementation of sliding windows
- 
- Instead of do 4 times 14x14x3, new conv fc share the computation, directly using the 2x2x4.
- Output accurate bounding boxes
- YOLO algorithm
- Find the medium point of target and working into the boundary box that contains that point.
- 
- 
- Intersection over union (IoU)
- Use to check accuracy.
- Size of intersection / size of reunion (normally "Correct" if loU $\geq$ 0.5)
- 
- Non-max suppression
- Leave the maximum accuracy one, suppress all with high IoU.
- 
- 
- Anchor Boxes
- Predefine anchor boxes, associate objects with anchor boxes.
- If objects more than assigned anchor boxes, not works. Not same shape, not works.
- 
- 
- Training set
- y is 3x3x2x8 (which is \# of grids x \# of anchors x \# classes(5($p_c. b_x, b_y, b_h, b_w$) + classes))
- 
- Regision Proposals
- R-CNN: Propose regions. Classify proposed regions one at a time. Output label + bounding box.
- Fast R-CNN: Propose regions. Use convolution implementation of sliding windows to classify all the proposed regions.
- Faster R-CNN: Use convolutional network to propose regions.
- Semantic Segmentation with U-Net
- Per-pixel class labels
- 
- Deep Learning for Semantic Segmentation
- 
- Transpose Convolution
- Increase the image size.
- 
- 
- U-Net Architecture
- Skip Connections: Left one get more details in color or anything like that. Right one is more spatial information to figure out where is the object really is.
- 
- 
### 4.4 Special Applications: Face Recognition & Neural Style Transfer
#### 4.4.1 Face recognition
- Face verification vs. face recognition
- verification vs recognition ---- 1:1 vs 1:K
- Verification
- Input image, name/ID.
- Output whether the input image is that of the claimed person.
- Recognition
- Has a database of K persons
- Get an input image
- Output ID if the image is any of the K persons (or "not recognized")
- One-shot learning
- Learning from one example to recognize the person again.
- Learning a "similarity" function
- d(img1, img2) = degree of difference between images
- If d(img1, img2) $\le \tau$ "same" $\textgreater \space \tau$ "Different"
- Siamese network
- 
- Input two differnet images into two CNN and ge the result of them.
- Such as input $x^{(1)}, x^{(2)}$ seperately into two different CNN, and the output will be the encoding of each of them $f(x^{(1)}), f(x^{(2)})$
- Then compare the distance between them $d(x^{(1)}, x^{(2)}) = ||f(x^{(1)}) - f(x^{(2)})||_2^2$
- Parameters of NN define an encoding $f(x^{(i)})$
- Learn parameters so that:
- If $x^{(i)}, x^{(j)}$ are the smae person, $||f(x^{(i)}) - f(x^{(j)})||^2$ is small.
- If $x^{(i)}, x^{(j)}$ are the different person, $||f(x^{(i)}) - f(x^{(j)})||^2$ is large..
- Triplet Loss
- Learning objective: (Anchor, Positive), (Anchor, Negative)
- Want: $||f(A) - f(P)||^2 + \alpha \le ||f(A) - f(N)||^2$ $\alpha$ is the margin (similar to SVM)
- $||f(A) - f(P)||^2 - ||f(A) - f(N)||^2 + \alpha \le 0$
- Loss function
- Given 3 images A, P, N:
- $L(A, P, N) = max(||f(A) - f(P)||^2 - ||f(A) - f(N)||^2 + \alpha, 0)$
- $J = \sum\limits_{i=1}^m L(A^{(i)},P^{(i)},N^{(i)})$
- If have a training set of 10K pictures of 1k persons. Put those 10K into triplet A, P, N, then put into the loss function.
- Choosing the triplets A, P, N
- During training, if A, P, N are chosen randomly, $d(A,P) +\alpha \le d(A, N)$ is easily satisfied.
- Choose triplets that're "hard" to train on. (such as choose $d(A,P) \approx d(A,N)$)
- Training set using triplet loss to make J smaller. And make distance of d for same person small and different large.
- Face Verification and Binary Classification
- 
- $\hat{y} = \sigma (\sum\limits_{k=1}^{128}w_k|f(x^{(i)})_k-f(x^{(j)})_k| + b)$
- Only store the $f(x^{(j)})$ as pre-compute, save storage and computational resources.
- Face verification supervised learning.
#### 4.4.2 Neural style transfer
- What is it?
- 
- Cost Function
- $J(G) = \alpha J_{content}(C, G) + \beta J_{Style}(S, G)$
- Find the generated image G
1. Initiate G randomly G: 100x100x3
2. Use gradient descent to minimize J(G) $G:=G-\dfrac{\partial}{\partial G}J(G)$
- Content Cost Function
- $J(G) = \alpha J_{content}(C, G) + \beta J_{Style}(S, G)$
- Layer Selection
- Shallow layers in the network capture basic features and structures.
- Deeper layers capture more high-level details and textures.
- Typically, a layer in the middle of the network is chosen to balance between basic structures and detailed features.
- Use pre-trained Convent. (E.g., VGG netwok)
- Let a[l]\(C) and a[l]\(G) be the activation of layer $l$ on the image.
- If a[l]\(C) and a[l]\(G) are similar, both images have similar content.
- $J_{content}(C, G) = \dfrac{1}{2}||a^{{[l]}{C}} - a^{{[l]}{G}}||^2$
- Style Cost Function
- Meaning of the "style" of an image: Say you are using layer l's activation to measure "style". Degine style as correlation between activations across channels.
- Style matrix (G --> Gram matrix)
- Let $a_{i,j,k}^{[l]}=$ activation at $(i,j,k)$. $G^{[l]}$ is $n_c^{[l]}$ x $n_c^{[l]}$
- $G_{kk^{\prime}}^{[l](S)} = \sum\limits_{i=1}^{n_{H}^{[l]}}\sum\limits_{j=1}^{n_{W}^{[l]}} a_{ijk}^{[l](S)} a_{ijk\prime}^{[l](S)}$
- $G_{kk^{\prime}}^{[l](G)} = \sum\limits_{i=1}^{n_{H}^{[l]}}\sum\limits_{j=1}^{n_{W}^{[l]}} a_{ijk}^{[l](G)} a_{ijk\prime}^{[l](G)}$
- $J_{style}^{[l]}(S,G)=||G^{[l](S)} - G^{[l](G)}||_F^2$
- $=\dfrac{1}{(2n_{H}^{[l]} n_{W}^{[l]} n_{C}^{[l]})^2} \sum_k\sum_{k\prime}(G_{kk^{\prime}}^{[l](S)} - G_{kk^{\prime}}^{[l](G)})^2$
- $J_{Style}(S,G) = \sum\limits_l\lambda^{[l]}J_{Style}^{[l]}(S,G)$
- 1D and 3D Generalizations
- 1D: 14 x 1($n_c$ Channels) \* 5 x 1 --> 10x16 (16 filters)
- 3D: 14x14x14 x 1($n_c$ Channels) \* 5x5x5 x 1 --> 10x10x10 x 16 (16 filters)
## V. Sequence Models
### 5.1 Recurrent Neural Networks
#### 5.1.1 RNN model
- Notation
- Input x: $x^{<1>}, x^{<2>}, ..., x^{}$
- Total Length of input: $T_x$
- Output y: $y^{<1>}, y^{<2>}, ..., y^{}$
- Total Length of output: $T_y$
- Recurrent Neural Network
- $a^{<0>} = \vec{O}$
- $a^{<1>}=g_1(w_{aa}a^{<0>}+w_{ax}x^{<1>}+b_a)$ <-- Tanh/ReLu
- $\hat{y}^{<1>}=g_2(w_{ya}a^{<1>}+b_y)$ <-- Sigmoid
- $a^{}=g(w_{aa}a^{}+w_{ax}x^{}+b_a)=g(w_a[a^{},x^{}]+b_a)$ where $[w_{aa}, w_{ax}]=w_a$
- 
- $\hat{y}^{}=g_2(w_{ya}a^{}+b_y)=g(w_ya^{}+b_y)$
-
- 
#### 5.1.2 Backpropagation through time(BPTT)
- Total Loss for the Sequence: $L(\hat{y}, y) = \sum\limits^{T_y}_{t=1}L^{}(\hat{y}^{}, y^{})$
- Loss at Each Timestep: $L^{}(\hat{y}^{}, y^{}) = -y^{}log\hat{y}^{}-(1-y^{})log(1 - \hat{y}^{})$
- Gradient Calculations for BPTT:
- Gradient of the Loss w.r.t. Output at Each Timestep:
$\dfrac{\partial L^{}}{\partial \hat{y}^{}} = -\dfrac{y^{}}{\hat{y}^{}} + \dfrac{1 - y^{}}{1 - \hat{y}^{}}$
- Gradient of the Loss w.r.t. Weights at Each Timestep:
$\dfrac{\partial L}{\partial W} = \sum_{t=1}^{T_y} \dfrac{\partial L^{}}{\partial \hat{y}^{}} \cdot \dfrac{\partial \hat{y}^{}}{\partial W}$
- Gradient of the Loss w.r.t. Biases at Each Timestep:
$\dfrac{\partial L}{\partial b} = \sum_{t=1}^{T_y} \dfrac{\partial L^{}}{\partial \hat{y}^{}} \cdot \dfrac{\partial \hat{y}^{}}{\partial b}$
- Weight Update in Gradient Descent:
- Update Rule for Weights:
$W := W - \alpha \dfrac{\partial L}{\partial W}$
- Update Rule for Biases:
$b := b - \alpha \dfrac{\partial L}{\partial b}$
#### 5.1.3 Different types of RNNs
- Types
- One to one:
- The standard form of a neural network where there is one input and one output.
- Example: A basic classification or regression task where each input data point maps to a single output.
- One to many:
- One input leading to multiple outputs.
- Example: Music generation, where a single starting note or chord can generate a sequence of musical notes.
- Many to one:
- Multiple inputs lead to one output.
- Example: Sentiment analysis in text, where a sequence of words (input) is used to determine a sentiment label (output).
- Many to many (Same length):
- An architecture where the input and output sequences are of equal length.
- Example: Video frame labeling, where each frame in a video (input) is labeled with a tag (output), or synchronous machine translation where each input word corresponds to an output word.
- Many to many (Different length):
- The input and output sequences can be of different lengths.
- Example: Machine translation, where a sentence in one language (input) is translated into a sentence in another language (output). The lengths of the input and output sentences can vary.
- 
- Learning Model and Sequence Generation:
- Speech recognition: calculate the probability based on words before.
- 
- Sampling Novel Sequences:
- Generating Based on Previous Word:
- In this process, a model generates a sequence (like a sentence) word by word.
- Each new word is sampled based on the probabilities provided by the model, considering the previously generated words.
- Conditional Probability:
The model predicts each subsequent word based on the conditional probability given the sequence of words already generated.
- Use of `` Token:
- Generation continues until the model produces a special end-of-sequence token, often denoted as ``.
- This token indicates that the model has completed the sequence, and no further words are needed.
- Applications:
This technique is commonly used in text generation tasks like story generation, chatbots, and language modeling.
- Character-level language model:
- Vocabulary: Alphabet-Based and Words-Based.
- Vanishing Gradients with RNNs:
- Long-Term Dependencies:
In RNNs, earlier words in a sequence can have significant effects on later words, such as determining singular or plural forms or setting the context for subsequent words.
- Challenge of Long-Term Dependencies:
RNNs often struggle with maintaining information from early inputs in a sequence when predicting later outputs. This is due to the vanishing gradient problem, where gradients become increasingly small as they are propagated back through time, making it difficult for early inputs to significantly influence the network's learning.
- Local Influences:
In many cases, the outputs of RNNs are heavily influenced by inputs that are temporally close. As a result, the network might fail to recognize and learn dependencies between elements that are far apart in the sequence.
- Exploding Gradients in RNNs
- Problem Description:
RNNs can also experience exploding gradients, where gradients become excessively large. This can lead to unstable training processes and wildly oscillating network weights.
- Gradient Clipping Solution:
A common solution to the exploding gradients problem is gradient clipping. This involves setting a threshold value, and if the gradients exceed this threshold during backpropagation, they are "clipped" or rescaled to keep them within a manageable range.
#### 5.1.4 Gated Recurrent Unit (GRU)
- C = memory cell - $c^{}=a^{}$ (Just for now, LSTM different)
- In GRUs, the concept of a memory cell is simplified compared to LSTMs.
- Candidate Memory: $\tilde{c}^{}=tanh(w_c [c^{}, x^{}] + b_c)$ Previous memory and current input.
- Sometime in paper shows: $\tilde{h}$
- This represents the candidate memory, computed as a combination of the previous memory and the current input.
- Update Gate: $\Gamma_u=\sigma (w_u[c^{}, x^{}] + b_u)$
- Decides how much of the candidate memory should be used to update the current memory cell.
- Relevance Gate: $\Gamma_r=\sigma (w_r[c^{}, x^{}] + b_r)$
- It decides how much of the past information (from previous timesteps) needs to be forgotten.
- $c^{} = \Gamma_u *\tilde{c}^{} + (1 - \Gamma_u)* c^{}$ ($*$ element-wise)
- Sometime in paper show: $h$
- The current memory cell is updated by an element-wise multiplication of the update gate with the candidate memory, and the complementary part of the update gate with the previous memory.
- This formula allows the GRU to retain or forget information effectively, balancing between the candidate memory and the previous memory.


My own understanding (based on the above image):
1. Input and Hidden State: $$x_t$$ and $$h_{t-1}$$
These will be used as inputs to both the **reset gate** ($$r_t$$) and **update gate** ($$z_t$$).
2. Reset Gate ($$r_t$$): How much past information to forget
$$r_t = \sigma(W_r x_t + U_r h_{t-1})$$
- Input $$x_t$$ (blue line, bottom to top): multiplied with weight matrix $$W_r$$.
- Hidden state $$h_{t-1}$$ (orange line, top to bottom): multiplied with weight matrix $$U_r$$.
- The results are added, then passed through a sigmoid activation $$\sigma$$ to compute $$r_t$$.
- The closer $$r_t$$ is to 0, the less past information is retained.
3. Update Gate ($$z_t$$): How much of the new memory to keep
$$z_t = \sigma(W_z x_t + U_z h_{t-1})$$
- Input $$x_t$$: multiplied with weight matrix $$W_z$$.
- Hidden state $$h_{t-1}$$: multiplied with weight matrix $$U_z$$.
- The two products are summed and passed through a sigmoid activation to get $$z_t$$.
- The closer $$z_t$$ is to 1, the more new information is incorporated.
4. Candidate Hidden State ($$\tilde{h}_t$$)
$$\tilde{h}_t = \tanh(W x_t + U (r_t \odot h_{t-1}))$$
- Compute element-wise product of $$r_t$$ and $$h_{t-1}$$: $$r_t \odot h_{t-1}$$.
- Multiply input $$x_t$$ with weight matrix $$W$$.
- Multiply the reset-modified hidden state with weight matrix $$U$$.
- Sum the two results and apply $$\tanh$$ activation to get $$\tilde{h}_t$$.
- This is the "candidate" memory content to write.
5. Final Hidden State ($$h_t$$): Combine old and new memory
$$h_t = (1 - z_t) \odot h_{t-1} + z_t \odot \tilde{h}_t$$
- Left part: $$1 - z_t$$ multiplied with $$h_{t-1}$$ (retain old memory).
- Right part: $$z_t$$ multiplied with $$\tilde{h}_t$$ (add new memory).
- Combine both to get the final hidden state $$h_t$$.
#### 5.1.5 Long Short Term Memory (LSTM)
- $\tilde{c}^{}=tanh(w_c [a^{}, x^{}] + b_c)$
- Update Gate: $\Gamma_u=\sigma (w_u[a^{}, x^{}] + b_u)$
- Forget Gate: $\Gamma_f=\sigma (w_f[a^{}, x^{}] + b_f)$
- Output Gate: $\Gamma_o=\sigma (w_o[a^{}, x^{}] + b_o)$
- $c^{} = \Gamma_u *\tilde{c}^{} + \Gamma_f* c^{}$
- $a^{}=$ $\Gamma_o * {tanh} \space (c^{})$


- Peephole Connection
- Add the $c^{}$ into u/f/o. Here is an example for output gate.
- $\Gamma_o=\sigma (w_o[a^{}, x^{}, c^{}] + b_o)$

My own understanding (based on the above image):
1. Input, Hidden State, and Cell State: $$x_t$$, $$h_{t-1}$$, and $$c_{t-1}$$
These are used together to compute various gates (forget gate, update gate, and output gate) in the LSTM.
2. Forget Gate ($$f_t$$): How much past memory to forget
$$f_t = \sigma(W_f x_t + U_f h_{t-1} + b_f)$$
- Input $$x_t$$: multiplied with weight matrix $$W_f$$.
- Hidden state $$h_{t-1}$$: multiplied with weight matrix $$U_f$$.
- Add both results and apply sigmoid activation to get $$f_t$$.
- Controls how much of the previous cell state $$c_{t-1}$$ to retain.
3. Input Gate ($$i_t$$): How much new information to write
$$i_t = \sigma(W_i x_t + U_i h_{t-1} + b_i)$$
- Input $$x_t$$ and hidden state $$h_{t-1}$$ processed with weights $$W_i$$ and $$U_i$$.
- Output is passed through sigmoid to get $$i_t$$.
- Controls how much new candidate memory to allow in.
4. Candidate Cell State ($$\tilde{c}_t$$)
$$\tilde{c}_t = \tanh(W_c x_t + U_c h_{t-1} + b_c)$$
- Input $$x_t$$ and hidden state $$h_{t-1}$$ transformed and summed.
- Apply tanh to generate candidate memory $$\tilde{c}_t$$.
5. Update Cell State ($$c_t$$): Combine old and new memory
$$c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t$$
- Forget gate $$f_t$$ decides how much of the old memory $$c_{t-1}$$ to keep.
- Input gate $$i_t$$ decides how much of the candidate memory $$\tilde{c}_t$$ to write in.
- Combine both to get updated cell state $$c_t$$.
6. Output Gate ($$o_t$$): What to output from the cell
$$o_t = \sigma(W_o x_t + U_o h_{t-1} + b_o)$$
- Controls how much of the current cell state to expose as output.
7. Final Hidden State ($$h_t$$): Compute output
$$h_t = o_t \odot \tanh(c_t)$$
- Cell state $$c_t$$ is passed through tanh, then modulated by output gate $$o_t$$.
- The result is the final hidden state $$h_t$$, which can be passed to the next time step or used as output.

Peephole Connection LSTM:
Add $$c_{t-1}$$ to gates, element-wise multiply. Peephole connections allow LSTM gates to directly access the cell state, enabling more precise timing and memory control in sequential tasks.
$$f_t = \sigma(W_f x_t + U_f h_{t-1} + V_f \odot c_{t-1} + b_f)$$
$$i_t = \sigma(W_i x_t + U_i h_{t-1} + V_i \odot c_{t-1} + b_i)$$
$$o_t = \sigma(W_o x_t + U_o h_{t-1} + V_o \odot c_t + b_o)$$
#### 5.1.6 Bidirectional RNN (BRNN)
- Normal RNN cannot determine a word's meaning from the words or sentences behind it.
- Cons: For speack recognition, need to wait for the person stop talking the sentence.

1. Input and Hidden States: $$x_t$$, $$\overrightarrow{h}_{t-1}$$, and $$\overleftarrow{h}_{t+1}$$
In a BRNN, the input sequence is processed **in both forward and backward directions**:
- The **forward RNN** computes hidden states from left to right: $$\overrightarrow{h}_t$$
- The **backward RNN** computes hidden states from right to left: $$\overleftarrow{h}_t$$
- The final hidden state at time step $$t$$ is typically the **concatenation** (or sometimes sum) of both:
$$h_t = [\overrightarrow{h}_t ; \overleftarrow{h}_t]$$
2. Forward Hidden State ($$\overrightarrow{h}_t$$): Process input left to right
$$\overrightarrow{h}_t = \tanh(W_x^{(f)} x_t + W_h^{(f)} \overrightarrow{h}_{t-1} + b^{(f)})$$
- Processes input from $$t = 1$$ to $$T$$.
- Uses forward weights $$W_x^{(f)}, W_h^{(f)}, b^{(f)}$$.
- Computes hidden state based on current input and previous forward hidden state.
3. Backward Hidden State ($$\overleftarrow{h}_t$$): Process input right to left
$$\overleftarrow{h}_t = \tanh(W_x^{(b)} x_t + W_h^{(b)} \overleftarrow{h}_{t+1} + b^{(b)})$$
- Processes input from $$t = T$$ to $$1$$ (reversed).
- Uses backward weights $$W_x^{(b)}, W_h^{(b)}, b^{(b)}$$.
- Computes hidden state based on current input and _next_ backward hidden state.
4. Final Output ($$y_t$$): Merge forward and backward context
$$y_t = g([\overrightarrow{h}_t ; \overleftarrow{h}_t])$$
- Combines both directions by concatenating or summing $$\overrightarrow{h}_t$$ and $$\overleftarrow{h}_t$$.
- Function $$g(\cdot)$$ can be:
- A linear layer for classification
- A projection layer
- Or directly used as output in sequence models
#### 5.1.7 Deep RNNs

Each layer is a separate RNN with its own parameters: $$h_t^{(l)} = \tanh(W_x^{(l)} x_t^{(l)} + W_h^{(l)} h_{t-1}^{(l)} + b^{(l)})$$
- $$x_t^{(l)}$$: input at layer $$l$$ (either original input or lower-layer output)
- $$h_{t-1}^{(l)}$$: previous time step’s hidden state in the same layer
- Each layer has its own weights: $$W_x^{(l)}, W_h^{(l)}, b^{(l)}$$
### 5.2 Natural Language Processing & Word Embeddings
#### 5.2.1 Word Representation
- 1-hot representation (1-d vector)
- $$O_{5391}$$ means this is in a 1d vector at 5391th position.
- Featurized representation: word embedding
- multiple dimensions (Normally 300-dimension)
- 
- Visualizing word embeddings (t-SNE)
- Similar to cluster
- 
- Using Word Embedding
- Transfer learning and word embeddings
1. Learn word embeddings from large text corpus. (1-100B words)
(Or download pre-trained embedding online.)
2. Transfer embedding to new task with smaller training set.
(Say, 100k words)
3. Optional: Continue to finetune the word embedding with new data.
- Properties of word embeddings
- Analogies using word vectors
- 
- Cosine similarity
- $sim(e_w, e_{king} - e_{man}+e_{woman})$
- $sim(u,v)=\dfrac{u^Tv}{||u||_2||v||_2}$
 #### 5.2.2 Embedding matrix

#### 5.2.3 Learning Word Embeddings: Word2vec
- Skip-grams
- Vocab size = 10,000
- $O_c$ -> $E$ -> $e_c$ -> $o_{softmax}$ -> $\hat{y}$
- $O_c$: 1-hot; $E$: Embedding matrix; $e_c$ embedding vector
- $o_{softmax}$: output of softmax layer (probability); $\hat{y}$: the output.
- Softmax: $p(t|c) = \dfrac{e^{\theta_t^T e_c}}{\sum_{j=1}^{10,000}e^{\theta_j^T e_c}}$
- $\theta_t$ = parameter associated with output t.
- This softmax function describe in given context work $c$, the probability of $t$ become the target word.
- $L(\hat{y},y)=-\sum_{i=1}^{10,000}y_i log\hat{y_i}$
- How to sample the context c?
- Different heuristics that can use in order to balance out something from the common words together with less common words.
- Hierarchical Softmax classifier: $log|v|$, common words more on top.
- 
- Negative Sampling: Only use some negative samples use softmax to train skip-gram. Avoid calculation on the whole corpus.

My own understanding (Word2vec with Skip-gram):
1. Input and Target Words: $$w_t$$ (center word) and $$w_{t+j}$$ (context word)
- The Skip-gram model receives a single input word $$w_t$$ (center word).
- The training objective is to predict one or more context words $$w_{t+j}$$ where $$j \in [-c, c], j \ne 0$$ and $$c$$ is the context window size.
2. Input Word Representation: One-hot encoding and Embedding Lookup
- The input word $$w_t$$ is first represented as a one-hot vector $$x \in \mathbb{R}^{V}$$, where $$V$$ is the vocabulary size.
- This vector is multiplied by an embedding matrix $$E \in \mathbb{R}^{V \times d}$$ to retrieve the dense word vector:
$$v_{w_t} = E^\top x = E_{w_t} \in \mathbb{R}^{d}$$
- $$v_{w_t}$$ is the **embedding vector** for the input word.
3. Output Layer: Predicting context word probabilities
- The model tries to compute a score for **every word in the vocabulary** as a possible context word.
- This is done by multiplying the embedding vector with an output weight matrix $$U \in \mathbb{R}^{V \times d}$$ and applying a softmax function:
$$P(w_{context} \mid w_t) = \text{softmax}(U v_{w_t}) = \frac{\exp(U_{w}^\top v_{w_t})}{\sum_{w' \in V} \exp(U_{w'}^\top v_{w_t})}$$
- For each actual context word $$w_{t+j}$$, we maximize this probability.
4. Loss Function: Cross-entropy over context words
- The loss is the negative log-likelihood over the context window:
$$\mathcal{L} = - \sum_{-c \leq j \leq c,\; j \ne 0} \log P(w_{t+j} \mid w_t)$$
- This encourages the model to place actual context words close to the center word in vector space.
5. Optimization Tricks (for efficiency)
- In practice, computing softmax over a large vocabulary is expensive.
- Two common approximations are used:
- **Negative Sampling**: Only update a small number of negative samples + one positive
- **Hierarchical Softmax**: Replace softmax with a binary tree of decisions
6. Output: Word Embedding Matrix
- After training, the **rows of the input embedding matrix $$E$$** (or average of input and output vectors) are used as final word vectors.
- These vectors capture semantic and syntactic word relationships.
#### 5.2.4 Learning Word Embedding: GloVe

1. Motivation: Combine global co-occurrence with local context
- Word2Vec (Skip-gram) learns from local context windows.
- GloVe is designed to use **global word co-occurrence statistics** across the entire corpus.
- The key insight: **ratios of co-occurrence probabilities** capture semantic relationships.
2. Co-occurrence Matrix: $$X_{ij}$$
- Build a symmetric matrix $$X \in \mathbb{R}^{V \times V}$$ where:
- $$X_{ij}$$ = number of times word $$j$$ appears in the context of word $$i$$
- This matrix captures the **global statistical information** about the corpus.
3. Learning Objective: Weighted least squares regression
- Learn word vectors $$w_i, w_j$$ and biases $$b_i, b_j$$ for each word pair $$i, j$$
- The goal is to approximate:
$$w_i^\top \tilde{w}_j + b_i + \tilde{b}_j \approx \log(X_{ij})$$
- Where:
- $$w_i$$ is the vector for the target word
- $$\tilde{w}_j$$ is the vector for the context word
- $$X_{ij}$$ is the co-occurrence count
- $$b_i$$ and $$\tilde{b}_j$$ are scalar biases
4. Cost Function
- Use a **weighted squared error** to train only on nonzero entries of $$X_{ij}$$:
$$J = \sum_{i,j=1}^{V} f(X_{ij}) \left( w_i^\top \tilde{w}_j + b_i + \tilde{b}_j - \log(X_{ij}) \right)^2$$
- Weighting function:
$$
f(x) =
\begin{cases}
(x / x_{\text{max}})^\alpha & \text{if } x < x_{\text{max}} \\
1 & \text{otherwise}
\end{cases}
$$
- Typical values:
- $$\alpha = 0.75$$
- $$x_{\text{max}} = 100$$
5. Output Word Vectors
- Final word representation is typically:
$$\text{Embedding}(w_i) = w_i + \tilde{w}_i$$
- Combines both **target** and **context** word embeddings.
6. Key Properties
- GloVe learns vectors such that **vector differences encode meaningful relationships**, e.g.:
- $$\text{king} - \text{man} + \text{woman} \approx \text{queen}$$
- Works well for analogies and capturing **linear semantic structure**.
#### 5.2.5 Applications Using Word Embeddings
- Sentiment Classification

- Debiasing Word Embeddings
- Word embeddings can reflect gender, ethnicity, age, sexual orientation, and other biases of the text used to train the model.
Man: King as Woman: Queen
Man: Computer Programmer as Woman: Homemaker
Father: Doctor as Mother: Nurse
- Addressing bias in word embeddings:
1. Identify bias direction: average word embedding of (he, she), (male, female).
2. Neutralize: For every word that is not definitional, project to get rid of bias.
3. Equalize pairs.
### 5.3 Sequence Models & Attention Mechanism
#### 5.3.1 Sequence To Sequence Model

1. Architecture Overview
- A Seq2Seq model consists of two main components:
- **Encoder**: processes the input sequence into a fixed-length vector.
- **Decoder**: generates the output sequence based on the encoder output.
- Both are typically implemented using RNNs, LSTMs, or GRUs.
2. Encoder: Read the input sequence
For an input sequence $$x = (x_1, x_2, \dots, x_T)$$, the encoder RNN updates its hidden state at each time step:
$$h_t^{(enc)} = \text{RNN}(x_t, h_{t-1}^{(enc)})$$
- The final hidden state $$h_T^{(enc)}$$ is used to represent the entire input sequence.
- In LSTM-based encoders, both hidden state $$h_T^{(enc)}$$ and cell state $$c_T^{(enc)}$$ are passed to the decoder.
3. Decoder: Generate the output sequence
Given the target sequence $$y = (y_1, y_2, \dots, y_{T'})$$, the decoder predicts each output token one at a time:
$$h_t^{(dec)} = \text{RNN}(y_{t-1}, h_{t-1}^{(dec)})$$
- The initial hidden state $$h_0^{(dec)}$$ is set to the encoder's final state:
$$h_0^{(dec)} = h_T^{(enc)}$$
- At each time step, the decoder predicts the next word:
$$\hat{y}_t = \text{softmax}(W_{out} h_t^{(dec)} + b_{out})$$
4. Training: Teacher Forcing
- During training, the decoder receives the **true previous token** $$y_{t-1}$$ as input.
- This technique is called **teacher forcing**, and it helps the model converge faster.
5. Inference: Autoregressive Decoding
- During inference (e.g. translation), the decoder only has access to its **own previous prediction**:
Input to decoder at time t:
- Training: true y\_{t-1}
- Inference: predicted ŷ\_{t-1}
- Decoding stops when:
- An end-of-sequence token is produced, or
- A max length is reached
6. Loss Function
- Typically use cross-entropy loss over each predicted token:
$$\mathcal{L} = - \sum_{t=1}^{T'} \log P(y_t \mid y_{ Beam Search keeps track of the **top-k most likely partial sequences** at each time step, instead of just the single best one.
- The number $$k$$ is called the **beam width**.
- At each time step:
- All possible continuations of each sequence in the beam are explored.
- Only the top $$k$$ candidates (based on cumulative score) are kept.
3. Beam Search Algorithm
Suppose beam width = $$k$$.
1. **Initialization**:
- Start with the initial token (e.g., $$
$$) in the beam.
- Set initial score for all hypotheses = 0.
2. **At each decoding step**:
- For each sequence in the beam:
- Expand it by all possible next words.
- Compute the new **cumulative log-probability**:
$$\text{score} = \log P(y_1) + \log P(y_2 \mid y_1) + \dots + \log P(y_t \mid y_{$$ (end-of-sequence) token, or max length reached.
4. Normalization
- Longer sequences tend to have lower total log-probability.
- To correct this, use **length normalization**:
$$\text{normalized score} = \frac{1}{T^\alpha} \sum_{t=1}^{T} \log P(y_t \mid y_{ Count **how many n-grams in the candidate** also appear in the reference(s).
For each n-gram size (typically from 1 to 4):
1. Count all **n-grams** in candidate sentence.
2. Count **how many appear in the reference(s)**.
3. Clip the counts so repeats aren’t overcounted.
4. Modified n-gram Precision
For each $$n$$-gram size:
$$P_n = \frac{\text{\# matched n-grams}}{\text{\# candidate n-grams}}$$
- This is called **modified precision**, because we "clip" the match count to the max times it appears in any reference.
5. Brevity Penalty (BP)
> To penalize overly short outputs.
Let:
- $$c$$ = length of candidate
- $$r$$ = effective reference length (usually closest to $$c$$)
Then:
$$
BP =
\begin{cases}
1 & \text{if } c > r \\
\exp(1 - \frac{r}{c}) & \text{if } c \leq r
\end{cases}
$$
6. BLEU Score Formula
With weights $$w_n$$ for each n-gram (commonly uniform, e.g. 0.25 for n=1~4):
$$\text{BLEU} = BP \cdot \exp\left( \sum_{n=1}^{N} w_n \log P_n \right)$$
- Typically use **up to 4-grams** ($$N = 4$$).
- If any $$P_n = 0$$, the BLEU becomes 0 (use smoothing in practice).
7. Example (Simplified 2-gram BLEU)
**Reference**:
`the cat is on the mat`
**Candidate**:
`the cat the cat on the mat`
- Unigram match: 5 / 7 = 0.714
- Bigram match: 3 / 6 = 0.5
- BLEU = $$BP \cdot \sqrt{0.714 \cdot 0.5} \approx 0.597$$
8. Advantages
- Automatic, fast, widely adopted
- Works well with multiple references
- Captures **exact word-level overlap**
9. Limitations
| Limitation | Description |
| ------------------------------ | -------------------------------------------------------- |
| Surface-level | Doesn't consider synonyms or paraphrasing |
| Penalizes diversity | Model using same phrases may get higher score |
| Word order strictness | Minor reorderings can lower score a lot |
| Better for machine translation | Less effective for open-ended generation (like chatbots) |
10. Tips
- BLEU is better with **multiple references**
- Apply **smoothing** (e.g. `BLEU+1`) for short sentences
- Combine with other metrics like ROUGE, METEOR, BERTScore for better evaluation
#### 5.3.4 Attention Model

1. Motivation: Why Attention?
- In standard Seq2Seq models, the encoder compresses the entire input sequence into a **fixed-length vector**.
- This creates a bottleneck, especially for long sequences, because the decoder has limited access to detailed information.
- **Attention allows the decoder to “look back” at all encoder hidden states**, dynamically focusing on the most relevant parts of the input.
2. Encoder Hidden States
- The encoder processes an input sequence $$x = (x_1, x_2, \dots, x_T)$$
- At each time step, it produces a hidden state:
$$h_t^{(enc)} = \text{EncoderRNN}(x_t, h_{t-1}^{(enc)})$$
- These hidden states are collected into a sequence:
$$H = [h_1^{(enc)}, h_2^{(enc)}, \dots, h_T^{(enc)}]$$
3. Decoder Hidden State
- At decoding step $$t$$, the decoder has a current hidden state $$s_t$$:
$$s_t = \text{DecoderRNN}(y_{t-1}, s_{t-1}, c_{t})$$
- Note: the decoder will compute a **context vector** $$c_t$$ using attention over the encoder outputs.

4. Attention Weights: $$\alpha_{t,i}$$
- For each encoder hidden state $$h_i$$, compute a **relevance score** with respect to the decoder state $$s_t$$:
$$e_{t,i} = \text{score}(s_t, h_i)$$
- Common scoring functions:
- Dot product: $$e_{t,i} = s_t^\top h_i$$
- Additive (Bahdanau): $$e_{t,i} = v_a^\top \tanh(W_s s_t + W_h h_i)$$
- Scaled dot (Transformer): $$e_{t,i} = \frac{s_t^\top h_i}{\sqrt{d}}$$
- Convert scores into attention weights using softmax:
$$\alpha_{t,i} = \frac{\exp(e_{t,i})}{\sum_{j=1}^{T} \exp(e_{t,j})}$$
5. Context Vector: $$c_t$$
- The context vector is a **weighted sum of encoder hidden states**:
$$c_t = \sum_{i=1}^{T} \alpha_{t,i} \cdot h_i$$
- It represents what the decoder “attends to” when generating the next token.
6. Final Decoder Output
- The context vector $$c_t$$ is combined with the decoder state $$s_t$$ to generate the output:
$$\tilde{s}_t = \tanh(W_c [c_t ; s_t])$$
$$\hat{y}_t = \text{softmax}(W_o \tilde{s}_t + b_o)$$
- The output is a probability distribution over the vocabulary.
7. Summary of Steps at Time Step $$t$$
1. Compute attention scores $$e_{t,i}$$ between $$s_t$$ and each $$h_i$$
2. Normalize to get weights $$\alpha_{t,i}$$
3. Compute context vector $$c_t$$ as weighted sum
4. Combine $$c_t$$ and $$s_t$$ to predict output $$\hat{y}_t$$
8. Benefits of Attention
- Removes fixed-length bottleneck
- Improves translation quality, especially for long inputs
- Offers **interpretability**: shows which parts of input are attended to
9. Variants
- Bahdanau Attention (additive)

- Luong Attention (multiplicative / dot-product)

- Multi-head Attention (in Transformers)
#### 5.3.5 Attentio Model Equations

1. Encoder: Process input sequence $$x = (x_1, ..., x_T)$$
At each time step $$t$$:
$$
h_t^{(enc)} = \text{RNN}_{enc}(x_t, h_{t-1}^{(enc)})
$$
- $$h_t^{(enc)}$$: the encoder's hidden state at time $$t$$
- Final encoder output: sequence of hidden states
$$
H = [h_1^{(enc)}, h_2^{(enc)}, ..., h_T^{(enc)}]
$$
2. Decoder Initialization
At decoding time step $$t$$:
- $$s_t$$: decoder hidden state at time step $$t$$
- Initial decoder state $$s_0$$ is usually set as:
$$
s_0 = \tanh(W_{init} h_T^{(enc)})
$$
(Or simply $$s_0 = h_T^{(enc)}$$)
3. Alignment score $$e_{t,i}$$
Compute how much attention the decoder should pay to each encoder state $$h_i$$:
$$
e_{t,i} = v_a^\top \tanh(W_s s_{t-1} + W_h h_i)
$$
- $$s_{t-1}$$: decoder’s previous hidden state
- $$h_i$$: encoder hidden state at position $$i$$
- $$W_s, W_h, v_a$$: trainable weight matrices/vectors
4. Attention weights $$\alpha_{t,i}$$
Normalize the scores using softmax:
$$
\alpha_{t,i} = \frac{\exp(e_{t,i})}{\sum_{j=1}^{T} \exp(e_{t,j})}
$$
- $$\alpha_{t,i}$$ is the attention given to encoder step $$i$$ at decoder step $$t$$
5. Context vector $$c_t$$
Use the attention weights to compute a **weighted sum** over all encoder hidden states:
$$
c_t = \sum_{i=1}^{T} \alpha_{t,i} \cdot h_i
$$
- $$c_t$$ is the attention-based summary of input relevant to the current decoding step
6. Decoder hidden state $$s_t$$
Update the decoder's RNN using previous output and the current context:
$$
s_t = \text{RNN}( [y_{t-1} ; c_t],\; s_{t-1} )
$$
7. Output prediction $$\hat{y}_t$$
Use $$s_t$$ and $$c_t$$ to generate a prediction for the next word:
$$
\tilde{s}_t = \tanh(W_c [s_t ; c_t])
$$
$$
\hat{y}_t = \text{softmax}(W_o \tilde{s}_t + b_o)
$$
- $$\hat{y}_t$$: probability distribution over vocabulary
8. Overall Summary of Bahdanau Attention Steps
At each decoder time step $$t$$:
1. Compute alignment scores for all encoder states:
$$
e_{t,i} = v_a^\top \tanh(W_s s_{t-1} + W_h h_i)
$$
2. Normalize to get attention weights:
$$
\alpha_{t,i} = \text{softmax}(e_{t,i})
$$
3. Compute context vector:
$$
c_t = \sum \alpha_{t,i} \cdot h_i
$$
4. Update decoder hidden state:
$$
s_t = \text{RNN}(y_{t-1}, s_{t-1}, c_t)
$$
5. Generate next word distribution:
$$
\hat{y}_t = \text{softmax}(W_o \tanh(W_c [s_t ; c_t]) + b_o)
$$
### 5.4 Transformer Network
#### 5.4.1 Self-Attention

1. Motivation: Why Self-Attention?
- In regular attention, the decoder attends to the encoder outputs.
- In **Self-Attention**, each word in a sequence attends to **other words in the same sequence**.
- This allows the model to capture dependencies between all tokens — no matter how far apart.
2. Inputs: Embedding Matrix $$X$$
- Input is a sequence of token embeddings:
$$
X = [x_1, x_2, \dots, x_n]^\top \in \mathbb{R}^{n \times d}
$$
- Each $$x_i$$ is a $$d$$-dimensional vector, $$n$$ is sequence length.
3. Linear Projections: Queries, Keys, and Values

- Compute three matrices from $$X$$ using learnable weights:
$$
Q = X W^Q, \quad K = X W^K, \quad V = X W^V
$$
- Dimensions:
- $$W^Q, W^K, W^V \in \mathbb{R}^{d \times d_k}$$
- $$Q, K, V \in \mathbb{R}^{n \times d_k}$$
4. Scaled Dot-Product Attention

- For each token, compute attention score between its **query** and all **keys**:
$$
\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{Q K^\top}{\sqrt{d_k}} \right) V
$$
- The matrix multiplication $$Q K^\top$$ gives a $$n \times n$$ attention matrix.
- The softmax ensures that attention weights over all positions sum to 1.
- Then multiply by $$V$$ to get the weighted sum of value vectors.
5. Output of Self-Attention
- The final output is a new matrix:
$$
Z = \text{Attention}(Q, K, V)
$$
- Each row $$z_i$$ is a new representation of token $$x_i$$, enriched with contextual information from all other tokens.
#### 5.4.2 Multi-Head Attention

1. Motivation: Why Multiple Heads?
- A single self-attention head can only capture **one type of similarity** or relationship at a time.
- **Multi-Head Attention** allows the model to attend to information **from different representation subspaces** and at different positions in parallel.
2. Input: Embedding Matrix $$X \in \mathbb{R}^{n \times d}$$
- $$n$$ = sequence length, $$d$$ = embedding dimension.
- From input $$X$$, we will create multiple independent **query, key, value** projections.
3. Linear Projections for Each Head
For each of the $$h$$ attention heads, project input into:
$$
Q_i = X W_i^Q, \quad K_i = X W_i^K, \quad V_i = X W_i^V
$$
- Where:
- $$W_i^Q, W_i^K, W_i^V \in \mathbb{R}^{d \times d_k}$$
- Typically, $$d_k = d / h$$ so that concatenated heads still match original dimensionality.
4. Scaled Dot-Product Attention (per head)
Each head computes:
$$
\text{head}_i = \text{Attention}(Q_i, K_i, V_i) = \text{softmax} \left( \frac{Q_i K_i^\top}{\sqrt{d_k}} \right) V_i
$$
- Resulting shape: $$\text{head}_i \in \mathbb{R}^{n \times d_k}$$
5. Concatenation of All Heads
- All heads are concatenated along the feature dimension:
$$
\text{MultiHead}(X) = [\text{head}_1; \text{head}_2; \dots; \text{head}_h] W^O
$$
- Where:
- $$[\,\cdot\,]$$ means concatenation along last dimension
- $$W^O \in \mathbb{R}^{d \times d}$$ is a learnable projection matrix to map back to original dimension
6. Summary of Complete Flow
Input X ∈ ℝⁿˣᵈ
↓
Project to h different Q, K, V sets (each with dimension d_k = d/h)
↓
Apply scaled dot-product attention for each head
↓
Concatenate all head outputs → [head₁; head₂; ...; headₕ] ∈ ℝⁿˣᵈ
↓
Final linear layer: project to output dimension d
#### 5.4.3 Transformer Network


> Transformer = Stacked Self-Attention + Feedforward + Residual + LayerNorm
1. Motivation: Why Transformer?
- RNNs suffer from **sequential bottlenecks** and **long-term dependency issues**.
- Transformer replaces recurrence entirely with **self-attention + feed-forward layers**, enabling:
- Full parallelization
- Long-range dependency modeling
- Simpler architecture
2. Overall Structure
Transformer follows an **encoder-decoder** structure:
```plaintext
Input → [Positional Encoding + Embedding] → Encoder → → → Context Vectors
↓
Decoder ← ← ← ← ← ← ← Output Sequence
```
Each encoder/decoder is made up of **multiple stacked identical blocks** (usually 6 or 12).
- Feed Forward Network (FFN)

- Residual Connections + Layer Norm


3. Encoder Block (each of N layers)
Each encoder layer consists of:
1. **Multi-Head Self-Attention**
2. **Feed-Forward Network (FFN)**
3. **Residual Connections + LayerNorm**
Computation flow:
```plaintext
Input → Multi-Head Self-Attention → Add & Norm → FFN → Add & Norm → Output
```
4. Decoder Block (each of N layers)
Each decoder layer consists of:
1. **Masked Multi-Head Self-Attention** (prevents attending to future tokens)
2. **Encoder-Decoder Attention** (attend over encoder outputs)
3. **Feed-Forward Network (FFN)**
4. **Residual Connections + LayerNorm**
Computation flow:
```plaintext
Target Input → Masked MHA → Add & Norm → MHA (Encoder Attention) → Add & Norm → FFN → Add & Norm → Output
```
5. Positional Encoding

Since Transformers lack recurrence, we inject **position information**:
$$
PE_{(pos, 2i)} = \sin \left( \frac{pos}{10000^{2i / d}} \right),
$$
$$
PE_{(pos, 2i+1)} = \cos \left( \frac{pos}{10000^{2i / d}} \right)
$$
- This allows the model to distinguish token order.
6. Multi-Head Attention (recap)
For input matrix $$X$$:
- Compute:
$$
Q = X W^Q, \quad K = X W^K, \quad V = X W^V
$$
- Attention per head:
$$
\text{Attention}(Q, K, V) = \text{softmax} \left( \frac{Q K^\top}{\sqrt{d_k}} \right) V
$$
- Multi-head output:
$$
\text{Concat}(\text{head}_1, ..., \text{head}_h) W^O
$$
7. Feed-Forward Network (FFN)
Each position passes through the same two-layer MLP:
$$
\text{FFN}(x) = \max(0, x W_1 + b_1) W_2 + b_2
$$
- Typically $$W_1 \in \mathbb{R}^{d \times d_{ff}}$$ where $$d_{ff} \gg d$$ (e.g., 2048 vs 512)
8. Masking
- **Padding Mask**: prevent attention to padding tokens.
- **Look-ahead Mask (causal mask)**: ensure decoder can't peek at future tokens during training.
9. Output Layer
- Decoder output is passed to a **linear layer + softmax** to predict the next token:
$$
\hat{y}_t = \text{softmax}(W_o z_t + b_o)
$$
---
https://zla.pub/python-cipher-reverse-string
---
#Python简单加密器-反转字符串
## 什么是反转字符串
反转字符串其实就是把一个string类型的字符串变量进行从头到尾的一个反转,比如'hello!'经过反转后我们就可以得到'!olleh'。如果只想看代码可以直接翻到[**2.5**](#反转字符串的最终实现)看代码段即可
## 如何实现反转字符串
实际上我们在实现这个加密器的时候首先要考虑的是如何利用字符串本身的一些特性去实现这个功能,从而使用最简单的代码达到最佳的效果。
### 字符串的基本特性
我们的String本质上就是一个类似列表(List)的存在。我们看下面的图,假设我们有一个String类型的变量为`test = "screen"`,我们可以通过下图的方式对它进行索引。每一个单独的字母就是这个"列表"里的一个单独的元素。我们可以使用如`test[0]`的方式来获取元素's',也可以通过如`test[0:2]`的方式来获取元素'sc',此处\[0:2]对应的是一个\[0,2)左闭右开的区间。那大家可能就想到了列表是可以反转(reverse)的,那么我们这个所谓的'列表'可不可以做同样的操作呢?答案是不行,String变量并没有reverse函数,所以我们就需要先讲字符串转换为真正的列表才可以进行反转。

### 字符串转列表
字符串转换为列表其实本质上非常简单。一般来说我们把数据转换为列表对象有两种方式,第一种方式是通过`split()`函数进行String对象的切分,第二种方式是通过`list()`函数直接将String对象强制类型转换为列表(List)类型的变量。在这里我们直接使用`list()`函数将String变量转换为列表对象即可。
```python
test = 'screen'
test_list = list(test) # test_list = ['s', 'c', 'r', 'e', 'e', 'n']
```
### 列表的反转
在我们将String转换为列表后,我们就要开始反转了。列表的反转非常地简单,直接对list类型的变量使用`.reverse()`函数进行列表的反转即可。
```python
test_list.reverse() # test_list = ['n', 'e', 'e', 'r', 'c', 's']
```
### 列表转字符串
反转完成后我们就需要把列表重新转换为字符串String类型的对象了。将list转换为String实际上非常简单,只需要使用`''.join()`在引号中间就是用什么元素把你的list中的每一个元素连接起来形成一个String。举个?,如果你在引号间用的是`','`,那么你最后列表就会通过,连接起来。
```python
reverse_test = ''.join(test_list) # reverse_test = 'neercs'
```
### 反转字符串的最终实现
这里我们就把所有的代码合起来,假设我们有一个变量`cipher = "hello!"`,我们要得到它反转后的String字符串。
```python
def cipher_reverse_string(cipher: str) -> str:
cipher_list = list(cipher)
cipher_list.reverse()
result = ''.join(cipher_list)
return result
if __name__ == '__main__':
print(cipher_reverse_string("hello!"))
```
## 总结
我们这里使用了Python中String和List的一些小特性和方法实现了一个非常简单的加密器~~(完全没加密的加密器)~~,使用到了String和List的互相转换、list的反转。本质上来说是一个非常简单的小程序,只需要理解其中的逻辑即可。
---
https://zla.pub/numpy-only-confusion-matrix
---
#仅使用numpy实现混淆矩阵计算(不使用sklearn)
## 什么是混淆矩阵(confusion matrix)
当我们拿到数据后,经过数据清洗、预处理和整理之后,我们做的第一步是利用这些数据训练出一个模型。我们究竟如何衡量模型的准确度和有效性?性能和效率又如何?这就是混淆矩阵被用来解决的问题。混淆矩阵是机器学习分类的性能的一种方式。
## 混淆矩阵有什么用
我们可以使用这个矩阵直观地看到每个数据的真实值和我们模型的预测值的关系。
## 如何实现
### 使用sklearn.metrics的confusion_matrix
本方法使用了`sklearn.metrics`下的`confusion_matrix`函数直接进行生成
```python
from sklearn.metrics import confusion_matrix
y_true = [2, 0, 2, 2, 0, 1]
y_pred = [0, 0, 2, 2, 0, 2]
confusion_matrix(y_true, y_pred)
```
### 仅使用numpy
本方法仅使用了numpy,没有使用任何其他的库,包括`sklearn`在内实现混淆矩阵的计算。
```python
import numpy as np
def compute_confusion_matrix(true, pred):
'''输入true和pred
其输出结果与以下内容相同(计算时间也相似)。
"from sklearn.metrics import confusion_matrix"
然而,这个函数避免了对sklearn的依赖。'''
K = len(np.unique(true)) # features的数量
result = np.zeros((K, K))
for i in range(len(true)):
result[true[i]][pred[i]] += 1
return result
```
> 来源:https://stackoverflow.com/a/48087308/20626353
---
https://zla.pub/cpp-round
---
#C++进行特定位数的四舍五入/向上取整/向下取整/截断
## C++的四舍五入/向上取整/向下取整/截断
我们在C++中有时会需要使用到数学运算,同样的可能会使用到标题提到的几种方式进行运算。实际上C++有一个库``可以直接实现这些方法操作。
```cpp
#include
int main()
{
double a = 43.5555;
// 四舍五入
a = std::round(a);
std::cout << a << std::endl; // 44.0000
// 向下取整
a = std::floor(a);
std::cout << a << std::endl; // 43.0000
// 向上取整
a = std::ceil(a);
std::cout << a << std::endl; // 44.0000
// 截断
a = std::trunc(a);
std::cout << a << std::endl; // 43.0000
return 0;
}
```
那么这就是最简单的四种算法在C++中的使用了。
## C++中获取特定位数的方法
那么有时候我们进行这样的数学运算后,目的就是为了得到一个更方便看的数,那当然要取特定位数的小数了。写法规则如下(以四舍五入方法`std::round`做演示)。
```cpp
a = std::round(a * 保留到几分位) / 保留到几分位; // 保留到十分位 = 保留两位小数
```
我们来一个保存两位小数(十分位)的实例来看一下。
```cpp
#include
#include
int main()
{
double a = 43.5555;
a = std::round(a * 10) / 10;
std::cout << a << std::endl;
return 0;
}
```
那么这样就可以非常轻松的在C++中获取到我们需要的小数位数了。
## C++中对定位数的double进行输出的方法
我们上面说到了如何获取到特定的位数,但是这样获取到的还是double值,如果想要和std::string一起操作是会出现问题的。如果我们想要把这个double和其他的string放到一起的话,我们就需要按照如下代码进行操作。
```cpp
#include
#include
#include
int main()
{
double a = 43.5555;
a = std::round(a * 10) / 10;
// 先转换为std::string类型
std::string tempre = std::to_string(a);
// 对std::string类型进行10位小数的格式化(下面语句会输出10位小数)
std::cout << tempre.substr(0, tempre.find(".") + 2) << std::endl;
return 0;
}
```
这就是本文的全部内容了。
---
https://zla.pub/western-union-20-amazon-gc
---
#西联汇款Western Union薅羊毛-向国内转账100刀即可送 $20亚马逊GC(0成本0手续费)
## 西联汇款介绍(Western Union)
西联汇款(Western Union, NYSE:WU)于1851年在纽约成立,現在總部在美國科羅拉多州丹佛市(Denver)。是世界上领先的特快汇款公司,迄今已有150年的历史,它拥有全球最大最先进的电子汇兑金融网络,代理网点遍布全球近200个国家和地区。 西联公司是美国财富五百强之一的第一数据公司(FDC)的子公司。
## 薅羊毛
> 一定要使用下面的链接进行操作,不要自行去西联注册,否则你讲薅不到羊毛!!!
> 你需要有美国开户的借记卡账户/且之前没有注册过西联
1.首先点击[这个链接](https://ssqt.co/mQnVR20),你会显示下面这个页面,点击I Accept,填写你的个人信息及邮箱注册。

2.然后你的邮箱会收到验证码,像这样,把它填过去。

3.下一步便是汇款回国内了,那么我们所说的0手续费的方式是美国这边的账户直接转到国内的支付宝里,目前我测试的都是实时到账,登陆你的BOA、chase、Discover等主流银行的onlinebanking,就可以直接选择使用checking account或者saving account付款了,支付宝收钱是0手续费的。
4.首先我们选择地区为中国(China).

5.然后我们输入金额(需要大于等于100刀),这里它会显示西联的汇率,那么这个价格基本上就是银行钞买价略高一点,比我们直接用谷歌看到的实时汇率略低一些,比如本篇文章撰写的时候谷歌显示汇率为6.39(6.3315/6.39 = 基本上就是一个99折,损失1刀的汇率差价)。
我们还需要选择收款方式为Alipay(支付宝),付款方式选择Bank Account(银行账户),这样我们才能够0手续费。

6.下一步就可以填写收款人信息啦,填写的时候注意一定要详细填写,比如收款人叫做张三,我们就在last name填写ZHANG,first name填写SAN,地址填写你自己国内住址即可,手机号也填国内的就可以。注意支付宝的钱包手机号就是你支付宝绑定的手机号,一定要正确填写!!!转款目的选择生活费就好,不要选择工资,防止被风控。

7.然后就是登陆你的网银确认账单付钱就可以了,过程非常的简单
8.付款完成后大多数人会秒到账,如下图所示,如果你没有用过支付宝官方的闪速收款第一次可能会放在支付宝里然后你会收到短信,设置收款账户就会自动汇入你的银行卡里了。当然还有一种情况是你的付款被refused了,不需要担心,即使refused你还是能够拿到20刀的礼品卡,稍等一会如果确认没有礼品卡再重新转账也不迟。

9.大约付款完10分钟左右,你的邮箱就会收到西联发给你的礼品卡兑换码了,自己兑换使用就可以了。

## 总结
这次薅羊毛的流程非常的简单,基本只需要2-3min的操作就可以获得20刀的amazon GC,大家没有使用过西联汇款的豆可以操作一下。注意一定要使用我放在这里的链接进行注册,否则你不仅不会获得这20刀的羊毛,以后的新用户注册活动也和你无关了。
[西联汇款羊毛链接(注册后汇款100刀即可获得20刀GC)](https://ssqt.co/mQnVR20)
---
https://zla.pub/cpp-2d-dynamical-array
---
#C++实现动态二维数组的两种简易方法
## C++的动态数组(Dynamically-allocated Single-Dimension arrays)
当无法使用静态分配的数组时 — 因为你在编译时不知道合适的大小,或该数组太大而无法合理地放入运行时堆栈,或该数组的生命周期比创建它的函数更长。动态分配数组涉及到使用new运算符,类似于其他对象的动态分配,不同之处在于数组需要我们另外指定大小。
动态分配数组是使用new表达式完成的,该表达式会动态分配足够的内存来存储整个数组,然后返回指向数组第一个单元格的指针。
```cpp
int* a = new int[10];
```
表达式 **new int[10]** 在堆上分配一个足够大的内存块来存储 10 个整数,并返回一个指向第一个的指针。第二个的位置直接跟在第一个之后,第三个直接跟在第二个之后,依此类推,所有的单元格都是相同的类型。所以给定一个指向第一个单元格的指针和一个索引,在幕后,可以使用以下计算来计算任何给定单元格的索引:
```cpp
单元格 i 的地址 = (单元格 0 的地址) + (sizeof(int) * i)
```
注意,计算具有大索引的单元格的地址并不比使用小索引更消耗性能。这个计算只是一个乘法和加法;如果我们假设给定地址的内存访问需要恒定时间,那么访问数组中的任何单元都需要恒定时间。(在实践中,内存访问时间可能会因缓存等影响而有所不同,尽管你可以合理地认为主内存访问花费恒定时间。)
有趣的是,返回的指针类型并未指定有关数组的任何内容。当我们动态分配一个int数组时,我们得到的是一个int*,即一个指向int的指针。数组在一般情况下,实现为指针,以他们的第一个单元,它是由我们来了解是否特定int*指向一个单一的int或int数组。
一旦有了指向数组的指针,就可以像访问静态分配的数组一样访问它的每一个数字:
```cpp
int* a = new int[10];
a[3] = 4;
std::cout << a[3] << std::endl;
```
a[3]相当于假想表达\*q,其中q是一个指向int占用三个单位的一个点。换句话说,a[3]给你提供的是这个单元格中的int(从理论上讲,是对它的引用),而不是指向这个单元格的指针。
当完成动态分配的数组时,需要释放它,就像您处理任何其他动态分配的对象一样。但是,重要的是要注意你要使用不同的运算符delete[]来执行此操作。像delete一样,你给delete[]一个指向数组的指针,它会为你释放整个数组(以及它所有单元格中的所有对象)。
```cpp
delete[] a;
```
由你决定哪些指针指向数组,并在需要时使用delete[]。在指向数组的指针上使用delete而不是delete[ ],或在指向单个值的指针上使用delete[]而不是delete,会导致“undefined behavior”。就像我们之前看到的使用delete一样,指针a不受影响,尽管它现在指向未分配的内存,因此它现在就不会被再使用。
## C++动态分配二维数组-使用常规方式(即不使用除iostream外的内置库)
动态二维数组的分配
```cpp
int** test = new int*[rows];
for(int i = 0; i < rows; i++)
test[i] = new int[columns];
```
释放动态分配二维数组占用的空间
```cpp
for(int i = 0; i < rows; i++)
delete []test[i];
delete []test;
```
## C++动态分配二维数组-使用Vector(需要额外的库vector)
注意使用这种方法你需要在文件头
```cpp
#include
```
使用vector动态分配二维数组
```cpp
std::vector> test(rows);
for (i = 0; i < test.size(); i++)
test[i].resize(columns);
```
使用swap()方法清空vector占用的内存空间
```cpp
// vector的clear方法无法清空其占用的内存
//可以使用swap来使一个空的vector来替换掉原来test里有的内容。
vector().swap(test);
```
---
https://zla.pub/java-get-date-after-several-work-day
---
#Java判断一个日期几个工作日后的日期(忽略节假日)
## 前言
前几天写作业的时候碰到一道题目,题目大意如下
> 不同的物品配送速度不同,常规商品需要5个工作日,食品需要1个工作日,数码产品立即送达(通过邮箱)。根据用户的下单日期和类别判断哪天能送到(忽略节假日)。
在网上搜了一圈发现基本上都是使用的各种非常复杂的方式并且有各种兼容性问题,基本上使用的都是数组 + Calendar 的形式来写的。这里根据教授的提示了解到了一种非常方便的形式来解决这个问题。
## 思路
### 题目分解
首先我们需要判断是什么类型的产品,然后再根据产品对日期进行处理并切返回给用户。
### 日期格式
这道题目是用的格式为yyyy-mm-dd,所以这道题我们也需要根据这个方式来写。
## 方法
根据教授的提示Java有一个非常适合解决这个问题的类 **_java.time.LocalDate_** 这里是官方文档[https://docs.oracle.com/javase/8/docs/api/java/time/LocalDate.html](https://docs.oracle.com/javase/8/docs/api/java/time/LocalDate.html) 有兴趣的可以自行查看。根据文档我们可以获得几个方法来帮我们解决问题。
**LocalDate**
```java
LocalDate a = LocalDate.of(2012, 6, 30);
// 这里就是把2021.6.30转换到了java.time可以识别的日期格式LocalDate。
```
**plusDays**
```java
a = a.plusDays(1);
// 此处的a就会变成2021.7.1,日期会自动更新到下一个月。
```
**getDayOfWeek**
```java
a.getDayOfWeek();
// 这里可以获取到a的日期对应的是星期几。该方法返回是周中哪天的枚举DayOfWeek。这就避免了对int值含义的混淆。如果你需要访问原始的int值,那么枚举提供了int值。
// 比如这里是2021.7.1,也就是星期四。
```
## 代码
下面是我们正式实现功能的函数
```java
public String purchase(String purchaseDate) {
// 以食品类举例,配送时间为一个工作日,purchaseDate是String类别以格式为YYYY-MM-DD的日期。
String[] strOfdate = purchaseDate.split("-", 3);
// 以-分割用户输入的字符串保存到名为strOfdate的字符串数组中
LocalDate finaldate = LocalDate.of(Integer.parseInt(strOfdate[0]), Integer.parseInt(strOfdate[1]), Integer.parseInt(strOfdate[2]));
// 设定一个LocalDate变量,变量名为finaldate,将分割好的日期赋值给它
int daycalc = 0;
do {
finaldate = finaldate.plusDays(1);
// 把用户输入的日期加一天
if ((finaldate.getDayOfWeek() != DayOfWeek.SATURDAY &&
finaldate.getDayOfWeek() != DayOfWeek.SUNDAY)) {
// 判断加了一天以后是否是周六或者周日,如果是就继续循环
++daycalc;
// 如果不是就把daycalc参数加一,计作一个工作日。
}
}while (daycalc < 1);
// 当工作日等于1的时候停止循环
return finaldate.toString();
// 将日期转换为String类型返回给用户
}
```
如果有任何问题欢迎在下面留言,转载文章请保留本文链接及我的ID
ZL Asica
---
https://zla.pub/ffmpeg
---
#FFmpeg的安装与基础使用教程
## 介绍
FFmpeg 是一个开放源代码的自由软件,可以运行音频和视频多种格式的录影、转换、流功能,包含了 libavcodec ——这是一个用于多个项目中音频和视频的解码器库,以及 libavformat ——一个音频与视频格式转换库。 “FFmpeg”这个单词中的“FF”指的是“Fast Forward”。
## 安装
本文只单独介绍如何在Windows和macOS下安装FFmpeg,暂不讨论在Linux下的情况。
FFmpeg的官网为[https://ffmpeg.org/download.html](https://ffmpeg.org/download.html 'FFmpeg官网下载')
### Windows
1. 首先打开上面的官网下载链接,找到Windows模块下的 **Windows builds by BtbN**

2. 在新打开的 GitHub Release 的页面中看 Assets 部分,这里面倒数第三个 **ffmpeg-master-latest-win64-gpl-shared.zip** (如红箭头所示)的链接直接点击下载FFmpeg的最新版压缩包。

3. 下载下来的压缩包先**解压**,然后将解压后的文件夹放至你不会随意删掉或改动为止的路径下(如C盘的Program Files但不是必须放到C盘)。
4. 复制ffmpeg解压后文件夹内的**bin文件夹路径**(如下图所示)
5. 打开 **设置-系统-关于-高级系统设置**
6. 打开高级系统设置后点开 **环境变量** ,找到系统变量中的 **Path变量** 双击点开。
7. 新打开的页面点击右边的 **新建** ,粘贴进去在第四步复制的bin文件夹链接
8. 添加完后一步一步确定-确定-确定。
9. win+R,输入cmd,回车,打开cmd
10. 输入FFmpeg并回车测试是否安装成功,显示类似下图即为安装成功
### macOS
1. Command + 空格 打开聚焦搜索(Spotlight),输入 Terminal 并回车打开终端
2. 如果你还没有安装过 Homebrew 的话,输入下述命令安装
```bash
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/master/install.sh)"
```
Homebrew 安装过程中会需要 root 权限(管理员权限),届时需要输入你的系统密码,输入时不会显示你输入的内容,输入完成回车即可
3. Homebrew 安装完成后输入下述命令安装 ffmpeg
```bash
brew install ffmpeg
```
4. 安装完成后输入ffmpeg测试是否安装成功,显示类似下图即为安装成功
### Linux
对于 Ubuntu/Debian 系统可以使用下述命令安装
```bash
sudo apt update
sudo apt install ffmpeg
```
对于 RedHat/CentOS 系统可以使用下述命令安装
```bash
sudo yum install epel-release
sudo yum install ffmpeg
```
对于 Arch Linux 系统可以使用下述命令安装
```bash
sudo pacman -S ffmpeg
```
## 基础使用
### 格式转换
FFmpeg转换格式最简单最常用的命令如下(请注意视频名称内若有空格请用英文状态下的**""**将其括起来,若视频名称里本来就有"则要使用英文状态下的**''**将其括起来):
```bash
ffmpeg -i input.xxx output.xxx
```
例如我们有原视频a.mov想要转成mp4格式并更改文件名为b我们可以使用如下命令
```bash
ffmpeg -i a.mov b.mp4
```
mkv解封,直接复制音频与视频流到mp4中进行重新封装(此方式适用于flv格式,例如B站下下来的),由于不需要重新编码,此代码的转换速度取决于你电脑的硬盘速度。
```bash
ffmpeg -i a.mkv -vcodec copy -acodec copy b.mp4
```
### 视频压缩
FFmpeg压缩视频应使用类似如下格式的命令:
```bash
ffmpeg -i input.mp4 -r 10 -b:a 32k output.mp4 #对它降低fps和音频码率的方法大大压缩文件大小,而清晰度不变。
#或者
ffmpeg -i input.mp4 -vcodec libx264 -crf 22 output.mp4 #将原视频转换成H.264格式并压缩,只压缩码率,其他不变
#再或者
ffmpeg -i input.webm -vcodec libx264 -crf 20 -acodec aac output.mp4 #将YouTube vp9编码转换为h264编码
```
命令选项介绍
-r 码率
-b:a 音频码率
-vcodec 视频编码
-crf 控制不变码率(量化比例的范围为0 ~ 51,其中0为无损模式,23为缺省值,51可能是最差的,推荐日常使用18-22。)
-acodec 音频编码
如果想要在转码压制视频时保持音频不对音频进行处理请在命令行里加入下述命令直接复制音频流到新的视频里可保存原视频同等的音频流。
```bash
-acodec copy
```
### 转换视频到gif
FFmpeg转换视频到gif可使用下述命令
```bash
#把视频的前 30 帧转换成一个 Gif
ffmpeg -i in.mp4 -vframes 30 -f gif out.gif
#将视频转成 gif 将输入的文件从 (-ss) 设定的时间开始以 10 帧频率,输出到 320x240 大小的 gif 中,时间长度为 -t 设定的参数。
ffmpeg -ss 00:00:00.000 -i in.mp4 -pix_fmt rgb24 -r 10 -s 320x240 -t 00:00:10.000 out.gif
```
## 进阶使用
### 音视频编码转换
-vcodec 可以用来选择你索要使用的编码器(如h264/hevc/mpeg4),例如:
```bash
ffmpeg -i in.mp4 -vcodec h264 out.mp4
ffmpeg -i in.mp4 -vcodec hevc out.mp4
ffmpeg -i in.mp4 -vcodec mpeg4 out.mp4
```
额外的选项:-s 指定分辨率,-b 指定比特率,-r 指定帧率,-acodec 指定音频编码,-ab 指定音频比特率,-ac 指定声道数,例如:
```bash
ffmpeg -i in.mp4 -s 1920x1080 -b 200k -vcodec h264 -r 60 -acodec libfaac -ab 48k -ac 2 out.mp4
```
转换封装保留编码和其他选项(如mkv或flv解封装后重新封装为mp4),例如:
```bash
ffmpeg -i in.mkv -vcodec copy -acodec copy out.mp4
ffmpeg -i in.flv -vcodec copy -acodec copy out.mp4
```
### 合并视频
我们经常会需要将两个视频合并到一起,可以使用以下命令进行合并:
1. 对于 .ts 格式的视频文件,可以使用以下命令:
```bash
ffmpeg -i "concat:1.ts|2.ts" -acodec copy -vcodec copy -absf aac_adtstoasc output.mp4
```
2. 对于 .mp4(或其他)格式的视频文件,麻烦一些,遵循下述步骤:
1. 首先创建一个文本文件,命名为**filelist.txt**,内容如下:
```txt
file '1.mp4'
file '2.mp4'
```
2. 然后使用以下命令进行合并:
```bash
ffmpeg -f concat -safe 0 -i filelist.txt -c copy output.mp4
```
### 更改视频分辨率或比例
视频分辨率可以使用-s来指定,视频比例可以使用-aspect来指定,例如:
```bash
ffmpeg -i input.mp4 -s 1280x720 -acodec copy output.mp4
ffmpeg -i input.mp4 -aspect 16:9 output.mp4
```
### 剪辑视频和裁剪视频画面
一些基础的剪辑视频和画面裁剪也可以通过FFmpeg实现
-ss表示开始的时间,-t表示时间的长度 例如:
```bash
#从30s开始截取10秒的视频并封装进h264,aac编码的out.mp4里
ffmpeg -i in.mp4 -ss 00:00:30 -t 00:00:10 -acodec aac -vcodec h264 out.mp4
#将1920x1080的视频截取中间的1080x1080部分,crop的参数选择为width:height:x:y,width:height为裁剪后的视频分辨率,x:y为裁剪出来的左上角的点的坐标,故本视频需要为x轴(1920-1080)/2=420,y轴不变故用0占位。
ffmpeg -i in.mp4 -vf crop=1080:1080:420:0 -acodec aac out.mp4
```
### 提取(去除)视频中的视频(或音频)
-an 为去除音频,-vn 为去除视频,例如:
```bash
#去除视频中的音频(提取视频)
ffmpeg -i in.mp4 -vcodec copy -an out.mp4
#去除视频中的视频(提取音频)
ffmpeg -i in.mp4 -acodec copy -vn out.mp4
```
### 合并音视频
本操作等同于将纯视频(无音频)的视频里的视频流和单独的音频文件里的音频流进行合并,例如:
```bash
ffmpeg –i in.mp4 –i in.mp3 –vcodec copy –acodec copy out.mp4
```
### 旋转视频
将视频按照弧度制进行旋转,使用-vf rotate=参数,例如:
```bash
#将视频旋转90度
ffmpeg -i in.mp4 -vf rotate=PI/2 out.mp4
```
### 视频(音频)变速
视频变速使用-filter:v setpts=参数,音频变速使用-filter:a atempo=参数,例如:
```bash
#将视频调整为0.5倍速
ffmpeg -i in.mp4 -filter:v setpts=0.5*PTS out.mp4
#音频变速为原先的两倍
ffmpeg -i in.mp3 -filter:a atempo=2.0 out.mp3
```
## 总结
FFmpeg是一个非常厉害的格式转化与压制的软件,虽然没有 GUI,但是只要掌握了几个基本的命令就足以完成绝大多数人的使用需求,Windows、macOS、Linux 全平台试用。而且由于 FFmpeg 是一个开源软件,所以你可以根据你的个性化需求对该软件进行定制(请遵循相关开源协议)。同样如果你有更多的使用需求可以去查阅 FFmpeg 的官方文档选择你所需要的参数。如果对本文中有任何建议或者问题欢迎在下方评论区留言~
---
https://zla.pub/change-apple-id
---
#切换Apple id下载其它国家或地区的APP
> 用他人的apple id登录设备上的icloud是非常危险的行为,不仅会导致联系人、信息、照片等隐私泄漏,还可能导致设备被锁。因此,千万不要用他人的apple id登录icloud!
## 前言
苹果设备允许icloud和app store使用不同的账号登录, 退出icloud账号需要密码,而退出app store则不需要。icloud账号权限非常高,可以远程锁定和抹除登录了同一个账号的设备;app store的账号可用来下载、付费订阅软件,除了付款方式不涉及其它隐私信息。
本教程以ios13.4的iphone 8为例,讲解切换apple id下载其它国家和地区的应用的详细步骤。
## 如何获取美区Apple ID
1. 某宝或其他类似渠道购买。
2. 借用朋友的账号(不建议,Apple ID为个人及其私人的信息,不建议借用)。
3. 自己开通(转区),绑定美区PayPal(可使用大陆开户的visa或master等)后即可进行正常使用(如何开通美区PayPal谷歌一下就有教程)。
4. 自己开通(转区),绑定美国本土开户的银行卡后即可进行正常使用(需要肉身在美国)。
> 开通Apple ID建议使用网页端(强烈建议电脑端)访问[appleid.apple.com](https://appleid.apple.com 'appleid.apple.com')来进行新账号注册以方便填写你的个人信息。付款方式填写将会在你首次在APP Store进行应用下载的时候要求你进行输入(包括账单地址)不需要提前输入。
## 教程部分
1. 打开设置,进入账号设置:
2. 进入“iTunes Store与App Store”(注意,不要点页面最下方的“退出登录”,否则就是登录icloud!)
3. 在新打开的页面,点击最上面的 Apple ID: xxxx@xxx.xxx
4. 在出现的弹框中点击“退出登录”,然后稍等片刻直至蓝色的apple id变为“登录”二字
5. 出现“登录”二字后,请点击“登录”
6. 在新页面中输入你想要切换到的apple id及密码,至此你已经完成APP Store的Apple id账号切换
7. 打开APP Store,搜索你想要下载的APP,下载即可
8. 下载完切换回原apple id仅需重复1-5步即可
## 其他事项
1. Mac上切换apple id下载其它地区应用的操作方式类似,本文不再详述,如有问题请在本页留言;
2. 若你的外区apple id没有你的需求,请自行在淘宝购买充值卡给账号充值再下载,请注意购买礼品卡的区域;
---
https://zla.pub/ios-shadowrocket
---
#iOS下安装 Shadowrocket 的方法
## 前言
Windows、安卓和macOS系统的特点是,只有一人有安装包,就能分享给其他人安装和使用,所以很难封杀。相比之下iOS系统比较麻烦,因为(理论上)必须从应用商店(app store)安装应用。苹果爸爸在应用审核等许多方面比较强势,但在国内也只能乖乖听话,所以国内apple id很难下载到网络代理客户端。
有能力支持正版的请支持正版软件!
## Shadowrocket下载方式
对于iOS系统,获取科学上网客户端有以下几种方式:
### 登录境外apple id下载。境外苹果id可通过如下方式拿到:
a.自行注册;
b.找朋友借;
c.淘宝或其他渠道购买,大概10块钱一个;
d.网上找他人分享的,例如:境外apple id信息汇总 。
e.如果apple id不是你的,请不要登录icloud,务必参考操作教程[切换Apple id下载其它国家或地区的APP](https://www.zla.pub/change-apple-id)
### 安装他人打包好的ipa包
某些网站提供shadowrocket等应用的ipa安装包,下载到电脑后用爱思助手等可以直接安装到手机使用;
### 系统越狱,安装非应用商店的软件
自ios11以来,公开的越狱手段几乎没有,这条路基本不通了;
### 自己编译安装
示例可参考"构建自己的iOS网络代理客户端(编写中)" ,此方法需要mac电脑和开发者账号,并具备一定的技术实力,优点是永远不用担心应用被下架。
## 本站提供的几种方式
### 美区apple id
可以自己寻找途径购买/自己申请。
请注意:美区账号申请需要使用1. 美区PayPal(需要美国固定ip及一个有效地址,可以绑定国内发卡的visa/master 2. 绑定美国发行的visa/master 3. 申请完成后使用美区礼品卡充值的形式购买商品(但需要以上两种方式先激活账户)
~~已无法使用,本站不会再次提供免费公开的账号~~
~~muxia1610473@163.com~~
~~Aa112211~~
仅切换app store的apple id教程请[点击这里](https://www.zla.pub/change-apple-id)
### github大佬提供的在线下载
~~[https://lueyingpro.github.io/shadowrocket/index.html](https://lueyingpro.github.io/shadowrocket/index.html)~~
### ipa包
~~本站不提供~~
---
https://zla.pub/hello-wordpress
---
#WordPress,你好!
## Hexo?
在来到WordPress以前,我的博客使用的是Hexo作为静态页面生成器,主题使用的是[nexmoe主题](https://github.com/nexmoe/hexo-theme-nexmoe),并做了稍微改动,[hexo站](https://www.zl-asica.com)。
## hexo有好处也有坏处
### 好处
1.首先使用hexo的好处就是不用学PHP(WP的基本使用也是不需要的,正常的html和css足够了)
2.其次就是纯静态网站对服务器资源的占用,非常的小,而WP使用的PHP和数据库会对服务器产生一定的压力。
3.WP稳定性也不如纯静态网站,即使在有定期备份的情况下也无法保证全部数据不丢失,而hexo由于都是从本地上传上去的,所以本地至少有一份备份,数据丢失的可能性极低。
4.hexo原生支持markdown语法,wordpress需要安装插件后才能够使用(所有文章都会以这样的形式在两个站点发布)。
### 坏处
1.首先就是文章管理,相对于WP非常的复杂,很不舒服。
2.跟在文章后面的就是评论的管理了,由于网站搭建在境内需要对评论有一定的限制,而hexo我使用的是valine,管理起来还算是比较舒服的,但是还是和WP的没有可比性。
3.如果想要自己定制主题的话,就需要学习一下ejs和style,自己定制一个主题出来。当然在ejs中是可以直接使用html代码的,但是有一个问题就是你的html代码是否能够让主题完美的适配,这是个很大的问题。在wordpress里由于主题非常多,基本上可以找到比较适合自己的主题。如若颜色或某些细节样式觉得不适合,可以使用css对主题进行一定的修饰,使其更加美化。
4.SEO优化非常的复杂,在WP中可以使用各种插件来帮助你做优化,也可以自定义一些meta之类的
5.so on~(欢迎在评论区增加一下)
## 投入Wordpress的怀抱
wordpress吧,现在我使用的主题为[Sakura](https://2heng.xin/theme-sakura/),作者是[Mashiro](https://2heng.xin/),可以点前面的超链接去看看相关的主题作者的博客和主题介绍页面。之后我会对WP的主题进行一定的定制,基本上就是加一些小玩意改改样式,还敬请期待咯~
如果你对hexo和wp有一些和我不一样的见解还欢迎在下方评论区留言哦~~~
---
https://zla.pub/raspberry-pie-qbittorrent-nox
---
#树莓派安装qBittorrent-nox实现种子服务器自动下载上传
## 前言
我买回家树莓派 3B+以后,就一直没有把它充分的利用起来,仅仅做了一个无线打印机还有一个内网访问的网站。这段时间正好接触到了种子,感觉拿来做一个种子的服务器还是不错的。
## 平台介绍
树莓派 3b+、一张插在树莓派上作为系统盘的金士顿 64GB 的 tf 卡、固定的公网 ip、长时间通电以及能够稳定的网速。
系统版本:Raspbian GNU/Linux 10 (buster)
软件:qBittorrent-nox
网络环境:山东联通
## 准备工作
首先你需要固定你的公网 IP,这是为了稳定你的种子下载和上传的速度,并且能够方便你在外网对你的树莓派的种子下载上传进行管理。如果你不知道公网 ip 为何物亦或是不知道如何固定公网 ip 请自行查阅,本文将不多赘述。
要在 Linux 上使用 qBittorrent Web UI,你无需安装完整的 qBittorent 桌面应用程序,有一个基于终端的 qBittorrent 应用程序可用,它被称为 qBittorrent-Nox。
注意:Web UI 功能不仅限于 qBittorrent-mox 应用程序,此功能还可以与传统的 qBittorent Linux 桌面应用程序一起使用,该应用程序可通过 Flapak 安装。
## 安装过程
### 安装 qBittorrent-nox
在树莓派上获取 qBittorrent-nox 非常简单,因为它位于“Main”软件存储库中,但是,由于操作系统的软件更新方式,main 中的版本可能会略微过时,要安装它,请在下面输入 apt-get 命令:
```shell
sudo apt-get install qbittorrent-nox
```
## 使用方法
### 开启 qBittorrent-nox 服务并映射 8070 端口
请直接输入以下命令并回车。其中 8070 为映射的端口,-d 为后台运行
```shell
qbittorrent-nox --webui-port=8070 -d
```
至于为何使用 8070 端口而不使用默认的 8080 端口原因很简单,国内运营商封禁了家庭宽带外网的 8080 端口,故本教程使用 8070 作为了映射的端口以便能够在外网访问,可以自己随意算则端口,本教程后面的 8070 全部更改为你自己的端口即可
### 防火墙放行 8070 端口
在终端输入以下命令,回车运行
```shell
sudo iptables -I INPUT -p tcp --dport 8070 -j ACCEPT
```
如果终端返回**bash: iptables: command not found**请执行以下命令安装 iptables 后再重新执行上述命令
```shell
sudo apt-get update && apt-get install iptables
```
放行端口后请执行下面的命令以保存放行规则
```shell
sudo iptables-save
```
设置完就已经放行了指定的端口,但重启后会失效,下面设置持续生效规则;
安装**iptables-persistent**
```shell
sudo apt-get install iptables-persistent
```
执行下述命令保存规则持续生效
```shell
netfilter-persistent save
netfilter-persistent reload
```
### 将 qBt-nox 加入开机自启项
输入以下命令打开 rc.local 文件以编辑
```shell
sudo nano /etc/rc.local
```
在 exit 0 前加入
```shell
sudo qbittorrent-nox --webui-port=8070 -d
```
输入完成后摁 control+X 再摁一下 Y 再摁一下回车即可完成保存设置完成开机自启
### 打开 qBt-nox 的 webUI 并更改默认账户与密码
打开任意浏览器,在浏览器地址栏内输入 `http://你的公网IP:8070` 回车
默认用户名为 **admin** 密码为 **adminadmin**
点击上方工具栏的 tool-Options-WebUI
在上方可以更改语言为简体中文,更改后会重新进入 qBt 的 WebUI
下方可以更改默认的账户和密码,强烈建议更改,请勿使用默认设置!!!
至此,树莓派安装 qBittorrent-nox 实现种子服务器自动下载上传教程已全部结束,qBittorrent-nox 的使用方式与 PC 端的方法一致。
---
/friends
---
# Friends
## 我的项目
```Links
[
{
"title": "白鲸字幕组",
"link": "https://www.belugasubs.com/",
"img": "https://s2.loli.net/2024/01/17/CGeZhq1FYovxz2p.jpg",
"des": "白鲸字幕组是一个非盈利性质的多语言字幕组。"
},
{
"title": "SuzuBlog",
"link": "https://suzu.zla.app/",
"img": "https://gravatar.zla.app/avatar/me",
"des": "也就是这个站点所使用的博客系统"
},
{
"title": "个人学术网站",
"link": "https://elaraliu.com/",
"img": "https://gravatar.zla.app/avatar/me",
"des": "我的个人学术网站 (英文)"
},
{
"title": "React 工具库",
"link": "https://react.zla.app/",
"img": "https://react.zla.app/logo.png",
"des": "我自己搭建和维护的 React 工具库"
},
{
"title": "Gravatar Worker",
"link": "https://gravatar.zla.app/",
"img": "https://gravatar.zla.app/avatar/me",
"des": "我自己搭建和维护的 Gravatar 镜像 CDN"
}
]
```
## 友情链接
> 下面全是大佬!!!同样也都是朋友~~~
```Links
[
{
"title": "FGHRSH",
"link": "https://www.fghrsh.net/",
"img": "https://gravatar.fghrsh.net/avatar/0c5d77513a08b8c3e38336859b53b027?s=200",
"des": ""
},
{
"title": "DIYGod",
"link": "https://diygod.me/",
"img": "https://avatars.githubusercontent.com/u/8266075?v=4",
"des": ""
},
{
"title": "Keishiの博客",
"link": "https://keishi.cn",
"img": "https://img.keishi.cn/img/2021logo.jpg",
"des": "积极看待,行有所止."
},
{
"title": "折影轻梦",
"link": "https://nexmoe.com/",
"img": "https://cravatar.cn/avatar/c7fd185f8c967dec20c29c75a40b9e09?s=500",
"des": "为热爱战斗着,努力学着变得勇敢"
},
{
"title": "「云华」CloudSino",
"link": "https://cloud.sd.cn/",
"img": "https://cloud.sd.cn/usr/uploads/2025/07/574656472.png",
"des": "愿我的祝福与你同在!"
},
{
"title": "北雁云依",
"link": "https://stblog.penclub.club/",
"img": "https://stblog.penclub.club/%E5%A4%B4%E5%83%8F%E5%9C%86.webp",
"des": "把信拿去吧,你可以假戏真做"
},
{
"title": "CrazyWong",
"link": "https://blog.crazywong.com/",
"img": "https://blog.crazywong.com/img/avatar.png",
"des": "热衷学习,热衷生活"
},
{
"title": "Siren's Playground",
"link": "https://siren-wang.github.io/",
"img": "https://r2.img.zla.app/2024/12/10/4b7617.webp",
"des": "Paint the world colorful."
},
{
"title": "Elykia",
"link": "https://blog.elykia.cn/",
"img": "https://bu.dusays.com/2024/10/25/671b2438203a6.gif",
"des": "致以无暇之人"
},
{
"title": "Ethan",
"link": "https://hanlife02.com",
"img": "https://hanlife02.com/avatar.svg",
"des": "Don't stay awake for too long"
},
{
"title": "Arthals' ink",
"link": "https://arthals.ink/",
"img": "https://cdn.arthals.ink/Arthals.png",
"des": "所见高山远木,阔云流风;所幸岁月盈余,了无拘束。"
},
{
"title": "清羽飞扬",
"link": "https://blog.liushen.fun/",
"img": "https://blog.liushen.fun/info/avatar.ico",
"des": "柳影曳曳,清酒孤灯,扬笔撒墨,心境如霜"
},
{
"title": "Canmi",
"link": "https://arc.canmi.icu/",
"img": "https://avatars.githubusercontent.com/u/72544151?v=4",
"des": "彩笔猫猫"
},
{
"title": "苏卡卡的有底洞",
"link": "https://skk.moe",
"img": "https://cdn.skk.moe/avatar/512x512.png",
"des": "童话只美在真实却从不续写"
},
{
"title": "紗夕里",
"link": "https://blog.ovofish.com",
"img": "https://blog.ovofish.com/img/avatar.webp",
"des": "在你心里-直到永远"
},
{
"title": "白のblog",
"link": "https://blog.mashiro.pro",
"img": "https://blog.mashiro.pro/wp-content/uploads/myavatar.jpg",
"des": "是一只只有一点点技术力的小白捏"
},
{
"title": "城子的小屋",
"link": "https://xcz.me/",
"img": "https://xcz.me/img/avatar.jpg",
"des": "小城子的博客"
},
{
"title": "梦爱吃鱼",
"link": "https://blog.bsgun.cn/",
"img": "https://oss-cdn.bsgun.cn/logo/avatar.256.png",
"des": "但愿日子清静抬头遇见的满是柔情"
},
{
"title": "云萧的咕咕屋",
"link": "https://blog.crrashh.com",
"img": "https://i.cdn.crrashh.com/avatar.jpg",
"des": "以万象之不息,致不息之万象。"
},
{
"title": "Meorion",
"link": "https://blog.meorion.moe",
"img": "https://gravatar.meorion.moe/avatar/me",
"des": "去码头整点薯条🍟"
},
{
"title": "晓雨杂记",
"link": "https://www.lihaoyu.cn",
"img": "https://gravatar.zla.app/avatar/636d113ce37111d08f08faee780ce9b8?s=512",
"des": "也许我们会分别,但我们将永远不会忘记彼此"
},
{
"title": "旺东自留地",
"link": "https://wang618.cn",
"img": "https://wang618.cn/logo.gif",
"des": "爱分享、爱生活、爱摸鱼"
},
{
"title": "echeverra",
"link": "https://echeverra.cn",
"img": "https://echeverra.cn/favicon.jpg",
"des": "let's go, together!"
},
{
"title": "Bensz",
"link": "https://blognas.hwb0307.com",
"img": "https://blognas.hwb0307.com/logo.jpg",
"des": "百代繁华一朝都,谁非过客;千秋明月吹角寒,花是主人。"
},
{
"title": "HKK’s Diary",
"link": "https://ihkk.net",
"img": "https://ihkk.net/wp-content/uploads/avatars/1/1649268643-bpfull.jpg",
"des": "美好回忆中毒症。"
},
{
"title": "Hinai",
"link": "https://blog.woo.moe",
"img": "https://data.woo.moe/img/ico/104491469_0_r.png",
"des": "曇花一現"
},
{
"title": "良的世界",
"link": "https://www.lemonary.cn",
"img": "https://r2.img.zla.app/2024/12/24/8263e6.webp",
"des": "忙点充实,闲点自在"
},
{
"title": "W1ndys小屋",
"link": "https://blog.w1ndys.top/",
"img": "https://avatars.githubusercontent.com/u/109416673?v=4",
"des": "欲戴皇冠,必承其重"
},
{
"title": "微光档案",
"link": "https://bikari.top",
"img": "https://wsrv.nl/?url=github.com/KazariEX.png",
"des": "虚幻的幸福"
},
{
"title": "纸鹿摸鱼处",
"link": "https://blog.zhilu.cyou/",
"img": "https://www.zhilu.cyou/api/avatar.png",
"des": "纸鹿至麓不知路,支炉制露不止漉"
},
{
"title": "Hitokoto - 一言",
"link": "https://hitokoto.cn/",
"img": "https://developer.hitokoto.cn/logo.png",
"des": "萌创团队一句话服务"
},
{
"title": "Pigwan",
"link": "https://pigwan.me/",
"img": "https://pigwan.me/logo.png",
"des": "既然相遇是偶然,又何必在意分开时的突然"
},
{
"title": "极客郎",
"link": "https://blog.jkl.asia",
"img": "https://blog.jkl.asia/img/jkl1.png",
"des": "将科技玩到极致!"
},
{
"title": "ZMTU",
"link": "https://zmtu.com",
"img": "https://zmtu.com/static/images/app/App_Logo.png",
"des": "ACG二次元社区,我们的征途是星辰大海!"
},
{
"title": "世男Sky的个人博客",
"link": "https://www.shinansky.me",
"img": "https://cdn.jsdelivr.net/gh/ShinanSky/imgsavings@refs/heads/main/shinanskyicon.jpg",
"des": "是谁来自山川湖海,却囿于昼夜、厨房与爱?"
},
{
"title": "Codfish Blog",
"link": "https://codfish.top",
"img": "https://codfish.top/favicon/1.jpg",
"des": "🐟🐟🐟"
},
{
"title": "Houliabc’s ink",
"link": "https://houliabc.dpdns.org/",
"img": "https://houlir2.dpdns.org/2025/07/64867dedb8166e9e70d3317d62e7f69f.jpg",
"des": "他说世界上怕就怕“认真”二字"
},
{
"title": "星辰の笔记",
"link": "https://blog.strarry.top/",
"img": "https://blog.strarry.top/avatar.jpg",
"des": "Code | Think | Share | Repeat"
},
{
"title": "THW’s Blog",
"link": "https://blog.tianhw.top",
"img": "https://image.tianhw.top/avatar.webp",
"des": "前途似海,来日方长"
},
{
"title": "Sakun Notebook",
"link": "https://www.sakun.space/",
"img": "https://www.sakun.space/images/avatar.png",
"des": "一个声豚的自我救赎"
},
{
"title": "mccsjs",
"link": "https://mccsjs.eu.org/",
"img": "https://mccsjs.eu.org/img/head.jpg",
"des": "素敵な一日が始まります🎉🎉🎉"
},
{
"title": "Abel",
"link": "https://chen-huaneng.github.io/",
"img": "https://cdn.jsdelivr.net/gh/chen-huaneng/chen-huaneng.github.io@main/static/images/android-chrome-512x512.png",
"des": "梦想是去世界各地旅行!"
},
{
"title": "SatouのBlog",
"link": "https://www.matsusatou.top/",
"img": "https://cdn.jsdelivr.net/gh/SokiSama/picked@main/avatar.jpg",
"des": "彼女の愛は、甘くて痛い"
},
{
"title": "时隐重工",
"link": "https://shiyin.cafe/",
"img": "https://shiyina.com/favicon.ico",
"des": "兴趣使然的未来主义建造者"
},
{
"title": "Hmily",
"link": "https://www.hmily.ren/",
"img": "https://lsc.hmily.ren/image/260.png",
"des": "生活探索日记🌙"
},
{
"title": "Astral Reverie",
"link": "https://montrong.cn",
"img": "https://gravatar.zla.app/avatar/08cbf988db9d9a0eb8facc39241836efe1242bf586d8253d546c87807f66000b?d=initials&name=Montrong",
"des": "如梦幻,如初见。"
},
{
"title": "狱杰",
"link": "https://uegee.com/",
"img": "https://uegee.com/head.jpg",
"des": "曾几何时 稚嫩的小手也拥有了追越我们的坚强"
},
{
"title": "大熊",
"link": "https://halo.aizaibao.cn",
"img": "https://tc.aizaibao.cn/a/2026/04/28/69f0d1289d627.png",
"des": "日常随笔与灵感收集的小角落"
},
{
"title": "A/B’s Blog",
"link": "https://zmoe.com/",
"img": "https://zmoe.com/wp-content/uploads/2026/05/cropped-5273c46b-f6d9-4a1e-b6f5-5b5d47a564ef.png",
"des": "B分之A的自留地"
}
]
```
## 失效友链
> 麻烦出现在下面的朋友在看到后尽快修复或评论区留言更新信息,谢谢!
```Links
[
{
"title": "Aciano",
"link": "https://aciano.top/",
"img": "https://bu.dusays.com/2024/07/15/6694b499da8df.jpg",
"des": "零碎的岛屿总会找到海."
},
{
"title": "摸鱼の客栈",
"link": "https://blog.fwneko.com",
"img": "https://blog.fwneko.com/logo.gif",
"des": "没事摸摸鱼,反正焦虑也解决不了问题"
},
{
"title": "TangShiMei 的小空间",
"link": "https://blog.224418.xyz/",
"img": "https://blog.224418.xyz/img/favicon.ico",
"des": "想和你重新认识一次,从你叫什么开始"
},
{
"title": "XUIOO",
"link": "https://blog.xuioo.com/",
"img": "https://blog.xuioo.com/27c69590279fdc3be2cd7c901e3d07ad.jpg",
"des": "一叶障目,不见泰山;两耳塞豆,不闻雷霆。"
}
]
```
## 添加友链
可以直接在下面评论区,使用如下格式留言,方便我复制粘贴(可以直接使用 markdown 代码块语法更加方便复制)。
特别欢迎使用了我的 SuzuBlog 的朋友们添加友链!
只要我在你的页面中看到了我的链接且你的链接没有问题,我会第一时间添加!
若链接失效/更换,请及时通知我,若失效时间过长,很抱歉会删除。
若想交换友链,请符合以下情况:
1. 网站采取 HTTPS 协议。
2. 网站类型不限,但请不要是违法、违规、不适宜等内容。
3. 网站可以正常访问,并具有一定的内容和更新频率。
4. 非 `.github.io`、`.pages.dev`、`.vercel.app`、`netlify.app`、`.web.app` 等非自有域名(非严格要求,只要更新频率稳定即可)。
5. 头像不要使用 ico,尽量不要用 gif 动图,以免影响页面加载速度和图片自动优化。
```json
{
"title": "ZLA 小站",
"link": "https://zla.pub/",
"img": "https://gravatar.zla.app/avatar/me",
"des": "月亮不抱你,星星会落在你怀里✨🌙"
}
```
为了方便你们添加我的友链,我也提供了我的友链信息:
```plaintext
博主: ZL Asica
名称: ZLA 小站
地址: https://zla.pub/
图标: https://gravatar.zla.app/avatar/me
描述: 月亮不抱你,星星会落在你怀里✨🌙
RSS: https://zla.pub/feed.xml
```
使用 GitHub 作为图床的朋友们请使用 [jsDelivr 转换工具](https://www.jsdelivr.com/github)将图片链接转换为 jsDelivr 的链接。
使用 Gravatar 的朋友们请使用[我自己搭建的 Gravatar 加速站](https://gravatar.zla.app/) 来获取头像链接。
需要更新头像或者链接请留言,有时间会处理的。若没有及时处理请给我发邮件催一下,联系方式 zl at zla dot app。
---
/posts
---
# Posts
Chronological listing of all blog entries
---
/about/anime
---
# Anime
Automatically updated anime watch list from AniList